ResNetとは?AlexNet・VGG16・GoogLeNetの違い

どーも、りけーこっとんです。
「2014年のILSVRCで優勝したのはGoogLeNet?VGG?」「ResNetのスキップ結合って、何がすごいの?」
このような、G検定の画像分類モデルで混乱している方はいないでしょうか?
この記事では、画像認識の中でも「物体識別(画像分類)」のタスクで活躍してきた代表的なモデルを、ILSVRCの年と順位に沿って解説します。
AlexNetからGoogLeNet、VGG、ResNet、そしてその発展形のWide ResNet・DenseNet・SENetまで、「何を工夫したのか」で整理しました。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- ResNetは2015年のILSVRCで優勝したモデル。スキップ結合で152層という深さを実現した
- AlexNetは2012年に優勝し、第3次AIブームのきっかけになった(トロント大学)
- 2014年はGoogLeNet(Inceptionモジュール)が優勝、VGGが2位
- DenseNetは前の層すべてをつなぎ、SENetはチャンネルごとに重みを付けて強調する
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第5章「スキップ結合」、第6章「画像認識」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
- 紙で手元に置きたい方は → G検定カンペの印刷用PDF(無料・A4・15ページ)をダウンロードできます
ResNetとは|スキップ結合で152層を実現
ResNetとは、層を飛び越えて入力を足し合わせる「スキップ結合」を使うことで、とても深い層でも学習できるようにしたCNNです。
2015年のILSVRCで1位を獲得しました。Microsoft Researchのカイミン・ヒー(Kaiming He)らが開発しています。
特徴としてはまず、層の数が圧倒的に増えました。その数なんと152層。
前年までのモデルが20層前後だったので、桁が違いますね。誤り率も3.57%と、人間の認識精度(約5%)を上回ったことで話題になりました。
スキップ結合とは
スキップ結合とは、いくつかの層を飛び越えて、前の層の入力をそのまま後ろの層の出力に足し合わせる構造のことです。
skip connectionとも書かれます。論文の図を見てみましょう。
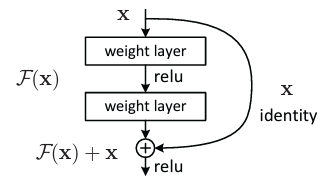
引用:Deep Residual Learning for Image Recognition(arXiv)
この図で右に大きく出ている矢印(x)がスキップ結合です。左側の縦に並んだ層(weight layer×2)は、普通のCNNのイメージですね。
下の「丸で囲まれた+」で、「普通のCNNの結果」と「スキップ結合で運んだ入力」を足し合わせます。このまとまりを残差ブロックと言います。
層を深くすると、誤差逆伝播法で勾配がどんどん小さくなる勾配消失問題が起きて、学習が進まなくなるのでした(誤差逆伝播法と勾配消失問題の記事で解説しています)。
スキップ結合があれば、勾配が近道を通って入力層側までそのまま伝わるので、層を深くしても学習が進むようになったんですね。
weight layerが何かまでは分からなくても良いですが、スキップ結合のイメージは付くようにしておきましょう。
物体識別(画像分類)とILSVRCの歴代モデル
画像認識の3つのタスク
画像認識のタスクは、大きく次の3つに分けられます。
- 物体識別:画像に写っているものが何かを当てる(この記事)
- 物体検出:画像の中のどこに何があるかを、長方形で囲んで当てる(物体検出の記事)
- セグメンテーション:画像の画素1つ1つが何かを当てる(セマンティックセグメンテーションの記事)
物体識別とは
物体識別とは、画像に写っている物体が、事前に決めたラベル(車、猫など)のどれに当たるかを識別するタスクです。
画像分類とも呼ばれます。画像認識と聞いて、このイメージを持つ人が多いのではないでしょうか。
あくまで「事前に決めたラベル」の中から選ぶので、ラベルにない種類は判別できないことに注意してください。
ILSVRCの歴代モデル
ILSVRC(ImageNet Large Scale Visual Recognition Challenge)は、画像分類の精度を競う大会でした(ILSVRCとImageNetの記事で解説しています)。
この大会で優勝したモデルが、何度も話題になってきました。G検定では「何年に何が何位か」が問われるので、表で押さえておきましょう。
| 年 | モデル | 順位 | ポイント |
|---|---|---|---|
| 2012年 | AlexNet | 1位 | ディープラーニングで圧勝。第3次AIブームのきっかけ |
| 2014年 | GoogLeNet | 1位 | Inceptionモジュール、22層 |
| 2014年 | VGG | 2位(位置検出部門は1位) | 3×3の小さいフィルタを重ねて16〜19層 |
| 2015年 | ResNet | 1位 | スキップ結合、152層 |
| 2017年 | SENet | 1位 | チャンネルごとの重み付け(最後のILSVRC) |
2014年は重要なモデルが多く、どれが優勝で何位だったのか混乱しやすいので注意が必要です。
AlexNet
AlexNetとは、2012年のILSVRCでトロント大学のチームが優勝した、ディープラーニングのモデルです。
ジェフリー・ヒントンのチーム(アレックス・クリジェフスキーら)が開発し、名前もアレックスから来ています。
LeNetの構造を発展させて層を深くしたモデルで、2位に10ポイント以上の差をつけて優勝しました。
次のような工夫で、深いネットワークの学習を可能にしたんですね。
- 活性化関数にReLU関数を使って、学習を速くした
- ドロップアウトで過学習を防いだ
- GPUで計算できるように設計した
GPUの性能自体がここ数年で飛躍的に向上したことも、精度が上がった要因の1つですね。
GoogLeNetとInceptionモジュール
GoogLeNetとは、Googleが開発した、Inceptionモジュールを使って22層まで深くしたCNNです。
2014年のILSVRCで1位を獲得しました。名前の「LeNet」の部分は、LeNetへの敬意を込めたものです。
さらに、全結合層の代わりにグローバルアベレージプーリング(GAP)を導入することで、パラメータ数を減らし、過学習を抑えています。
Inceptionモジュールとは
Inceptionモジュールとは、大きさの違う複数の畳み込み(1×1、3×3、5×5)やプーリングを並列に行い、その結果をつなぎ合わせる小さなネットワークのことです。
処理の流れは次の通りです。
- 1つの入力に対して、1×1、3×3、5×5の畳み込みと、プーリングを並列に行う
- それぞれの計算結果をつなぎ合わせて、次の層に渡す
大きさの違うフィルタを同時に使うので、小さな特徴も大きな特徴も一度に捉えられるんですね。
GoogLeNetは、このInceptionモジュールをたくさん重ねて作られています。
InceptionモジュールはGoogLeNetとセットで覚えておきましょう。
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

VGG
VGGとは、オックスフォード大学のチームが開発した、3×3の小さいフィルタの畳み込みを重ねて、16層や19層まで深くしたCNNです。
VGGNetとも呼ばれます。
2014年のILSVRCでは、画像分類でGoogLeNetに次ぐ2位、物体の位置を当てる部門では1位でした。
構造がシンプルで扱いやすいので、今でも転移学習の土台などによく使われています。
VGG16とVGG19
VGG16とは、13層の畳み込み層と3層の全結合層の、合計16層で構成されたVGGです。
16という数字は、重みを持つ層の数を表しているわけですね。
19層のものはVGG19と呼ばれます。
どちらも2014年のILSVRCのモデルなので、GoogLeNetと合わせて覚えておきましょう。
ResNetの発展|Wide ResNet・DenseNet・SENet
Wide ResNet
Wide ResNetとは、ResNetの層を深くする代わりに、各層のフィルタの数(チャンネル数)を増やして幅を広げた改良版です。2016年に発表されました。
ResNetも層を深くすれば精度は上がりますが、層が増えすぎると計算量が増え、数%の精度向上のために数百〜数千層も追加しなければならない、という問題がありました。
そこで、深さの代わりに幅(フィルタ数)を広げたのがWide ResNetです。
フィルタの数が増えるということは、たくさんの種類の特徴を取り出せることになり、浅い層でも高い精度が出せるようになりました。
幅が広いので「Wide」ResNetと覚えましょう。
DenseNet
DenseNetとは、各層の出力を、それより後ろのすべての層の入力としてつなぐCNNです。
2017年に発表されました。何を言っているか分かりにくいですよね。論文の図で見てみましょう。
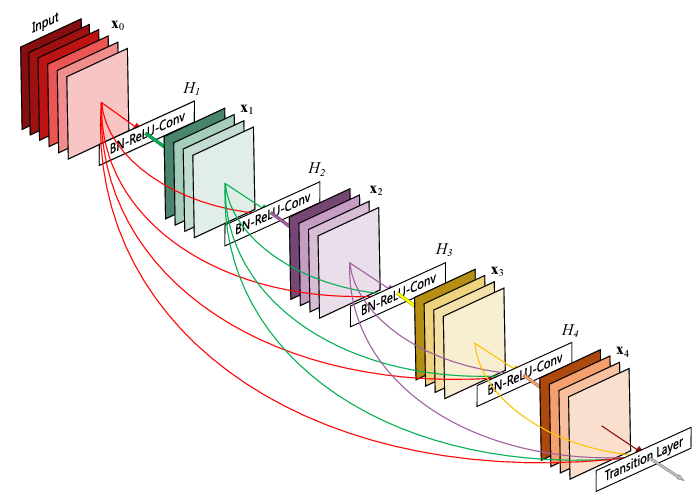
引用:Densely Connected Convolutional Networks(arXiv)
色分けされた四角は特徴マップで、H1、H2…が畳み込みなどの処理です。
例えば赤い矢印を見ると、同じところから後ろのH2・H3・H4にそれぞれ伸びていますよね。
このように、前の層すべての出力を後ろの層につなぐ構造をDense Blockと言います。
ResNetが入力を「足し合わせる」のに対して、DenseNetは前の層の出力を「並べてつなぎ合わせる」のが違いです。
特徴を何度も使い回せるので、少ないパラメータで高い精度が出せます。後ろから前へのつながりはないので注意してください。
SENet
SENetとは、畳み込み層の出力のチャンネル(特徴マップの種類)ごとに重要度を計算して、重みを付けるCNNです。
2017年のILSVRCで1位を獲得しました(ILSVRCはこの年が最後です)。
通常のCNNでは、各チャンネルは均等に次の層へ渡されます。
チャンネルとは、CNNの図でn1やn2に当たる部分で、特徴マップの種類の数のことでしたね。
SENetでは、Squeeze-and-Excitationブロックという小さな仕組みで各チャンネルの重要度を計算し、情報価値の高い特徴マップを強調して、価値の低いものを抑えます。
少しの計算を足すだけで表現力が上がり、精度が向上しました。
G検定での問われ方
この記事のモデルは、「何を工夫したか」と「年・順位」の組み合わせで問われます。
| モデル | 一言でいうと | 覚えるポイント |
|---|---|---|
| AlexNet | ディープラーニングで2012年に圧勝 | トロント大学・ReLU・ドロップアウト・GPU |
| GoogLeNet | Inceptionモジュールで22層 | 2014年1位・GAP |
| VGG | 3×3のフィルタを重ねた16〜19層 | 2014年2位・オックスフォード大学 |
| ResNet | スキップ結合で152層 | 2015年1位・勾配消失を防ぐ |
| Wide ResNet | 深さの代わりに幅を広げた | フィルタ数を増やす |
| DenseNet | 前の層すべての出力を後ろにつなぐ | 足し算ではなくつなぎ合わせ |
| SENet | チャンネルごとに重みを付ける | 2017年1位・最後のILSVRC |
よくある質問
Q. 2014年のILSVRCで優勝したモデルは?
GoogLeNetです。Inceptionモジュールを使った22層のモデルでした。同じ年のVGGは画像分類で2位(位置を当てる部門では1位)です。
Q. ResNetのスキップ結合はなぜ効く?
層を飛び越えて入力をそのまま後ろに足すので、誤差逆伝播法で勾配が近道を通って伝わります。そのため層を深くしても勾配消失問題が起きにくく、152層という深いネットワークでも学習が進むようになりました。
Q. ResNetとDenseNetの違いは?
ResNetはスキップ結合で、前の層の入力を後ろの層の出力に「足し合わせ」ます。DenseNetは、前の層すべての出力を後ろの層の入力として「つなぎ合わせ(並べ)」ます。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- 物体識別:画像に写っているものが、事前に決めたラベルのどれかを当てるタスク
- AlexNet(2012年1位)はReLU・ドロップアウト・GPUで深いCNNを学習し、第3次AIブームのきっかけになった
- GoogLeNet(2014年1位)はInceptionモジュール、VGG(2014年2位)は3×3のフィルタを重ねたシンプルな構造
- ResNet(2015年1位)はスキップ結合で152層を実現し、勾配消失問題を防いだ
- Wide ResNetは幅を広げ、DenseNetは前の層すべてをつなぎ、SENet(2017年1位)はチャンネルに重みを付ける
次回は、画像の「どこに何があるか」まで当てる物体検出のモデル(R-CNN・Faster R-CNN・YOLO・SSD)を物体検出の記事で解説していきます。覚える内容が多いですが、りけーこっとんも頑張ります!
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。