アンサンブル学習とは?バギングとブースティングの違いを解説
どーも、りけーこっとんです。
「バギングとブースティング、並列なのはどっちだっけ?」「ロジスティック回帰って、名前は回帰なのに分類に使うの?」このような、G検定の教師あり学習の後半で迷っている方はいないでしょうか?
この記事では、教師あり学習の第3弾として、複数のモデルを組み合わせるアンサンブル学習(バギング・ブースティング・スタッキング)と、ランダムフォレスト、勾配ブースティング、ロジスティック回帰、ニューラルネットワークを解説します。りけーこっとんも実務で一番よく使うのが、このあたりの手法です。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- アンサンブル学習とは、複数の弱学習器を組み合わせて、1つの強い学習器を作る方法
- バギングは学習器を並列に作って多数決、ブースティングは前の学習器の間違いを直す学習器を順番に作る
- ランダムフォレストは、ブートストラップサンプリングで作った複数の決定木によるバギング
- ロジスティック回帰は、シグモイド関数で確率を出す「分類」の手法
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第3章「機械学習の概要」の「教師あり学習」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
アンサンブル学習とは
アンサンブル学習とは、複数の弱学習器を組み合わせて1つの強学習器を作り、汎化性能を高める方法です。
汎化性能というのは、学習に使っていない未知のデータを予測するときに、どれだけ正解できるかの性能のことです。
弱学習器とは名前の通り、1つだけでは汎化性能があまり良くないモデルのこと。
この弱学習器をたくさん作って、予測精度の高い強学習器を作ろう、というイメージですね。
クイズ番組で、1人で答えるより、何人かで相談して多数決を取ったほうが正解しやすいのと同じ発想です。主な手法には次の3つがあります。
- バギング
- ブースティング
- スタッキング
それぞれ見ていきましょう。
バギングとブースティングの違い
バギングとは
バギングとは、複数のモデル(弱学習器)を並列で作り、それぞれの予測を多数決や平均でまとめて、性能を高める方法です。
弱学習器に入れる学習データは、元のデータから重複ありでサンプリングして、少しずつ違うデータセットを作ります。イメージは次のような感じです。
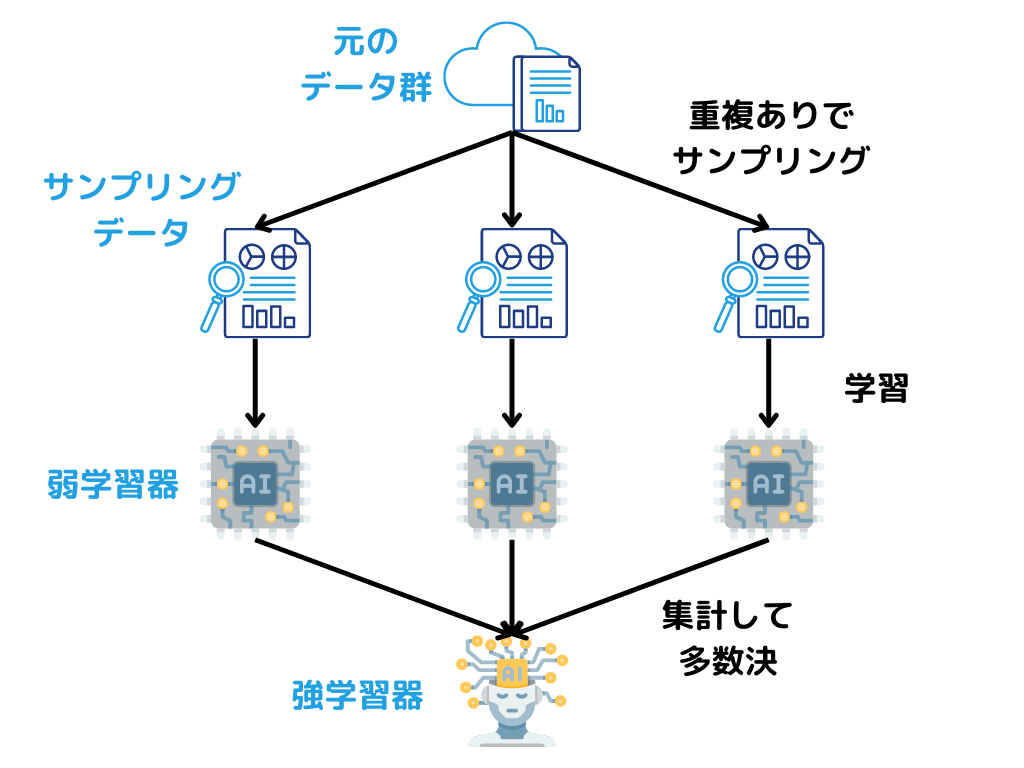
学習器どうしは独立しているので、並列に計算できるのが特徴です。
ブートストラップサンプリング
ブートストラップサンプリングとは、学習データの中から、重複を許してランダムにデータを抜き出す方法のことです。
例えば10個のデータから10回、元に戻しながら1個ずつ選ぶと、同じデータが2回選ばれたり、一度も選ばれないデータが出たりしますよね。
これで「少しずつ違うデータセット」がいくつも作れます。弱学習器に入れるデータのサンプリングの仕方、と言っても良いでしょう。
ランダムフォレストとは
ランダムフォレストとは、決定木を弱学習器にしたバギングの手法です。具体的な手順としては次の通りです。
- ブートストラップサンプリングで、学習データから複数のデータセットを作る
- それぞれのデータセットで決定木を作る(このとき、分岐に使う特徴量もランダムに選ぶ)
- 予測する際は、それぞれの木の出力結果を多数決(回帰なら平均)でまとめて出力する
データだけでなく特徴量もランダムに選ぶことで、似たような木ばかりになるのを防いでいるのがポイントです。決定木そのものは決定木の記事で解説しています。
| メリット | デメリット |
|---|---|
| 予測精度が高い | ハイパーパラメータが多く、調整が面倒 |
| スケールの影響を受けない(正規化が不要) | 特徴量が予測にどう関係しているか理解しにくい |
| カテゴリ変数、連続値ともに特徴量として使える | ― |
使いどころとしては、予測モデルの最有力候補として最初に試す場面や、どの特徴量が重要かを調べる道具として使う場面があるでしょう。
ブースティングとは
ブースティングとは、前の学習器が間違えたところを重点的に学ぶ新しい学習器を、順番に作って足し合わせていく手法のことです。
イメージだと次の図のような感じでしょうか。
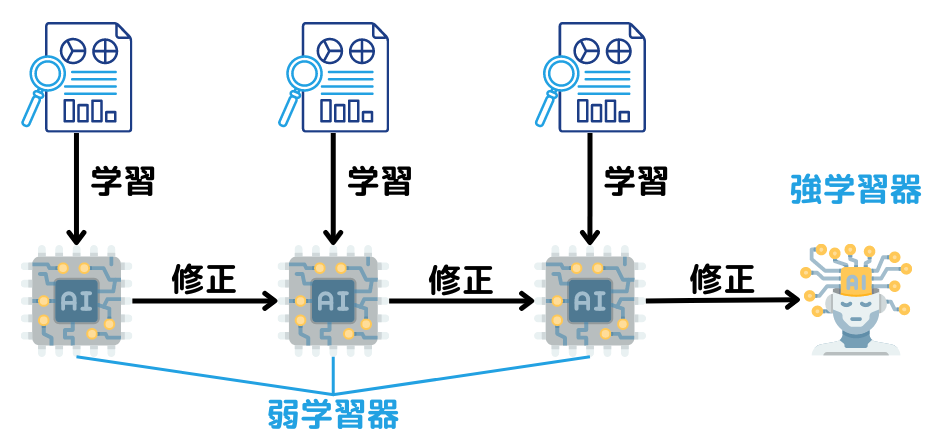
バギングとは違い、前の結果を見ないと次の学習器が作れないので、逐次的(直列)に学習します。
そのぶん時間はかかりますが、精度は高くなりやすいです。ブースティングの代表的な手法は次の2つです。
勾配ブースティング
勾配ブースティングとは、前の学習器の予測と正解との差(残差)を、次の学習器で予測して埋めていく手法のことです。
学習器には様々なモデルを使えますが、決定木を使ったものは勾配ブースティング木とも言います。
実務やデータ分析コンペで大人気のXGBoostやLightGBMは、この勾配ブースティング木を高速にしたものです。
AdaBoost
AdaBoostとは、前の学習器が間違えたデータの重みを大きくして、次の学習器がそのデータを重点的に学ぶようにするブースティングの手法です。
手順は次の通りです。
- 弱学習器を1つ作る
- 間違えたデータの重みを大きくする
- 重みを反映して次の弱学習器を作る
- 2と3を繰り返し、最後に全部の学習器を組み合わせる
スタッキング
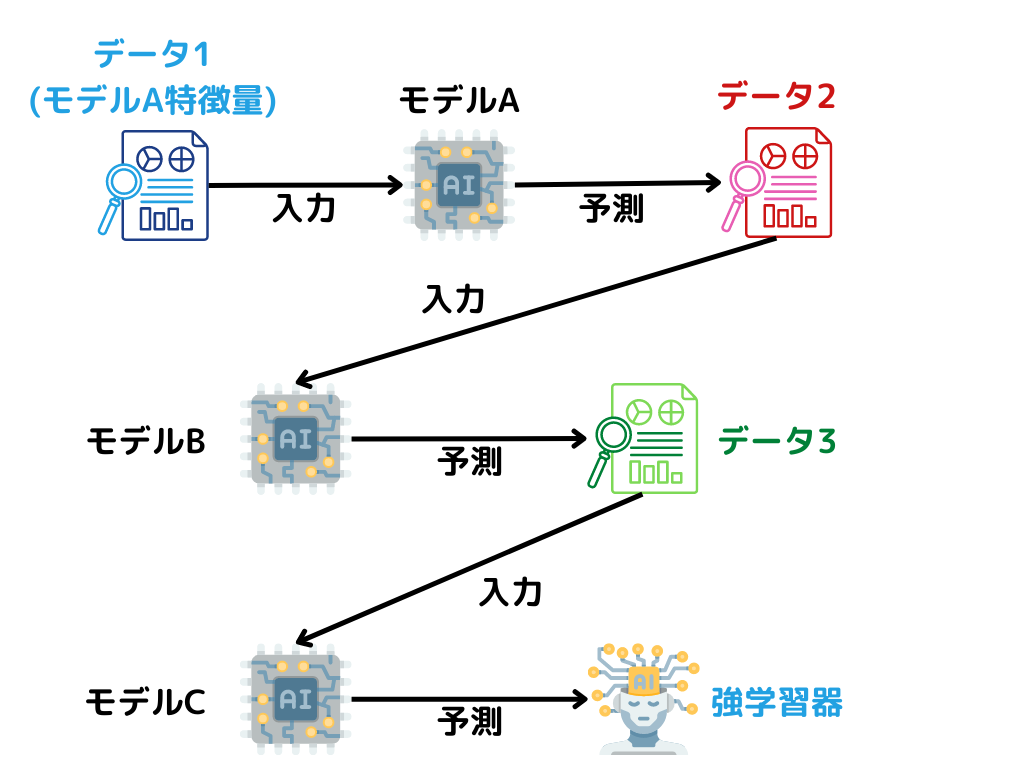
スタッキングとは、あるモデルによる予測値を、新たなモデルの特徴量(メタ特徴量)として使う手法のことです。
この手法では、次のような順で進みます。
- データ1で学習したモデルAで、データ2を予測する
- データ2の予測値を、新たなモデルBの特徴量とする
- モデルBでデータ3を予測する
このようにして、強学習器を作成していきます。イメージとしては次の図のような感じです。
注意したいのは、既に学習に使ったデータセットを、そのまま二度使ってしまうことです。一度使った時点で正解を知っているため、ひどい過学習を起こしてしまいます。
比較表
| 比べるところ | バギング | ブースティング | スタッキング |
|---|---|---|---|
| 学習器の作り方 | 並列(独立に作る) | 直列(前の結果を受けて作る) | 段階的(予測値を次の特徴量にする) |
| 主な狙い | ばらつき(バリアンス)を減らす | 間違い(バイアス)を減らす | 異なるモデルの強みを合わせる |
| 代表例 | ランダムフォレスト | 勾配ブースティング、AdaBoost | ― |
ロジスティック回帰とは
ロジスティック回帰とは、シグモイド関数を使って「あるカテゴリに当てはまる確率」を出し、分類を行う手法です。
名前は回帰でも分類問題に使う、というのがG検定の定番のひっかけです。
二値の分類問題というのは「病気を発症するかしないか」「商品を購入するかしないか」といった、結果が2パターンのみで表せる問題のことです。
2パターン(0か1)しかないので、データを線形回帰しようとすると次のようになります。
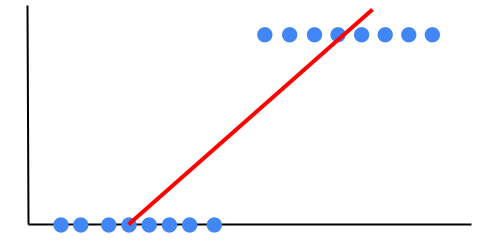
データに対して、上手く線を引けているようには見えませんよね。
そこで、シグモイド関数という関数を入れてみます。すると、
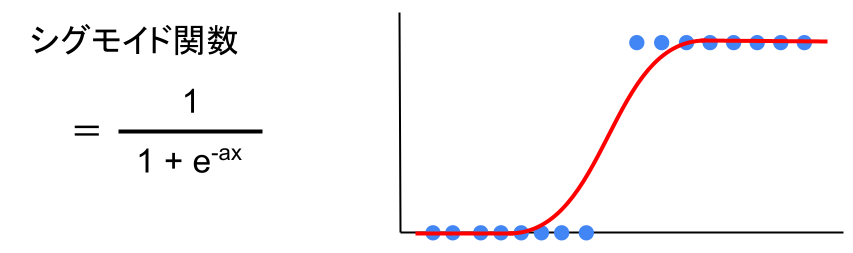
この関数だと、上手く説明できそうです。
シグモイド関数は出力が0から1の間に収まるので、そのまま「購入する確率は0.8」のように確率として読めるんですね。
例えば0.5以上なら「購入する」と分類します。
3つ以上のカテゴリに分けたいときは、シグモイド関数の代わりにソフトマックス関数を使います。
どちらの関数も、ニューラルネットワークの活性化関数として出てきます。
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

ニューラルネットワークのメリット・デメリット
ニューラルネットワークとは、人間の脳の神経回路の仕組みを真似た学習モデル全般のことです。
単純パーセプトロンが基本の考え方で、その層を増やしたものを多層パーセプトロンと言います。
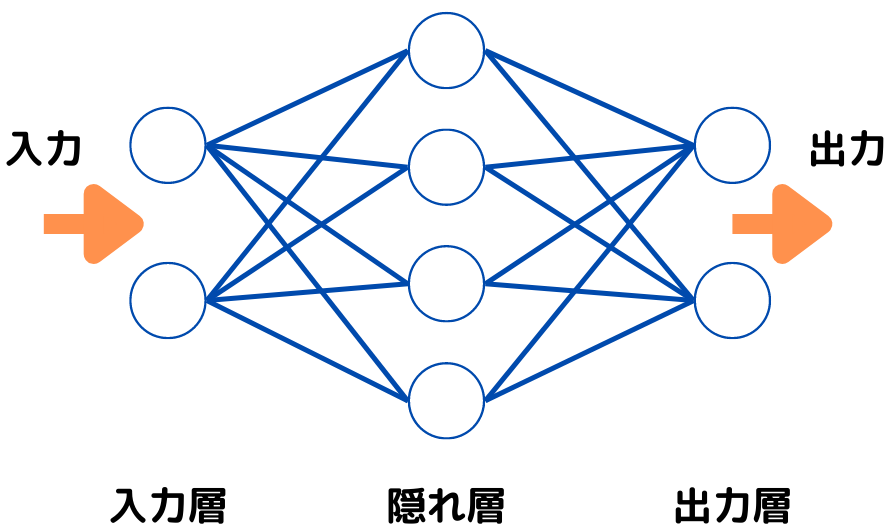
このように隠れ層が増えていますよね。隠れ層を1つだけでなく、たくさんに増やしたものをディープラーニングと言います。単純パーセプトロン、多層パーセプトロン、ディープラーニングは、全て人間の神経回路の構造を参考にしているので、これらを総称して「ニューラルネットワーク」と言うんです。
| メリット | デメリット |
|---|---|
| モデルの表現力が高く、性能が高い | ハイパーパラメータが多い |
| 確率的勾配降下法(SGD)で、データを追加しながら少しずつ学習し直せる | 解釈可能性が低い(なぜその答えか分かりにくい) |
使いどころとしては、精度を重視したいときや、画像処理・自然言語処理のような分野です。まさに現在、流行中の分野に使われていることが分かりますね。
なお、学習済みのネットワークから影響の小さい接続を削ってパラメータを減らすプルーニング(枝刈り)という方法もあります。モデルを軽くする手法として、第6章の「モデルの軽量化」で問われます。
G検定での問われ方
この記事の手法は「並列か直列か」「何を弱学習器にしているか」がよく問われます。
| 用語 | 一言でいうと | 覚えるポイント |
|---|---|---|
| アンサンブル学習 | 複数の弱学習器で強学習器を作る | 汎化性能を高める |
| バギング | 並列に作って多数決・平均 | ばらつきを減らす |
| ブートストラップサンプリング | 重複を許してランダムに抜き出す | バギングのデータの作り方 |
| ランダムフォレスト | 決定木のバギング | 特徴量もランダムに選ぶ |
| ブースティング | 間違いを直す学習器を順番に作る | 直列・精度が高くなりやすい |
| 勾配ブースティング | 残差を次の学習器で埋める | XGBoost・LightGBM |
| ロジスティック回帰 | シグモイド関数で確率を出す | 名前は回帰でも分類 |
よくある質問
Q. バギングとブースティング、並列なのはどちら?
バギングです。バギングは学習器どうしが独立しているので並列に作れます。ブースティングは前の学習器の間違いを見て次の学習器を作るので、順番(直列)に学習します。
Q. ランダムフォレストはなぜ過学習しにくい?
ブートストラップサンプリングで少しずつ違うデータを使い、さらに分岐に使う特徴量もランダムに選ぶので、似ていない決定木がたくさんできます。その多数決を取ることで、1本の決定木の極端な予測が打ち消されるためです。
Q. ロジスティック回帰はなぜ分類なのに回帰と呼ぶ?
もともと統計学で、確率(0から1の連続値)を回帰分析の形で求める方法として生まれたためです。求めた確率に基準(0.5など)を設けて分類に使うので、G検定では分類の手法として扱います。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- アンサンブル学習:複数の弱学習器を組み合わせて汎化性能を高める
- バギングは並列、ブースティングは直列。スタッキングは予測値を次のモデルの特徴量にする
- ランダムフォレスト:ブートストラップサンプリングと特徴量のランダム選択による決定木のバギング
- 勾配ブースティング:残差を次の学習器で埋めていく。XGBoostやLightGBMが有名
- ロジスティック回帰:シグモイド関数で確率を出す分類の手法
今回で教師あり学習は終了です。
次回は、正解データを使わずにデータの構造を見つける「教師なし学習」から、主成分分析などの次元削減を主成分分析の記事で解説していきます。一緒に頑張っていきましょう!
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。