ハイパーパラメータとは?鞍点・局所最適解とグリッドサーチ
どーも、りけーこっとんです。
「鞍点って、どんな形の点なの?」「エポックとイテレーション、どっちが何の回数?」このような、G検定の学習の最適化の範囲で迷っている方はいないでしょうか?
この記事では、ハイパーパラメータとその探し方(グリッドサーチ・ランダムサーチ)、学習の回数を表すエポックとイテレーション、学習がうまく進まなくなる原因(局所最適解・鞍点・プラトー)、データの使い方(バッチ学習・ミニバッチ学習・オンライン学習)、そして実務で一番怖いデータリーケージを解説します。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- ハイパーパラメータとは、学習率や層の数のように、学習の前に分析者が自分で決める設定値
- グリッドサーチは候補の組み合わせを全部試し、ランダムサーチは範囲の中からランダムに選んで試す
- 局所最適解は「その周りでは一番低いが、全体では一番ではない点」、鞍点は「ある方向では谷、別の方向では山」に見える点
- ミニバッチ学習は訓練データを小分けにして、小分けごとにパラメータを更新する方法
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第4章「最適化手法」、第7章「データの収集・加工・分析・学習」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
- 紙で手元に置きたい方は → G検定カンペの印刷用PDF(無料・A4・15ページ)をダウンロードできます
ハイパーパラメータとは
ハイパーパラメータとは、学習率や隠れ層の数のように、学習を始める前に分析者が自分で決める学習モデルの設定値のことです。
これに対して、ニューラルネットワークの重みやバイアスのように、学習によって自動で決まる値はパラメータと呼ばれます。
| 種類 | 誰が決めるか | 例 |
|---|---|---|
| パラメータ | 学習によって自動で決まる | 重み、バイアス |
| ハイパーパラメータ | 学習の前に分析者が決める | 学習率、隠れ層の数、ミニバッチのサイズ、エポック数、正則化の強さ |
学習がうまく進むハイパーパラメータを決められるかどうかは、分析者の腕次第ということになります。
とはいえ、何も方法がないのでは困りますよね。そこで、ハイパーパラメータを探す次の方法があります。
グリッドサーチとランダムサーチ
グリッドサーチとは
グリッドサーチとは、ハイパーパラメータの候補をいくつか指定し、そのすべての組み合わせを試して、最も精度が高いものを選ぶ方法です。
具体的な手順は次の通りです。
- それぞれのハイパーパラメータについて、候補をいくつか(1つにつき3つ程度)指定する
- 指定した候補の、すべての組み合わせを作る
- 組み合わせごとに、交差検証で精度を測る
- 最も精度が高い組み合わせを使う
実際にPythonで使うときは、1の候補を書けば、あとは自動で計算してくれます。
網羅的に調べられるのが長所ですが、組み合わせが増えすぎると計算に時間がかかりすぎるので注意が必要です。
例えば候補が3つのハイパーパラメータが5種類あると、3の5乗で243通りも試すことになります。
ランダムサーチとは
ランダムサーチとは、ハイパーパラメータの範囲を指定し、その範囲の中からランダムに選んだ組み合わせを試して、最も精度が高いものを選ぶ方法です。
具体的な手順は次の通りです。
- それぞれのハイパーパラメータの範囲を指定する
- 指定した範囲の中で、ランダムな組み合わせを選ぶ
- 選んだ組み合わせで、交差検証で精度を測る
- 最も精度が高いものを使う
グリッドサーチは具体的な値を指定したのに対して、ランダムサーチは範囲を指定するのが違いですね。
試す回数を自分で決められるので、ハイパーパラメータが多いときは、グリッドサーチより少ない回数で良い組み合わせを見つけやすいと言われています。
交差検証については交差検証の記事で解説しています。
エポックとイテレーション
イテレーションとは
イテレーションとは、ニューラルネットワークのパラメータを更新した回数のことです。
ディープラーニングでは、勾配降下法で何回もパラメータの更新を繰り返します。
この回数をイテレーションと言うわけですね。
エポックとは
エポックとは、訓練データ全体を何周学習させたかの回数のことです。
パラメータの数が多いので、訓練データを1周学習させただけでは、精度はあまり良くなりません。
そこで、同じ訓練データを何周も繰り返して学習させます。
2つの関係は次のように考えると分かりやすいです。例えば訓練データが1,000件で、100件ずつに小分けして(ミニバッチ)更新するとします。
- 1エポック(訓練データを1周)で、パラメータの更新は10回
- つまり1エポック=データ数÷ミニバッチのサイズのイテレーション
エポック数を増やしすぎると過学習につながるので、検証データの誤差を見ながら止める早期終了がよく使われます(過学習とドロップアウトの記事で解説しています)。
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

学習が止まる原因|局所最適解・大域最適解・鞍点・プラトー
勾配降下法では「勾配が0になる点が最小値」と説明しましたが、実はそうでないこともあります。
局所最適解と大域最適解
局所最適解とは、その周りの中では誤差が一番小さく勾配が0になるものの、全体で見ると最小ではない点のことです。
大域最適解とは、勾配が0で、かつ全体で見て誤差が最小になる点のことです。
どんなグラフかというと、次の図のようなイメージです。
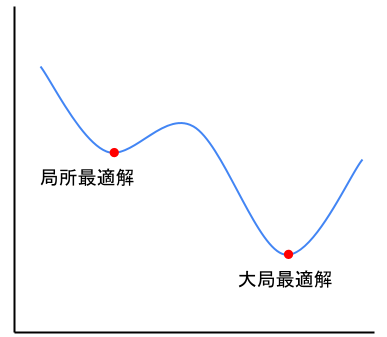
このようなグラフだと、勾配が0になっている谷が2つありますね。
勾配降下法が目指すのは大域最適解ですが、関数が複雑になるほど、浅い谷(局所最適解)にはまってしまう可能性があります。
ボールが手前の小さなくぼみで止まってしまうイメージですね。そこで、学習率などのハイパーパラメータの調整や、モーメンタムのような勢いを付ける工夫が重要になります。
鞍点とは
鞍点とは、ある方向から見ると極小値(谷の底)、別の方向から見ると極大値(山の頂上)に見える点のことです。
極大値・極小値は、どちらも勾配が0になる点です。
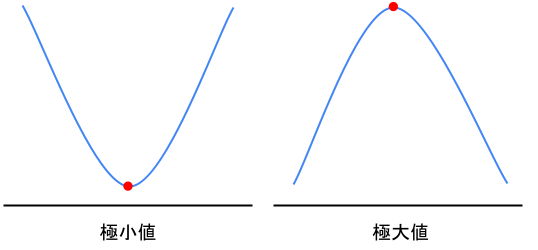
鞍点は、馬に乗せる鞍(くら)のような形をしています。前後の方向に見ると谷の底ですが、左右の方向に見ると山の頂上になっているんですね。図にすると次のようなグラフです。

鞍点でも勾配は0になるので、勾配降下法では最小値と区別がつかず、ここにはまると抜け出すのが難しく、学習が進みにくくなってしまいます。
ディープラーニングのようにパラメータ(次元)が多いと、局所最適解よりも鞍点の方がたくさん出てくると言われています。
プラトーとは
プラトーとは、鞍点などの勾配がほぼ0の平らな場所に入って、学習が進まなくなっている状態のことです。
プラトーは「高原(平らな台地)」という意味です。
この状態になると、勾配がほとんどないのでパラメータがなかなか更新されず、学習が終わらなくなってしまいます。
鞍点や局所最適解がある関数では起こりやすいですね。
バッチ学習・ミニバッチ学習・オンライン学習
ここからは、パラメータを更新するときに、訓練データをどう使うかを解説していきます。
バッチ学習とは
バッチ学習とは、すべての訓練データを使って勾配を計算し、パラメータを更新する方法です。
一番単純で、手元のデータを全部使って安定した更新ができます。
しかし、すべてのデータを使うとなると、1回の更新の計算量が膨大になりすぎてしまいます。
最近ブームの画像処理や音声認識などは、その典型ですね。最急降下法がこのやり方です。
ミニバッチ学習とは
ミニバッチ学習とは、訓練データを小分けにした一部(ミニバッチ)ごとに勾配を計算し、パラメータを更新する方法です。
例えば訓練データを32件ずつのグループに分け、ランダムに選んだグループで更新を繰り返します。
全訓練データを一度に使わないので計算量が少なく済み、更新の回数も稼げます。
バッチ学習とオンライン学習の中間で、今のディープラーニングでは最もよく使われる方法です。
オンライン学習とは
オンライン学習とは、訓練データを1件ずつ使って、そのたびにパラメータを更新する方法です。
1件ごとに更新するので、新しいデータが次々に入ってくる場面(ニュースの推薦など)でも、そのつど学習し直せるのが強みです。
ただし、1件ごとの更新は向きがぶれやすく、学習が不安定になりがちです。
| 方法 | 1回の更新に使うデータ | 長所 | 短所 |
|---|---|---|---|
| バッチ学習 | すべて | 更新が安定する | 計算量が膨大 |
| ミニバッチ学習 | 小分けにした一部 | 速さと安定のバランスが良い | ミニバッチのサイズを決める必要がある |
| オンライン学習 | 1件ずつ | 新しいデータにすぐ対応できる | 更新が不安定になりやすい |
データリーケージとは
データリーケージとは、モデルを学習するときに、本来その時点では知らないはずの情報を、うっかり使ってしまうことです。
リーケージは「漏れ」という意味です。
時系列データなどを扱うときに、特に注意したい現象です。
例えば、前年までの成績から今年の成績を予測するモデルを作っていたとしますね。
ここで、2012年の成績を予測するために、2015年のデータまで学習に使ってしまったらどうでしょう。
未来の答えを見ながら予想しているようなものなので、学習中は精度が高く見えても、実際に使うと精度が出ないモデルになってしまいます。
ほかにも、「解約したかどうか」を予測したいのに、解約後にしか記録されない「解約理由」を特徴量に入れてしまう、といったケースもあります。
りけーこっとんも実務で一番気を付けているのがここで、「予測に使うデータは、その時点で本当に手に入るものか」という視点が重要ですね。
よくある質問
Q. パラメータとハイパーパラメータの違いは?
パラメータは、重みやバイアスのように学習によって自動で決まる値です。
ハイパーパラメータは、学習率や隠れ層の数のように、学習を始める前に分析者が決める設定値です。
Q. 鞍点とは簡単に言うと?
ある方向から見ると谷の底、別の方向から見ると山の頂上になっている点です。
馬の鞍のような形で、勾配が0になるため、勾配降下法がここで止まって学習が進みにくくなることがあります。
Q. データリーケージの例は?
過去のデータから将来を予測するモデルで、学習に未来のデータを混ぜてしまうケースが代表例です。
ほかにも、予測したい結果が起きた後にしか分からない情報を特徴量に入れてしまうケースがあります。学習中の精度は高く見えても、実際には使えないモデルになります。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- ハイパーパラメータ:学習の前に分析者が決める設定値。グリッドサーチ(全組み合わせ)とランダムサーチ(範囲からランダム)で探す
- イテレーションはパラメータの更新回数、エポックは訓練データを何周したかの回数
- 局所最適解は全体では最小でない谷、鞍点はある方向では谷・別の方向では山の点、プラトーは平らな場所で学習が止まる状態
- バッチ学習は全データ、ミニバッチ学習は小分け、オンライン学習は1件ずつで更新する
- データリーケージ:本来知らないはずの情報を学習に使ってしまうこと
次回は、ディープラーニングで一番の悩みの種「過学習」の対策として、ドロップアウト・早期終了・バッチ正規化などを過学習とドロップアウトの記事で解説していきます。覚える内容が多いですが、りけーこっとんも頑張ります!
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。