過学習とは?原因と対策(ドロップアウト・早期終了)をG検定向けに解説
どーも、りけーこっとんです。
「ドロップアウトって、なぜノードを消すと精度が上がるの?」「正規化と正則化と標準化、言葉が似すぎていて区別できない」このような、G検定の学習テクニックの範囲で混乱している方はいないでしょうか?
この記事では、ディープラーニングで一番の悩みの種である「過学習」と、その対策(ドロップアウト・早期終了・正則化)を解説します。
さらに、学習を安定させる正規化層(バッチ正規化など4種類)、データの前処理(標準化・白色化)、ノーフリーランチの定理と二重降下現象までまとめました。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- 過学習とは、訓練データを学習しすぎて、未知のデータへの予測精度が悪くなる現象
- ドロップアウトは学習のたびに隠れ層のノードをランダムに無効にして、疑似的にアンサンブル学習をする方法
- 早期終了は、検証データの誤差が上がり始めたところで学習を止める方法
- 正規化層は、何を単位に正規化するかで4種類(バッチ・レイヤー・インスタンス・グループ)に分かれる
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第4章「正則化」「最適化手法」、第5章「正規化層」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
- 紙で手元に置きたい方は → G検定カンペの印刷用PDF(無料・A4・15ページ)をダウンロードできます
過学習とは|訓練データを覚えすぎた状態
過学習とは、学習を行いすぎて、訓練データへの当てはまりが異常に良くなる一方、未知のデータへの予測精度が悪くなってしまう現象のことです。
オーバーフィッティングとも呼ばれます。
テスト前に過去問の答えだけ丸暗記して、本番で少し形を変えられると解けなくなる、あの状態ですね。
ディープラーニングはパラメータの数がとても多いので、過学習を起こしやすいモデルです。過学習が起こりやすい原因には、次のようなものがあります。
- 訓練データの数が少ない
- モデルが複雑すぎる(パラメータが多すぎる)
- 学習を長く続けすぎる
過学習の見分け方(訓練誤差と検証誤差)
過学習は、訓練データと未知のデータ(検証データ)の誤差をグラフにすると、一目で分かります。
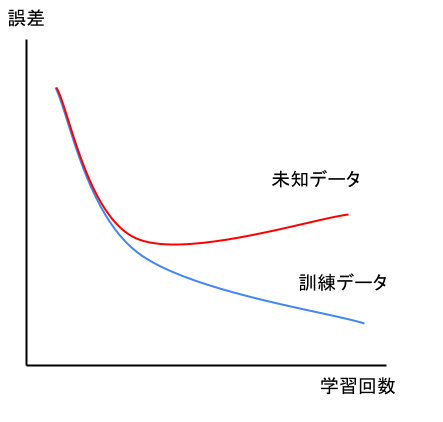
学習を進めると、訓練データに対する誤差(訓練誤差)は下がり続けます。
ところが、ある点を通り過ぎると、未知のデータに対する誤差は逆に大きくなっていきます。
このように2つの誤差の差が開き始めたところが、過学習が始まった瞬間ですね。
訓練誤差と汎化誤差の考え方は交差検証と汎化性能の記事で解説しています。
過学習の対策
ドロップアウトとは
ドロップアウトとは、学習のたびに隠れ層のノードをランダムに選んで無効にする(出力を0にする)ことで、過学習を防ぐ方法です。
2012年にジェフリー・ヒントンらが提案しました。イメージは次のような感じです。
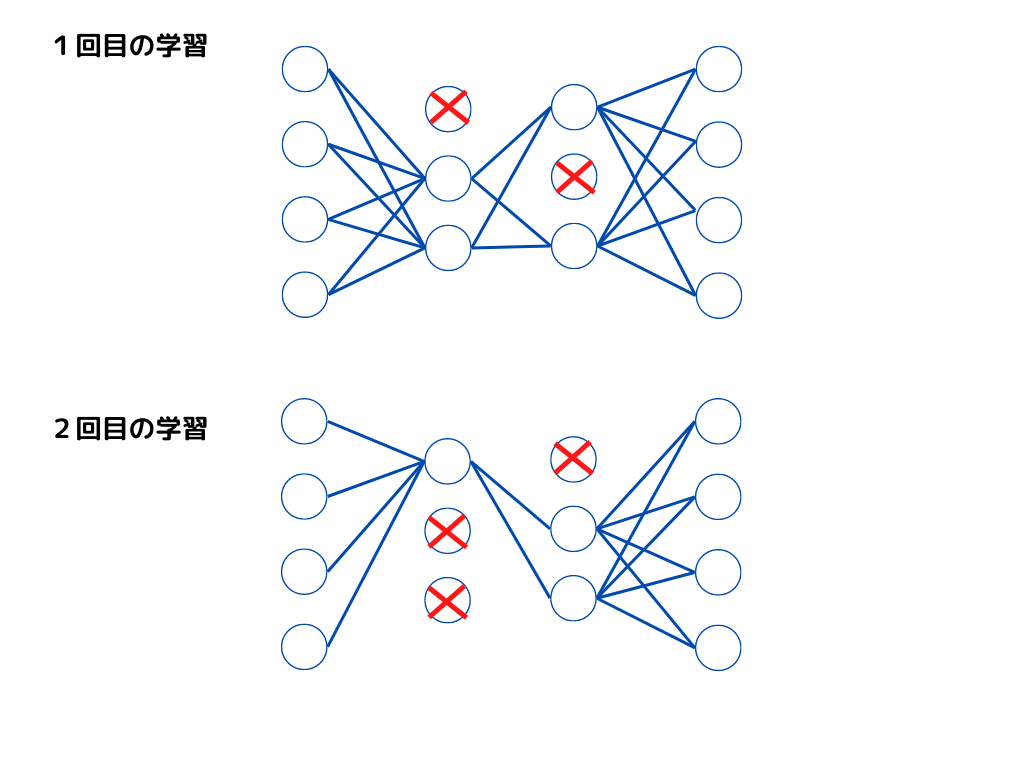
このように、1回目と2回目では違うノードが削除されていますよね。
つまり1回目と2回目では、違う形のニューラルネットワークで学習していることになります。
そのため、特定のノードに頼りすぎることがなくなり、疑似的にアンサンブル学習をしているのと同じ効果が得られるんですね。
アンサンブル学習(複数の弱い学習器で1つの強い学習器を作る方法)はアンサンブル学習の記事で解説しています。
なお、ノードを無効にするのは学習のときだけで、予測するときはすべてのノードを使います。
早期終了とは
早期終了とは、学習を続けていく中で、検証データの誤差が上がり始めたところで学習を止める方法です。
Early Stoppingとも呼ばれます。
先ほどのグラフで言えば、未知のデータの誤差が一番低いところで止める、ということですね。
過学習を起こす前に早めに学習をやめておけば、最良とは言えなくても、ある程度の精度のモデルを得られます。
シンプルで効果が大きいので、実務でもよく使われます。
データ拡張と正則化
ほかにも、過学習の対策には次のようなものがあります。
- データ拡張:画像を回転させたり反転させたりして、訓練データを水増しする(データ拡張の記事で解説しています)
- 正則化:誤差関数にペナルティ(正則化項)を加えて、重みが大きくなりすぎないようにする(L1正則化・L2正則化は正則化の記事で解説しています)
「正則化」と「正規化」は言葉が似ているので、しっかり区別しておきましょう。
正則化は過学習を防ぐためにペナルティを足すこと、正規化はデータのスケールをそろえることです。
正規化層
正規化層とは、ニューラルネットワークの層の途中で、データのばらつき(平均と分散)をそろえる処理を行う層のことです。
層を重ねるごとに、各層に入ってくるデータの分布が偏りやすくなり、学習が不安定になってしまいます。
そこで、各層で伝わってきたデータを正規化して偏りをなくすことで、学習を安定させるんですね。
何を単位に正規化するかで、次の4種類に分かれます。
バッチ正規化とは
バッチ正規化とは、ミニバッチごとに、各チャンネル(特徴)のデータの平均を0、分散を1になるように正規化する方法です。
2015年に提案されました。イメージは次のような感じです。
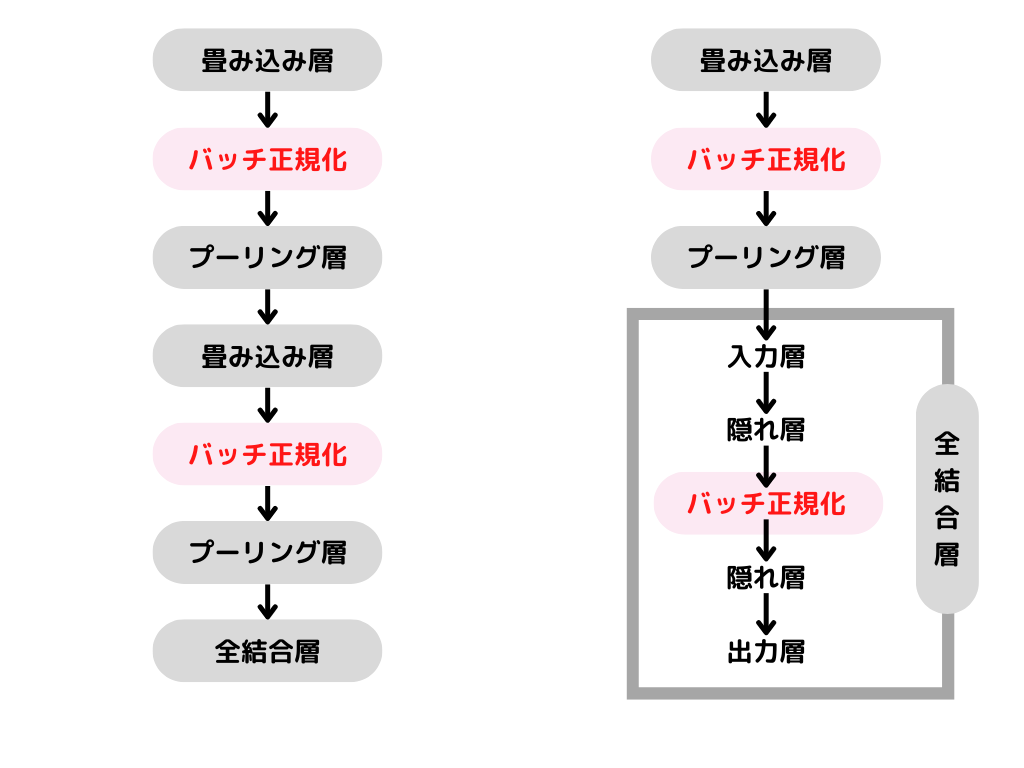
厳密にはもう少し細かいのですが、こんな感じのイメージで覚えておくと良いかと思います。バッチ正規化の特徴は次の3つです。
- 学習の進み方が速くなる
- 重みの初期値に左右されにくくなる
- 過学習を抑える効果もある
ただし、ミニバッチのサイズが小さいと、平均や分散がうまく計算できず効果が落ちるのが弱点です。
レイヤー正規化とは
レイヤー正規化とは、ミニバッチではなく、1つのデータごとに、その層のすべての特徴をまとめて正規化する方法です。
ミニバッチのサイズに左右されないので、文章のように長さがバラバラなデータを扱うRNNやTransformerでよく使われます。
インスタンス正規化とグループ正規化
インスタンス正規化とは、1つのデータの、1つのチャンネルごとに正規化する方法です。
画像の色味やコントラストのような「スタイル」をそろえる効果があるので、画像のスタイル変換などで使われます。
グループ正規化とは、1つのデータのチャンネルをいくつかのグループに分けて、グループごとに正規化する方法です。
レイヤー正規化とインスタンス正規化の中間の考え方で、ミニバッチが小さくても使えるのが特徴です。
| 正規化 | 何を単位に正規化するか | 主な使いどころ |
|---|---|---|
| バッチ正規化 | ミニバッチ全体で、チャンネルごと | CNNなど(ミニバッチが大きいとき) |
| レイヤー正規化 | 1つのデータで、全チャンネルまとめて | RNN、Transformer |
| インスタンス正規化 | 1つのデータで、1チャンネルごと | 画像のスタイル変換 |
| グループ正規化 | 1つのデータで、チャンネルのグループごと | ミニバッチが小さいとき |
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

標準化・正規化・白色化(データの前処理)
正規化層とは別に、学習の前にデータを整える前処理もあります。
りけーこっとんも最初は「正規化」「標準化」「正則化」が紛らわしすぎて苦労しました。
標準化
標準化とは、元データの平均を0、標準偏差を1にそろえることです。計算は「(各データ−平均)÷標準偏差」です。
標準化のことを正規化と呼ぶこともあるので、問題文を読むときに気を付けましょう。
正規化
単純に正規化と言った場合は、データを0から1の範囲に収めることを指すことが多いです。
計算は「(各データ−最小値)÷(最大値−最小値)」です。スケールをそろえるという目的は標準化と同じですが、行う操作が違う点に注意してください。
白色化
白色化とは、変数同士の相関をなくし(無相関化)、さらに各変数の平均を0、分散を1にそろえる前処理のことです。
具体的な手順は次の通りです。
- 無相関化する(変数同士の共分散を0にする)
- 各変数の平均を0にする(それぞれのデータから平均値を引く)
- 各変数の分散を1にする(標準偏差で割る)
標準化との違いは、変数同士の相関までなくす点です。
平滑化
平滑化とは、ほかのデータから大きく外れた値を平均化したり取り除いたりして、全体的に突出のない状態にすることです。
画像に対して行うと、ノイズを除去できます。
ノーフリーランチの定理とは
ノーフリーランチの定理とは、あらゆる問題に対して万能に性能が良いアルゴリズムは存在しない、という定理のことです。
1997年にデビッド・ウォルパートとウィリアム・マクレディが提唱しました。
ある問題で優れた性能を発揮するアルゴリズムも、別の問題では性能が下がってしまいます。
「タダ飯(フリーランチ)はない」、つまり楽して何にでも効く方法はない、ということですね。
実務でも、問題に合わせていくつかの手法を試して比べるのはこのためです。
感覚的にも理解しやすい定理なのではないでしょうか。
二重降下現象とは
二重降下現象とは、モデルを大きくしたり学習を長く続けたりすると、誤差がいったん下がって上がった後、もう一度下がっていく現象のことです。
言い換えると、予測精度は最初は向上しますが、ある程度を越えると悪化し始めます(過学習のような状態)。
しかし、さらにモデルの大きさや学習時間を増やしていくと、予測精度が再び向上する、ということですね。グラフにしてみると、次のような形になります。
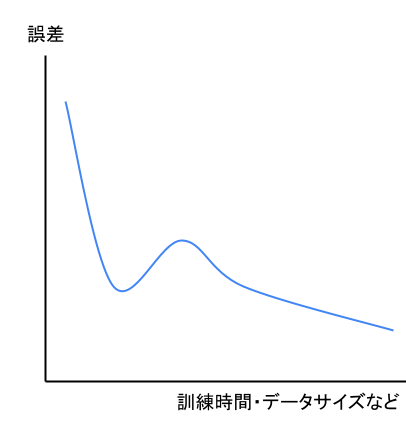
「モデルは大きすぎると過学習する」という従来の常識とは違う結果なので、注目されました。なぜこの現象が起こるのかは、まだ完全には解明されていないようです。
G検定での問われ方
この記事の用語は、似た言葉の区別がよく問われます。
| 用語 | 一言でいうと | 覚えるポイント |
|---|---|---|
| 過学習 | 訓練データに合わせすぎて未知のデータに弱くなる | 訓練誤差は低いのに汎化誤差が高い |
| ドロップアウト | ノードをランダムに無効にして学習 | 疑似的なアンサンブル学習 |
| 早期終了 | 検証誤差が上がり始めたら止める | Early Stopping |
| バッチ正規化 | ミニバッチごとに正規化 | 2015年・学習が速く安定 |
| 白色化 | 無相関化してから平均0・分散1にする | 標準化との違いは相関をなくすこと |
| ノーフリーランチの定理 | 万能なアルゴリズムはない | ウォルパートとマクレディ |
| 二重降下現象 | 誤差が下がって上がって、また下がる | 大きいモデルで再び精度が上がる |
よくある質問
Q. 過学習と未学習の違いは?
過学習は、訓練データに合わせすぎて未知のデータへの精度が悪い状態です(訓練誤差は小さいのに汎化誤差が大きい)。
未学習は、学習が足りず訓練データにさえ当てはまっていない状態です(訓練誤差も汎化誤差も大きい)。
Q. ドロップアウトはなぜ効く?
学習のたびにランダムにノードを無効にするので、特定のノードに頼りすぎることがなくなります。
毎回少しずつ違う形のネットワークで学習することになり、疑似的に複数のモデルを組み合わせるアンサンブル学習と同じ効果が得られるためです。
Q. ノーフリーランチ定理とは?
あらゆる問題に対して万能に性能が良いアルゴリズムは存在しない、という定理です。ある問題で強い手法も別の問題では弱くなるので、問題に合わせて手法を選ぶ必要があります。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- 過学習:訓練データに合わせすぎて、未知のデータへの精度が悪くなる現象
- 対策:ドロップアウト(ノードをランダムに無効化)、早期終了(検証誤差が上がったら止める)、データ拡張、正則化
- 正規化層:バッチ正規化(ミニバッチ単位)、レイヤー正規化(データ単位)、インスタンス正規化、グループ正規化
- 白色化:無相関化してから平均0・分散1にそろえる。標準化は平均0・標準偏差1
- ノーフリーランチの定理は万能なアルゴリズムはないこと、二重降下現象は誤差が再び下がる現象
次回から「ディープラーニングの手法」に入ります。まずは画像認識の主役、畳み込みニューラルネットワーク(CNN)の仕組みをCNNの記事で解説していきます。覚える内容が多いですが、りけーこっとんも頑張ります!
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。