物体検出とは?R-CNN・Faster R-CNN・YOLO・SSDの違い
どーも、りけーこっとんです。
「R-CNN、Fast R-CNN、Faster R-CNN…何がどう速くなったの?」「YOLOとSSDの違いが分からない」このような、G検定の物体検出の範囲で混乱している方はいないでしょうか?
この記事では、画像の「どこに」「何が」写っているかを当てる物体検出のモデルを解説します。
2段階で検出するR-CNN系と、1段階で検出するYOLO・SSDの違いを軸に、それぞれのモデルが前のモデルの何を改良したのかを表で整理しました。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。
この記事の要点
- 物体検出とは、画像に写っている物体の位置を長方形(バウンディングボックス)で囲み、何の物体かも当てるタスク
- 2段階検出は「物体がありそうな場所を探す→分類する」、1段階検出はそれを一度に行う
- R-CNN→Fast R-CNN(CNNを1回で済ませる)→Faster R-CNN(候補探しもニューラルネットワークで行う)の順に速くなった
- YOLOとSSDは1段階検出で速い。SSDは大きさの違う特徴マップを使うので小さい物体にも強い
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第6章「ディープラーニングの応用例」の「画像認識」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
G検定の勉強シリーズ この記事は、G検定の出題範囲を分野ごとに解説する勉強シリーズのうちの1記事です。
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
- 紙で手元に置きたい方は → G検定カンペの印刷用PDF(無料・A4・15ページ)をダウンロードできます
物体検出とは
物体検出とは、画像に写っているすべての物体について、その位置を長方形で囲み、何の物体かのラベルも当てるタスクです。
前回の「物体識別(画像分類)」とは何が違うかというと、位置まで当てる点です(物体識別はResNetとVGGの記事で解説しています)。
CNNでは「物体の位置は関係ないので、プーリング層でうまく消す」と説明しましたよね。
でも、自動運転で「歩行者がどこにいるか」を知りたいときのように、位置まで把握したいこともあります。
また、画像の中に複数の物体が写っていることもありますよね。
そこで、「写っている物体が何で、どこにあるのか」を当てるのが物体検出です。
バウンディングボックス
物体の位置を表す長方形のことを、バウンディングボックス(矩形領域)と言います。
物体検出では、このバウンディングボックスの位置と大きさ、その中の物体のラベルを出力します。
2段階検出と1段階検出の違い
物体検出のモデルは、大きく次の2つの方式に分かれます。
| 方式 | やり方 | 代表モデル | 特徴 |
|---|---|---|---|
| 2段階検出 | ①物体がありそうな場所(候補領域)を探す→②その候補ごとに分類する | R-CNN、Fast R-CNN、Faster R-CNN | 精度が高いが、比較的遅い |
| 1段階検出 | 場所の検出と分類を、画像全体で一度に行う | YOLO、SSD | 速く、リアルタイム処理に向く |
この2つの違いがG検定ではよく問われるので、まずはここを押さえてから、各モデルを見ていきましょう。
R-CNN系の進化
R-CNNとは
R-CNNとは、画像から物体がありそうな候補領域を探し出し、その候補領域ごとにCNNで特徴を取り出して分類する、物体検出の基本的なモデルです。
2014年に発表されました。手順は次の通りです。
- 入力画像から、物体がありそうな候補領域(関心領域)を約2,000個探し出す
- 候補領域ごとに切り出して、CNNに通して特徴を取り出す
- 取り出した特徴から、領域ごとの物体のラベルを分類し、バウンディングボックスの位置を微調整する
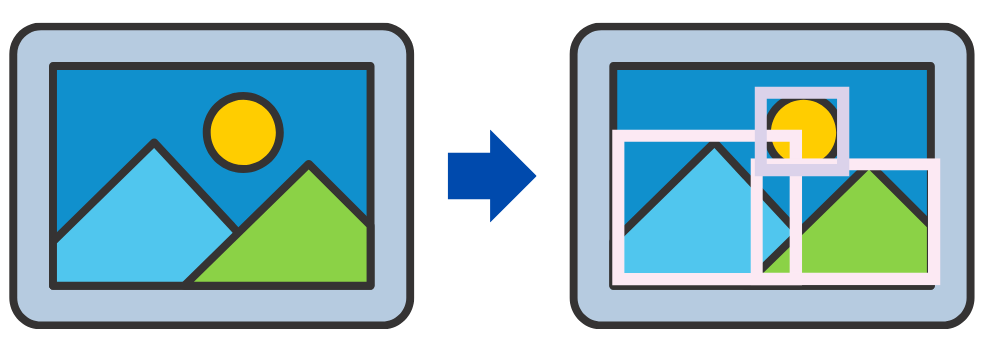
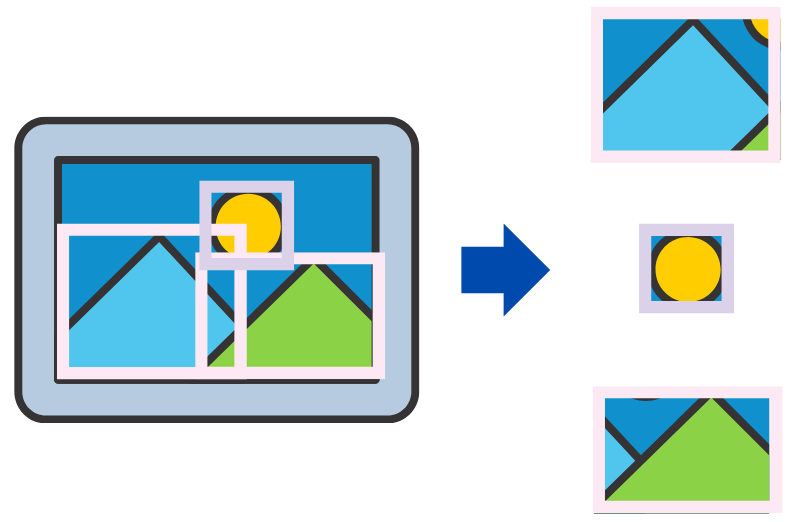
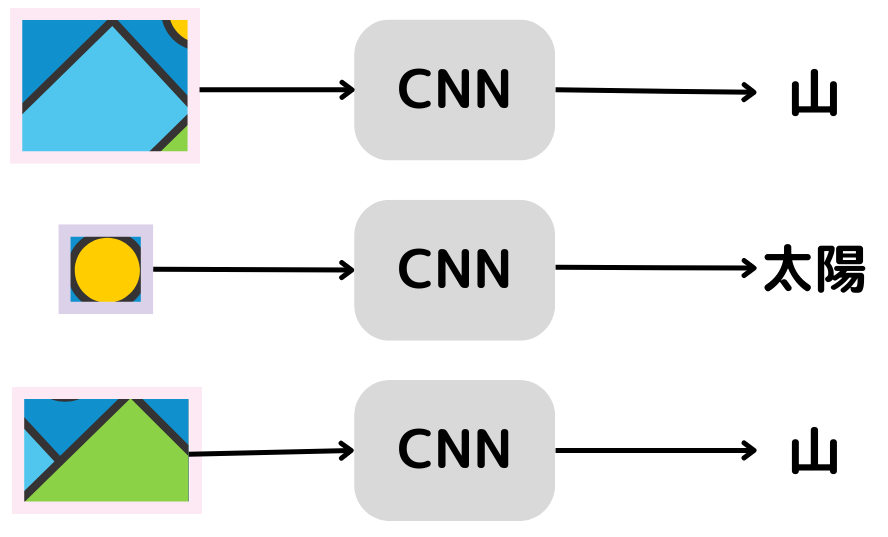
ただ、候補領域が約2,000個もあると、重いCNNを2,000回も計算しなければいけません。とても遅いのが弱点でした。
Fast R-CNNとは
Fast R-CNNとは、画像全体を1回だけCNNに通して特徴マップを作り、そこから候補領域ごとの特徴を切り出すことで、R-CNNを高速化したモデルです。
2015年に発表されました。
R-CNNは候補領域ごとにCNNに通していましたが、Fast R-CNNではCNNの計算を1回で済ませるようにしました。
これで計算回数が大幅に減り、R-CNNよりずっと速くなったんですね。
Faster R-CNNとは
Faster R-CNNとは、候補領域を探す部分もニューラルネットワーク(RPN)に置き換えて、物体検出の全体をニューラルネットワークだけで行えるようにしたモデルです。
2015年に発表されました。
R-CNNとFast R-CNNでは、候補領域を探す部分に、ニューラルネットワークではない従来の方法(Selective Search)を使っていて、ここが遅さの原因になっていました。
Faster R-CNNでは、候補領域を探す部分をRPN(Region Proposal Network)というニューラルネットワークにしたことで、最初から最後までニューラルネットワークで処理できるようになりました(End-to-Endの学習)。
これでさらに計算が速くなっています。
| モデル | 年 | 前のモデルから何を改良したか |
|---|---|---|
| R-CNN | 2014年 | 候補領域ごとにCNNで分類(遅い) |
| Fast R-CNN | 2015年 | CNNの計算を画像全体で1回に |
| Faster R-CNN | 2015年 | 候補領域探しもニューラルネットワーク(RPN)に |
Mask R-CNNとMesh R-CNN
Faster R-CNNは、さらに次のように発展しています。
- Mask R-CNN:Faster R-CNNに、物体の形を画素単位で塗り分ける仕組みを加えたモデルです。
物体を長方形で囲むだけでなく、「どの画素がどの物体か」まで分けられます(インスタンスセグメンテーション)。
詳しくはインスタンスセグメンテーションの記事で解説しています - Mesh R-CNN:2次元の画像から、物体の3次元の形(3Dメッシュ)を推定するモデルです。2019年に発表されました
G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。
データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。

YOLOとSSD
YOLOとは
YOLOとは、画像全体を一度だけCNNに通して、物体の位置(バウンディングボックス)とラベルを同時に予測する、1段階の物体検出モデルです。
You Only Look Once(一度見るだけ)の略で、2016年に発表されました。
R-CNN系では「候補領域を探す→分類する」という2段階でしたよね。
YOLOでは、画像をマス目に分けて、マスごとに「物体の位置」と「ラベル」を同時に予測します。
そうすることで、画像を入れてから結果が出るまでの時間が短くなり、リアルタイムで物体検出ができるようになりました。
SSDとは
SSDとは、YOLOと同じ1段階の物体検出モデルで、大きさの違う複数の特徴マップを使って物体を検出するものです。
Single Shot MultiBox Detectorの略で、2016年に発表されました。
CNNでは、層を重ねるごとに特徴マップは小さくなっていきます。
SSDは、途中の大きい特徴マップでは小さい物体を、後ろの小さい特徴マップでは大きい物体を検出するように、複数の大きさの特徴マップを使い分けます。
そのため、初期のYOLOと比べて次のような強みがあります。
- 小さい物体の検出が得意
- 低い解像度の画像でも、比較的高い精度で検出できる
| モデル | 方式 | ポイント |
|---|---|---|
| YOLO | 1段階 | 画像全体をマス目に分けて一度に予測。とても速い |
| SSD | 1段階 | 大きさの違う複数の特徴マップを使い、小さい物体にも強い |
FPNとは
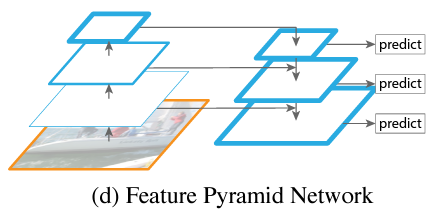
FPNとは、CNNで小さくなった特徴マップを再び大きくしながら、同じ大きさの特徴マップと組み合わせて、いろいろな大きさの物体を検出できるようにする構造です。
Feature Pyramid Networksの略で、2017年に発表されました。
物体検出では、画像の中に大きい物体も小さい物体も写っていますよね。
普通のCNNでは、層を重ねるごとに特徴マップが小さくなり、小さい物体の情報が失われやすくなります。
そこでFPNは、最後の小さい特徴マップから、今度は大きさを元に戻していきます。
引用:Feature Pyramid Networks for Object Detection(arXiv)
この戻す過程がピラミッドのように見えることから、Feature「Pyramid」Networksと覚えるのが良いでしょう。
戻しながら、同じ大きさの特徴マップと組み合わせて予測することで、大きさの違う物体でも精度よく検出できるようになりました。
Faster R-CNNなどと組み合わせて使われます。
モデルの比較表
| モデル | 方式 | 年 | 一言でいうと |
|---|---|---|---|
| R-CNN | 2段階 | 2014年 | 候補領域ごとにCNNで分類 |
| Fast R-CNN | 2段階 | 2015年 | CNNを1回で済ませて高速化 |
| Faster R-CNN | 2段階 | 2015年 | 候補領域探しもRPNで行う |
| YOLO | 1段階 | 2016年 | 位置とラベルを一度に予測。リアルタイム |
| SSD | 1段階 | 2016年 | 複数の大きさの特徴マップで小さい物体にも強い |
| FPN | (構造) | 2017年 | 特徴マップのピラミッドで大小の物体に対応 |
| Mask R-CNN | 2段階 | 2017年 | 画素単位の塗り分けも行う |
よくある質問
Q. 2段階検出と1段階検出の違いは?
2段階検出は「物体がありそうな候補領域を探す」と「候補ごとに分類する」を分けて行う方式で、R-CNN系が代表です。
1段階検出は、位置と分類を画像全体で一度に行う方式で、YOLOやSSDが代表です。
一般に2段階は精度が高く、1段階は速いと言われます。
Q. Faster R-CNNは何が速くなった?
候補領域を探す部分を、従来の方法からRPNというニューラルネットワークに置き換えたことです。
これで物体検出の全体をニューラルネットワークだけで処理できるようになり、Fast R-CNNよりさらに速くなりました。
Q. YOLOとSSDの違いは?
どちらも1段階の物体検出モデルです。SSDは大きさの違う複数の特徴マップを使って検出するので、初期のYOLOより小さい物体や低い解像度の画像に強いという特徴があります。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- 物体検出:物体の位置をバウンディングボックスで囲み、ラベルも当てるタスク
- 2段階検出(R-CNN系)は精度が高く、1段階検出(YOLO・SSD)は速い
- R-CNN→Fast R-CNN(CNNを1回に)→Faster R-CNN(候補探しもRPNで)の順に高速化
- YOLOは位置とラベルを一度に予測、SSDは複数の大きさの特徴マップで小さい物体にも強い
- FPNは特徴マップのピラミッドで、いろいろな大きさの物体を検出できるようにする構造
次回は、画像の画素1つ1つが何かを当てるセマンティックセグメンテーションのモデル(FCN・U-Net・DeepLabなど)をセマンティックセグメンテーションの記事で解説していきます。
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。
分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。