AIC(赤池情報量規準)とは?BIC・オッカムの剃刀も解説
どーも、りけーこっとんです。
「AICって、大きいほうが良いの?小さいほうが良いの?」「第一種の過誤と第二種の過誤、毎回どっちがどっちか分からなくなる」このような、G検定のモデル評価で統計っぽい用語に苦戦している方はいないでしょうか?
この記事では、たくさん作ったモデルの中から「ちょうど良いモデル」を選ぶための考え方を解説します。
オッカムの剃刀、AIC(赤池情報量規準)とBIC、決定係数と自由度調整済み決定係数、そして第一種の過誤・第二種の過誤の覚え方までまとめました。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- オッカムの剃刀とは「ある事柄を説明するときに、必要以上に多くを仮定するべきではない」という考え方
- AICは「当てはまりの良さ」と「モデルの複雑さ」のバランスを見る指標で、小さいほど良いモデル
- BICはAICよりもモデルの複雑さに厳しい指標。データが多いほど、変数を増やすことへのペナルティが大きくなる
- 第一種の過誤は「本当は差がないのに差があると判断」(偽陽性)、第二種の過誤は「本当は差があるのに見逃す」(偽陰性)
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第3章「機械学習の概要」の「モデルの選択・評価」、第8章「AIに必要な数理・統計知識」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。 この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
- 紙で手元に置きたい方は → G検定カンペの印刷用PDF(無料・A4・15ページ)をダウンロードできます
モデルの選択と情報量
精度評価指標はどこで使われるのか
モデルの評価は、基本的には教師あり学習で用いられます。教師あり学習の概要をもう一度示しますね。 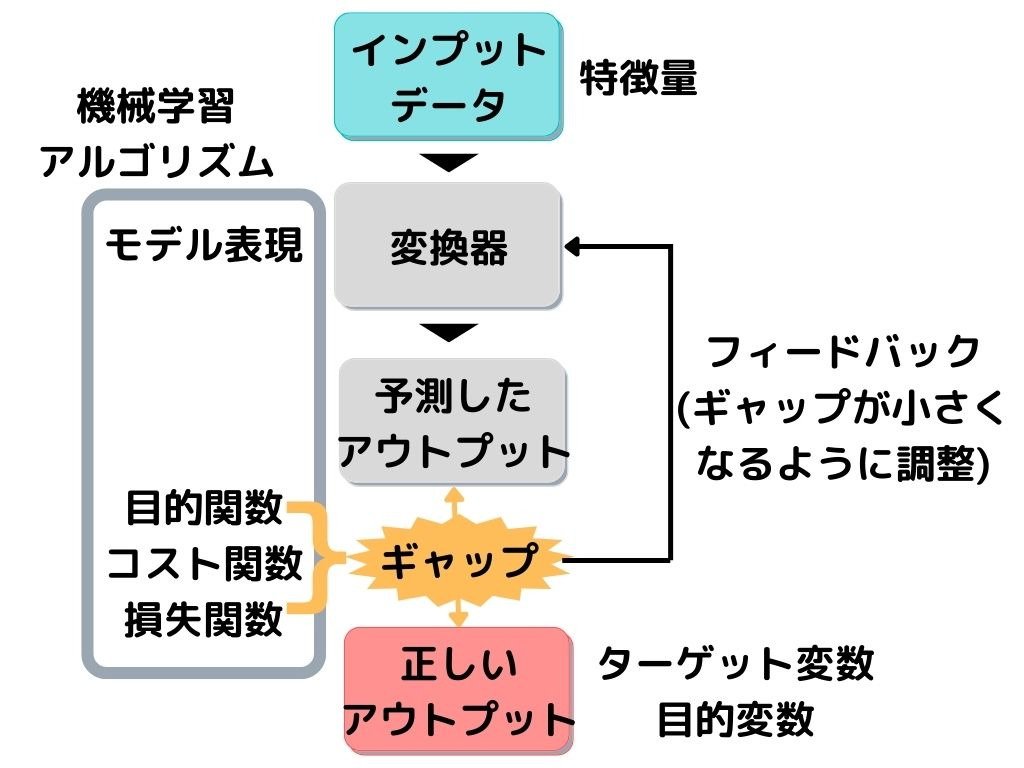 この図の「ギャップ」の部分を測るのが、正解率や適合率などの精度評価指標です(混同行列と評価指標の記事で解説しています)。
ギャップ(誤差)が小さくなるように「変換器」を調整して、もう一回予測。これを繰り返すことで、精度を高めていきます。
過学習と未学習
精度評価指標は、教師データとの「誤差」だけを見ていました。
でも、教師データに対してたくさんの説明変数を使えば、誤差がどんどん小さくなることは予想できるのではないでしょうか。 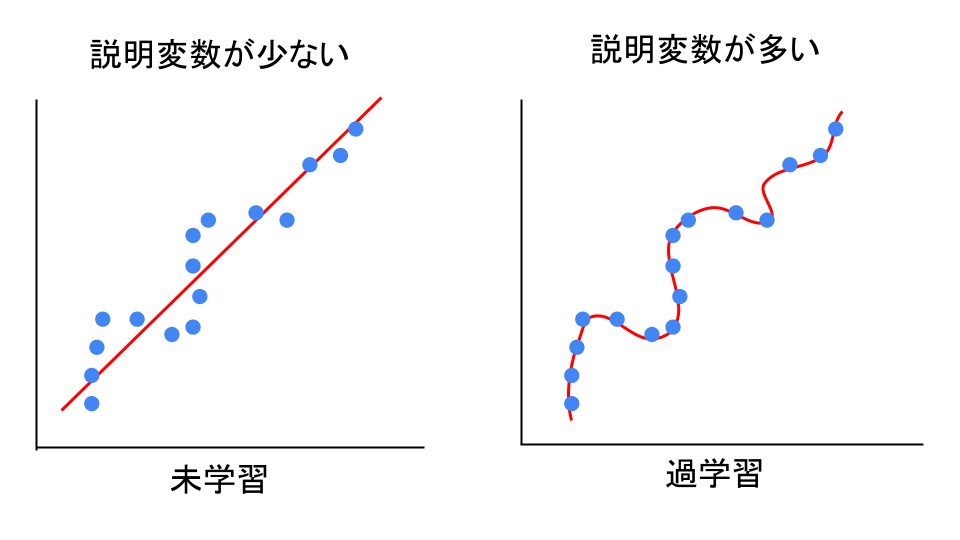 この図の右のように「教師データにモデルが一致しすぎている」状態を過学習、逆に左のように「教師データにモデルが一致していなさすぎる」状態を未学習と言います。
教師データとの誤差が小さくなりすぎると、今度は未知のデータへの予測精度が下がってしまいます。
テスト前に過去問の答えだけ丸暗記して、本番で少し形を変えられると解けなくなる、あの状態ですね。 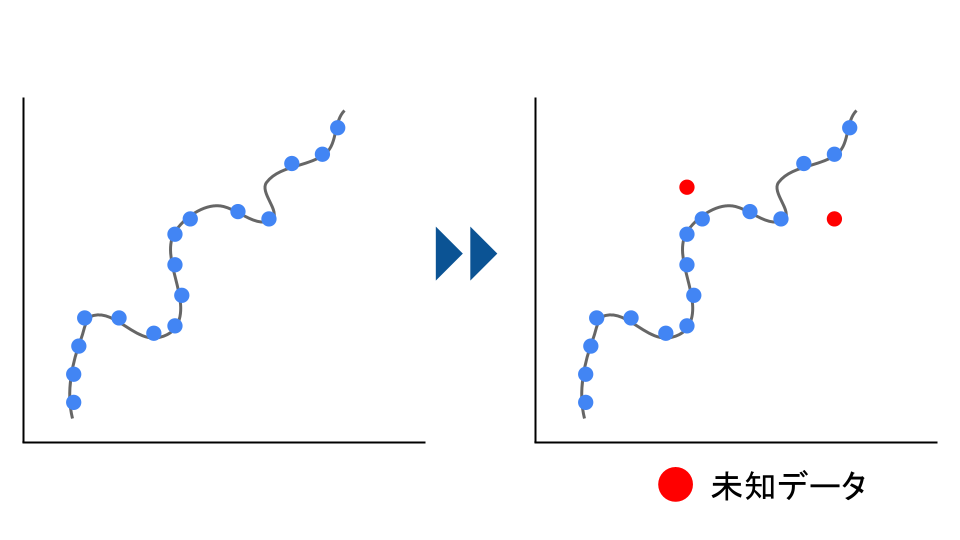 そこで、「ちょうど良い数の説明変数でモデルをシンプルにして、でも予測精度も高い」ようにしたいですよね。その考え方の土台になるのが、次のオッカムの剃刀です。
オッカムの剃刀とは
オッカムの剃刀とは、「ある事柄を説明するときには、必要以上に多くを仮定するべきではない」という考え方のことです。
14世紀のイギリスの哲学者オッカムのウィリアムの名前から来ています。
余計なものを剃刀でそぎ落とす、というイメージですね。
機械学習に当てはめると、「同じくらいの精度なら、説明変数が少ないシンプルなモデルを選ぼう」ということです。
シンプルなモデルの方が過学習しにくく、結果の説明もしやすくなります。
このオッカムの剃刀に従って、「なるべくシンプルで、予測精度の高いモデル」を選ぶための指標が、次のAICとBICです。
AIC(赤池情報量規準)とは
AIC(赤池情報量規準)とは、「当てはまりの良さ」と「モデルの複雑さ」のバランスを見て、良いモデルを選ぶための指標です。
統計学者の赤池弘次が1973年に提案しました。
「赤池情報量基準」と書かれることもありますが、同じものです。 実際の式は次の通りです。 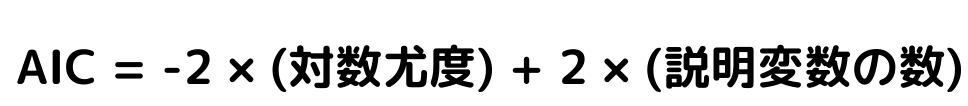 この式の「対数尤度」が当てはまりの良さ、「パラメータ(説明変数)の数」がモデルの複雑さを表しています。
当てはまりが良いほど、そして変数が少ないほど値が小さくなるので、AICは小さいほど良いモデルと言えます。
一つ気を付けたいのは、AICは相対的な指標であることです。
「この値以下であればOK」というものではなく、「モデルAは40、モデルBは30だから、Bの方が良いね」というように、同じデータで作ったモデル同士を比べるのに使います。
BIC(ベイズ情報量規準)とAICの違い
BIC(ベイズ情報量規準)とは、AICと同じくモデルを選ぶための指標で、AICよりもモデルの複雑さへのペナルティを強くしたものです。
AICでは、変数を1つ増やすごとのペナルティが「2」で一定でした。
BICでは、このペナルティにデータの数(の対数)が掛かります。
データが多くなるほど、変数を増やすことへのペナルティが大きくなるんですね。
| 比べるところ | AIC | BIC |
|---|---|---|
| 正式名 | 赤池情報量規準 | ベイズ情報量規準 |
| 判断のしかた | 小さいほど良い | 小さいほど良い |
| 複雑さへのペナルティ | パラメータの数×2 | パラメータの数×データ数の対数 |
| 選ばれやすいモデル | 予測精度を重視したやや複雑なモデル | よりシンプルなモデル |
試験では「どちらも小さいほど良い」「BICの方がシンプルなモデルを選びやすい」の2点を押さえておけば十分です。
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

決定係数と自由度調整済み決定係数
決定係数とは
決定係数とは、回帰モデルが、目的変数のばらつきをどれだけ説明できているかを表す指標です。
R²(アールの二乗)と書かれます。具体的な式は次の通りです。 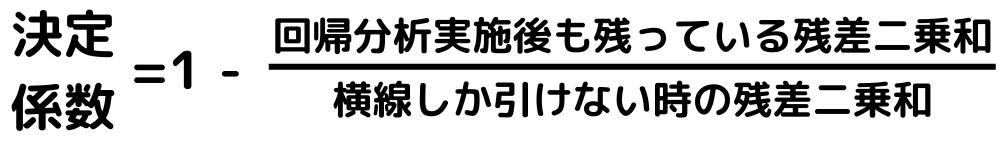 式の中の「横線しか引けないときの残差二乗和」というのは、次のようなイメージです。
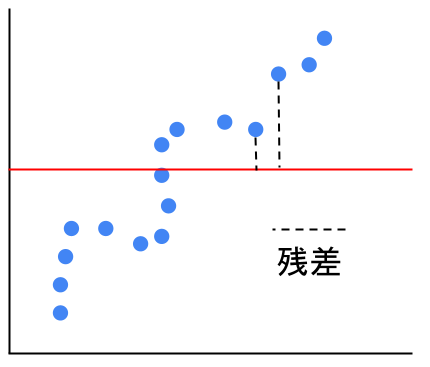
つまり、「目的変数と説明変数にまったく関係がない」と仮定して、平均値で横線を引いたときの残差二乗和です。
それに比べて、モデルのズレがどれだけ小さいかを表しているんですね。
式まで覚える必要はありませんが、次のことは覚えておきましょう。
- 1に近いほど、当てはまりの良いモデル
- ただし、説明変数を増やすと(意味のない変数でも)決定係数は必ず上がるか変わらないので、変数の数が違うモデル同士の比較には向かない
自由度調整済み決定係数とは
自由度調整済み決定係数とは、説明変数の数が多いほど値が下がるように補正した決定係数のことです。
こちらも決定係数と同様、1に近い方が良いということになっています。具体的な式は次の通りです。 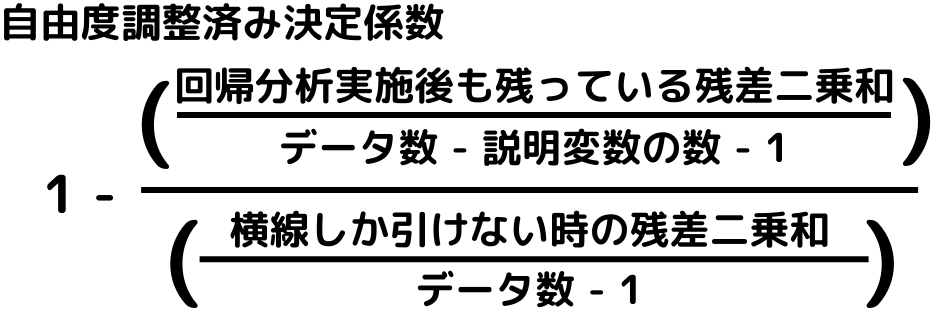 こちらも式が複雑なので、覚える必要はありません。
意味のない変数を増やしても値が上がらないので、変数の数が違うモデルの比較には、決定係数よりも自由度調整済み決定係数を使う、ということを覚えましょう。
第一種の過誤と第二種の過誤
帰無仮説とは
第一種の過誤・第二種の過誤を理解するには、帰無仮説という統計学の知識を知っておく必要があります。
帰無仮説とは、「この仮説は違うと言いたい(無に帰したい)」ために立てる仮説のことです。
例えば「身長が高い人ほど、体重も重い」ことを示したいとしましょう。
このとき、あえて「身長と体重にはまったく関係がない」という仮説を立てます。
この仮説がデータと矛盾することを示して否定(棄却)できれば、「やっぱり関係があるね」と言えますよね。
この「関係がない」という仮説が帰無仮説です。 回りくどい方法ですが、これが統計学の仮説検定の考え方です。
第一種の過誤と第二種の過誤とは
第一種の過誤とは、帰無仮説が本当は正しいのに、間違って否定(棄却)してしまう誤りのことです。
本当は関係がないのに「関係がある」と言ってしまう、偽陽性の間違いですね。
第二種の過誤とは、帰無仮説が本当は間違っているのに、否定(棄却)できずに見逃してしまう誤りのことです。
本当は関係があるのに「関係がない」と言ってしまう、偽陰性の間違いです。 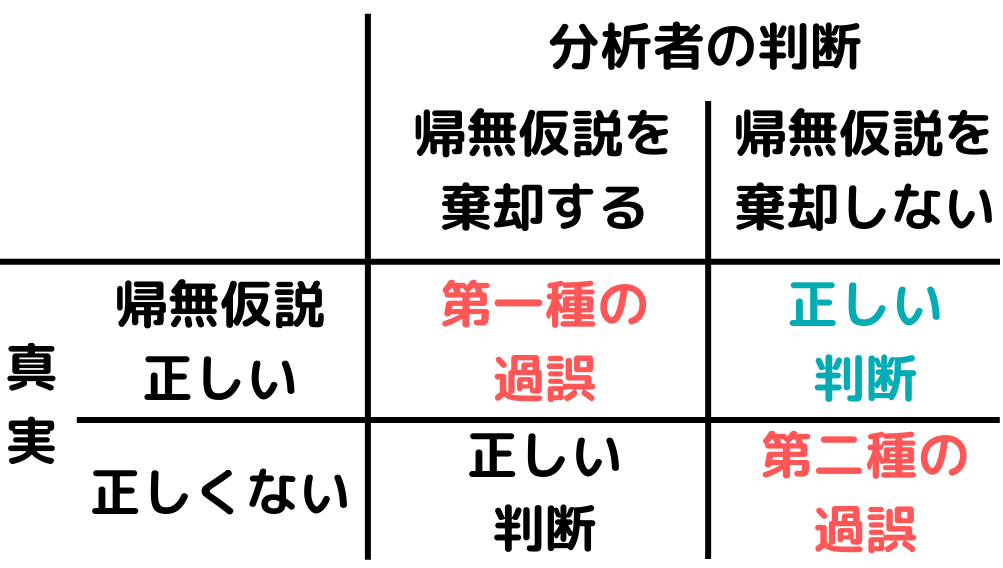
| 実際\判断 | 帰無仮説を棄却する(差がある) | 帰無仮説を棄却しない(差がない) |
|---|---|---|
| 帰無仮説が正しい(本当は差がない) | 第一種の過誤(偽陽性) | 正しい判断 |
| 帰無仮説が間違い(本当は差がある) | 正しい判断 | 第二種の過誤(偽陰性) |
覚え方:あわてんぼうとぼんやり
第一種の過誤・第二種の過誤は毎回ごっちゃになりがち。 そこで覚え方として有名なのが、「第一種はあわてんぼう、第二種はぼんやり」です。
- 第一種の過誤(あわてんぼう): 何もないのに慌てて「差がある!」と言ってしまう。健康な人を「病気です」と診断するイメージ
- 第二種の過誤(ぼんやり): 本当はあるのに、ぼんやりして見逃してしまう。病気の人を「健康です」と見逃すイメージ
混同行列の偽陽性・偽陰性と結びつけると、評価指標の問題にも強くなります。 偽陽性・偽陰性と適合率・再現率の関係は混同行列の記事で解説しています。
G検定での問われ方
| 用語 | 一言でいうと | 覚えるポイント |
|---|---|---|
| オッカムの剃刀 | 必要以上に多くを仮定しない | シンプルなモデルを選ぶ |
| 赤池情報量規準(AIC) | 当てはまりと複雑さのバランスを見る指標 | 小さいほど良い・赤池弘次 |
| ベイズ情報量規準(BIC) | 複雑さへのペナルティがAICより強い指標 | 小さいほど良い・シンプルなモデルを選びやすい |
| 決定係数 | 回帰モデルの当てはまりの良さ | 1に近いほど良い・変数を増やすと上がる |
| 自由度調整済み決定係数 | 変数の数で補正した決定係数 | 変数の数が違うモデルの比較に使う |
| 第一種の過誤 | 正しい帰無仮説を棄却する | 偽陽性・あわてんぼう |
| 第二種の過誤 | 間違った帰無仮説を見逃す | 偽陰性・ぼんやり |
よくある質問
Q. AICは大きいほうが良いですか?
小さいほうが良いモデルです。ただし絶対的な基準はないので、同じデータで作った複数のモデルのAICを比べて、一番小さいものを選ぶ使い方をします。
Q. 決定係数がマイナスになることはある?
あります。決定係数は「平均値で横線を引いただけのモデル」と比べた当てはまりの良さなので、それより悪いモデルだとマイナスになります。
つまりめっちゃ悪いモデル、ということですね。 普通の最小二乗法で切片を入れて当てはめた場合は、0以上になります。
Q. 第一種の過誤と偽陽性は同じ?
考え方は同じです。第一種の過誤は「本当は差がない(陰性)のに、差がある(陽性)と判断する」誤りなので、偽陽性に当たります。
第二種の過誤は偽陰性に当たります。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- オッカムの剃刀:必要以上に多くを仮定しない。同じ精度ならシンプルなモデルを選ぶ
- AIC(赤池情報量規準):当てはまりと複雑さのバランスを見る指標。小さいほど良い
- BIC:AICより複雑さへのペナルティが強く、シンプルなモデルを選びやすい
- 決定係数は変数を増やすと上がるので、変数の数が違うモデルの比較には自由度調整済み決定係数を使う
- 第一種の過誤は偽陽性(あわてんぼう)、第二種の過誤は偽陰性(ぼんやり)
次回は「モデルの評価」最終回として、データの分け方(ホールドアウト検証・交差検証)と、過学習を防ぐ正則化、誤差関数の種類を交差検証と正則化の記事で解説していきます。
覚える内容が多いですが、りけーこっとんも頑張ります!
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。
分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。 お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。