活性化関数とは?シグモイド関数・ReLU関数の違いとGPU・TPU
どーも、りけーこっとんです。
「シグモイド関数の微分の最大値って、いくつだっけ?」「GPUとTPUって何が違うの?」このような、G検定のディープラーニングの基本で迷っている方はいないでしょうか?
この記事では、ディープラーニングを動かすためのハードウェア(CPU・GPU・GPGPU・TPU)と、ニューラルネットワークの各ノードで使われる活性化関数を解説します。
活性化関数は「出力の範囲」と「微分の最大値」がよく問われるので、比較表で一気に押さえましょう。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- ディープラーニングは並列計算が得意なGPUで高速化される。GoogleがAI向けに開発したプロセッサがTPU
- 活性化関数とは、ノードに入ってきた値を変換して次の層に渡す関数。非線形な関数を使うことで複雑な表現ができる
- シグモイド関数は出力0〜1で微分の最大値0.25、tanh関数は出力−1〜1で微分の最大値1
- ReLU関数は正の範囲で微分が1なので勾配消失が起きにくい。負の範囲の傾きを少し残したのがLeaky ReLU関数
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第4章「ニューラルネットワークとディープラーニング」「活性化関数」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
- 紙で手元に置きたい方は → G検定カンペの印刷用PDF(無料・A4・15ページ)をダウンロードできます
CPU・GPU・GPGPU・TPUの違い
AI・ディープラーニングは、コンピュータがあって初めてできることなので、コンピュータの内部構造の基本も押さえておきたいところです。
CPUとは
CPUとは、コンピュータの全体の制御や計算を行う、パソコンの脳みそ的な部分です。Central Processing Unitの略で、プロセッサーとも呼ばれます。
メモリ・ストレージ・周辺機器から情報を受け取り、制御・演算を行う、パソコンの中心的な部分ですね。複雑な計算を1つずつ順番に(直列に)素早く処理するのが得意です。
GPUとは
GPUとは、画像の表示に必要な計算を高速に行うために作られた演算装置です。Graphics Processing Unitの略です。
ゲーム用のパソコンなどを見てみると、よくGPUが使われていますね。画像は小さな点(画素)の集まりなので、同じような計算を大量に一度に行う必要があります。
そのためGPUは、単純な計算を大量に同時に(並列に)処理するのが得意です。
GPGPUとは
GPGPUとは、GPUを画像処理以外の汎用的な計算に使うための技術のことです。General-Purpose computing on GPUの略です。
ディープラーニングの計算は、ほとんどが行列の掛け算です。これは同じような計算を大量に行うものなので、まさにGPUの得意分野なんですね。
「元々並列処理が速いなら、機械学習に使ったらもっと速く計算できるでしょう」と考えられたのがGPGPUで、NVIDIAのCUDAという開発環境が有名です。
TPUとは
TPUとは、Googleがディープラーニングの計算のために独自に開発したプロセッサのことです。Tensor Processing Unitの略で、2016年に発表されました。
ディープラーニングで使う行列の計算(テンソルの計算)に特化しているので、同じ電力ならGPUよりも効率よく計算できる場面があります。
| 装置 | 正式名 | 得意なこと |
|---|---|---|
| CPU | Central Processing Unit | 複雑な計算を順番に処理(直列) |
| GPU | Graphics Processing Unit | 単純な計算を大量に同時に処理(並列) |
| GPGPU | General-Purpose computing on GPU | GPUを画像以外の計算に使う技術 |
| TPU | Tensor Processing Unit | ディープラーニングの行列計算に特化(Google) |
ディープラーニングに必要なデータ量
ディープラーニングに必要なデータ量は、得たい結果の精度にもよりますが、大量の情報が必要です。
実際に様々な事例を見てみると、画像分類だけでも1クラス(1種類)の画像につき100〜200枚のものから、5,000枚以上のものまで様々あります。
1クラスにつき、なので50種類の画像ともなれば、1クラス200枚でも1万枚の画像が必要になりますよね。
目安として、「学習に必要なデータの数は、パラメータの数の10倍」という経験則(バーニーおじさんのルール)が知られています。
分析したい結果や、計算に使えるリソース(CPU・GPU・集められるデータの量)を考えることが大切です。
足りなければ、データ拡張でデータを増やしたり、転移学習を使ったりすることも考えると良いでしょう。
活性化関数とは
活性化関数とは、ニューラルネットワークの各ノードで、入ってきた値を変換して次の層に渡すための関数のことです。
例えば「入力値が0以上なら1、0未満なら0」を出力する活性化関数を見てみましょう。
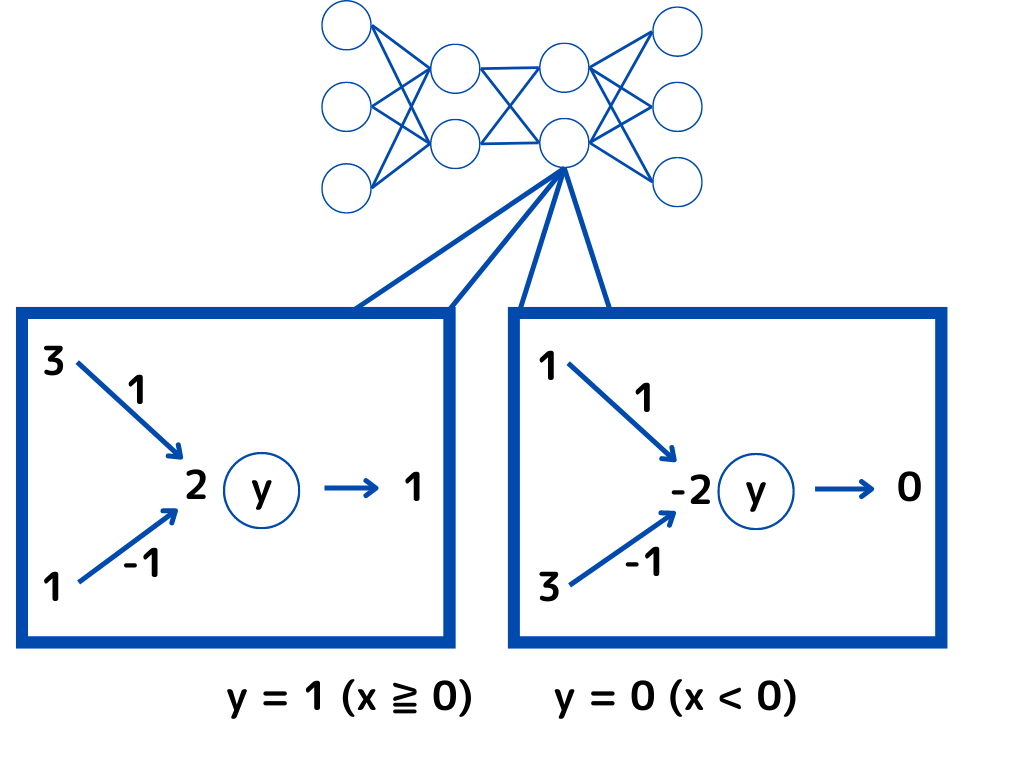
矢印の近くに書いてある数字が「重み」です。
まずは一番左の「入力値」と「重み」を掛け算して、足し合わせます(図の左の例なら「3×1+3×(−1)+…=2」)。
この計算結果「2」を活性化関数に入力すると、0以上なので「1」が出力されます。
活性化関数が大事なのは、非線形な関数だからです。
もし活性化関数がなく、掛け算と足し算(線形の計算)だけを重ねても、何層重ねても結局1層分の直線的な表現しかできません。
活性化関数で曲がった変換を挟むことで、層を重ねるほど複雑な関係を表せるようになるんですね。
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

活性化関数の種類と比較表
活性化関数にはたくさんの種類があり、ここでは次の5つを取り上げます。
シグモイド関数とは
シグモイド関数とは、どんな入力も0から1の間の値に変換する、S字カーブの活性化関数です。式は次の通りです。
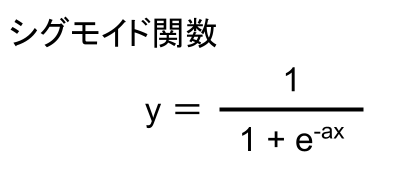
この式をグラフにしてみると、次のようになります。
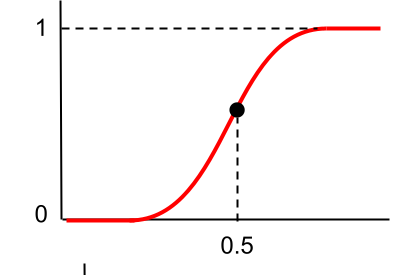
縦軸の範囲は0〜1で、点(0, 0.5)で点対称なグラフですね。出力をそのまま確率として読めるので、よく二値の分類問題の出力層で使われます。
ただし、シグモイド関数を微分すると、その最大値は0.25しかありません。層を重ねるたびに勾配が4分の1以下になってしまうので、勾配消失問題が起きやすいのが問題でした。
tanh関数とは
tanh関数(ハイパボリックタンジェント関数)とは、どんな入力も−1から1の間の値に変換する活性化関数です。式は次の通りです。
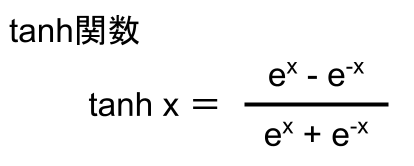
この式をグラフにしてみると、次のようになります。
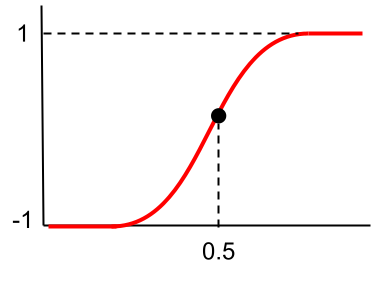
tanh関数はシグモイド関数と形が似ていますが、縦軸の範囲が−1〜1と広くなっています。
微分の最大値は1なので、シグモイド関数よりも勾配消失問題が起きにくいです。ただし、起きにくいだけで解消されるわけではないのでご注意を。
ReLU関数とLeaky ReLU関数
ReLU関数とは、入力が0より大きければそのまま出力し、0以下なら0を出力する活性化関数です。
Rectified Linear Unitの略で、ランプ関数とも呼ばれます。式は次の通りです。
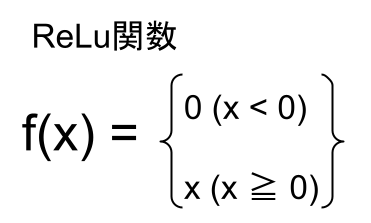
この式をグラフにしてみると、次のようになります。
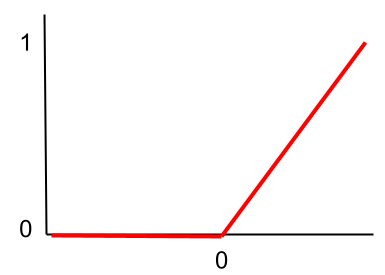
今まで見てきた関数とは、だいぶ形が違いますね。ReLU関数は、入力が0より大きい範囲では微分が常に1になります。
掛け算を繰り返しても1×1=1なので、勾配が小さくなりにくく、勾配消失問題を大きく減らせました。
こんなに単純な関数で勾配消失問題を回避できたので、研究者たちにとっては衝撃だったようですね。今のディープラーニングの隠れ層では、ReLU関数とその仲間が主流です。
ただし、入力が0以下の範囲では微分が0になるので、そこに入ってしまったノードは学習が進まなくなることがあります。
Leaky ReLU関数とは、ReLU関数の0以下の部分にも、わずかな傾きを持たせた活性化関数です。式は次の通りです。
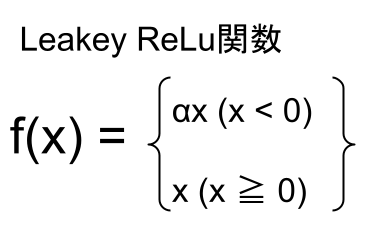
この式をグラフにしてみると、次のようになります。
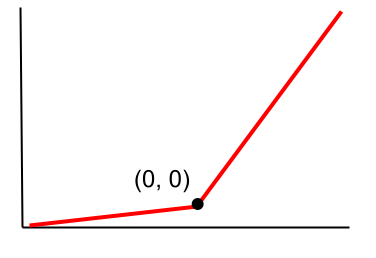
ReLU関数との違いは、0以下の部分ですよね。0以下でも若干の傾きがあるので、微分しても0になりません。
つまり、0以下の値が出てくる場合でも、学習が止まらないようにした関数なんです。傾きの大きさαはハイパーパラメータです。
ソフトマックス関数とは
ソフトマックス関数とは、複数の入力を、それぞれ0から1の間で、合計がちょうど1になる値(確率)に変換する活性化関数です。式は次の通りです。
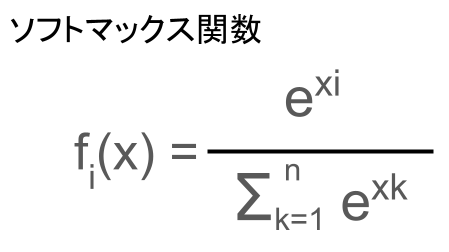
n個の入力があったときに、それぞれの出力の合計が1になるように調整されています。
例えば「犬0.7、猫0.2、鳥0.1」のように、各クラスの確率として読めるので、多値の分類問題の出力層で使われます。
シグモイド関数を、クラスの数だけに広げたようなイメージですね。
比較表:出力範囲と微分の最大値
| 活性化関数 | 出力の範囲 | 微分の最大値 | 主な使いどころ |
|---|---|---|---|
| シグモイド関数 | 0〜1 | 0.25 | 二値分類の出力層 |
| tanh関数 | −1〜1 | 1 | 隠れ層(RNNなど) |
| ReLU関数 | 0以上 | 1(0以下では0) | 隠れ層(今の主流) |
| Leaky ReLU関数 | 制限なし | 1(0以下でもわずかな傾き) | 隠れ層 |
| ソフトマックス関数 | 0〜1(合計が1) | ― | 多値分類の出力層 |
G検定では、「シグモイド関数の微分の最大値は0.25」「tanh関数は1」「ReLU関数は勾配消失が起きにくい」の3点がよく問われます。
G検定での問われ方|活性化関数の早見表
現行シラバスの「活性化関数」のキーワードを一言でまとめておきます。
| 用語 | 一言でいうと | 詳しい解説 |
|---|---|---|
| Leaky ReLU関数 | ReLUの0以下の部分にわずかな傾きを付けた関数。ニューロンが学習しなくなるのを防ぐ | この記事 |
| ReLU関数 | 入力が0以下なら0、正ならそのまま出力する関数。勾配消失しにくく現在の主流 | この記事 |
| tanh関数 | 出力が-1〜1の関数。微分の最大値は1でシグモイドより勾配消失しにくい | この記事 |
| シグモイド関数 | 出力が0〜1の関数。微分の最大値が0.25と小さく、勾配消失が起きやすい | この記事 |
| ソフトマックス関数 | 出力の合計が1になるよう変換する関数。多クラス分類の出力層で使う | この記事 |
| 勾配消失問題 | 層を深くすると、逆伝播の途中で勾配が0に近づき前の層が学習しなくなる問題 | 解説記事 |
よくある質問
Q. シグモイド関数の微分の最大値は?
0.25です(入力が0のとき)。層を重ねるたびに勾配が4分の1以下になるため、勾配消失問題が起きやすい原因になりました。
ちなみにtanh関数の微分の最大値は1です。
Q. ReLUが主流になった理由は?
入力が0より大きい範囲では微分が常に1なので、層を深くしても勾配が小さくなりにくく、勾配消失問題を大きく減らせたからです。
計算が単純で速いことも理由の1つです。
Q. TPUとGPUの違いは?
GPUはもともと画像処理のために作られた、並列計算が得意な演算装置です。
TPUはGoogleがディープラーニングの行列計算のために独自に開発したプロセッサで、AIの計算に特化しています。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- CPUは直列処理、GPUは並列処理が得意。GPUを汎用計算に使うのがGPGPU、Google独自のAI向けプロセッサがTPU
- 活性化関数はノードに入った値を変換する関数。非線形なので層を重ねる意味が出る
- シグモイド関数は出力0〜1・微分の最大値0.25、tanh関数は出力−1〜1・微分の最大値1
- ReLU関数は正の範囲で微分が1で勾配消失が起きにくい。Leaky ReLU関数は0以下にもわずかな傾きを持つ
- ソフトマックス関数は出力の合計が1になり、多値分類の出力層で使う
次回は、ニューラルネットワークの重みをどうやって更新していくか、「最適化手法」(確率的勾配降下法・Adamなど)を確率的勾配降下法とAdamの記事で解説していきます。覚える内容が多いですが、りけーこっとんも頑張ります!
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。