アルゴリズムバイアスとは?公平性・Adversarial Examples
どーも、りけーこっとんです。
「AIが差別をするって、どういうこと?」「画像にノイズを足すだけでAIがだまされるって本当?」
このような、G検定のAIのリスクの範囲で迷っている方はいないでしょうか?
この記事では、AIを社会で使うときに気をつけたいリスクを解説します。
AIの判断がかたよってしまう「アルゴリズムバイアス」と公平性、AIをだます「Adversarial Examples」などのセキュリティの問題、そしてディープフェイクやフェイクニュースといったAIの悪用まで、具体例と一緒に整理しました。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- アルゴリズムバイアスとは、AIの判断が特定のグループに不公平にかたよること。主な原因は学習データの偏り
- 性別などのセンシティブ属性を取り除いても、それと関係の深い代理変数を通じてバイアスが残ることがある
- Adversarial Examplesとは、人には分からない小さなノイズを加えて、AIに間違った判断をさせるデータのこと
- ディープフェイクはディープラーニングで作った本物そっくりの偽の画像・動画で、フェイクニュースに悪用される
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第10章「公平性」「安全性とセキュリティ」「悪用」「民主主義」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
公平性
AIは、データから学んで判断するので、一見すると人よりも公平に見えますよね。
でも実際には、AIが不公平な判断をしてしまうことがあります。
アルゴリズムバイアスとは
アルゴリズムバイアスとは、AIの判断や予測が、性別や人種など特定のグループにとって不公平な方向にかたよってしまうことです。
有名なのが、採用の場面の例です。
過去の採用データに男性が多いという偏りがあると、AIは「男性を採用した方が会社に貢献する」と学んでしまい、女性に不利な判断をするようになります。
実際に、アメリカの大手IT企業が開発していた採用AIが女性に不利な評価をすることが分かり、2018年に使うのをやめたと報道されました。
こうしたことが分かると、世間から「性別で差別するのか!」と批判され、炎上につながることもあります。そのため、教師データの準備には細心の注意が必要なんですね。
データの偏りとサンプリングバイアス
アルゴリズムバイアスの大きな原因が、学習データのデータの偏りです。
AIは、学習したデータの傾向をそのまま覚えるので、データがかたよっていれば、判断もかたよってしまいます。
サンプリングバイアスとは、データを集める方法にかたよりがあり、集めたデータが本来調べたい対象全体を正しく表していないことです。
例えば、顔認識のAIを、明るい肌の色の人の画像ばかりで学習させると、暗い肌の色の人をうまく認識できなくなります。
実際に、市販の顔認識のAIで、肌の色や性別で精度が違うことが研究で指摘されました。
データを集めるときは、いろいろな人や状況がバランスよく含まれているかを確認することが大切です。
センシティブ属性と代理変数
センシティブ属性とは、性別・人種・宗教・年齢など、それを使って判断すると差別につながるおそれのある情報のことです。
「それなら、センシティブ属性をデータから消せばいいのでは?」と思いますよね。
ところが、それだけでは不十分なんです。
代理変数とは、センシティブ属性そのものではないけれど、センシティブ属性と強く関係していて、その代わりになってしまう変数のことです。
例えば、住んでいる地域(郵便番号)が人種と強く関係していたり、趣味や名前が性別と関係していたりします。
センシティブ属性を消しても、代理変数を通じてバイアスが残ることがあるんですね。そのため、データの中身をよく調べることが大切です。
公平性の定義
公平性とは、AIの判断が、特定のグループや個人に対して不当に有利・不利にならないことです。
ただし、「何をもって公平とするか」には、いくつもの定義があります。
| 定義の例 | 考え方 |
|---|---|
| グループごとの結果を同じにする | 男女で、採用される人の割合を同じにする |
| グループごとの正解率を同じにする | 本当に能力がある人の中で、合格する人の割合を男女で同じにする |
| 個人の公平性 | よく似た人には、同じような判断をする |
これらの定義は、すべてを同時には満たせないことが多いと知られています。
そのため、AIを使う目的に合わせて、どの公平性を大切にするかを関係者で話し合って決める必要があります。
安全性とセキュリティ
AIには、普通のシステムとは違う、AIならではの攻撃のされ方があります。
Adversarial Attack(Adversarial Examples)
Adversarial Examples(敵対的サンプル)とは、人の目には分からないほど小さなノイズをデータに加えて、AIに間違った判断をさせるように作られたデータのことです。
このデータを使ってAIをだます攻撃を、Adversarial Attack(敵対的な攻撃)と言います。
有名なのが、パンダの画像の例です。パンダの画像に、人には見えないような小さなノイズを加えると、人にはパンダにしか見えないのに、AIはテナガザルと高い確信度で判断してしまいました(2014年、イアン・グッドフェローらの論文)。
ほかにも、道路の「止まれ」の標識に小さなシールを貼るだけで、AIが別の標識と間違えてしまうことが報告されています。
人の検出でも、体の前に特殊な模様の紙を持つだけで、AIに人として検出されなくなる例があります。
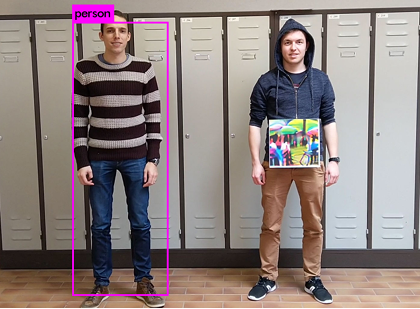
自動運転や顔認証などでこのような攻撃を受けると、大きな事故や被害につながりかねません。対策としては、次のようなものがあります。
- Adversarial Examplesを学習データに加えて、だまされにくいモデルにする(敵対的学習)
- 入力されたデータのノイズを取り除いてからAIに入力する
- 怪しい入力を見つけて、AIに入れないようにする
データ汚染とモデル汚染
データ汚染とは、AIの学習データに、攻撃する人がわざと不正なデータを混ぜて、AIが間違った学習をするようにする攻撃のことです。
データポイズニングとも言います。
例えば、迷惑メールを見分けるAIの学習データに、迷惑メールを「普通のメール」としたデータを混ぜると、AIは迷惑メールを見逃すようになってしまいます。
モデル汚染とは、学習済みのモデルそのものに細工をして、特定の入力のときだけ攻撃する人の思い通りに動くようにする攻撃のことです。
普段は正しく動くのに、特定の目印(トリガー)があるときだけおかしな判断をする「バックドア」を仕込む例があります。
インターネットで公開されている学習済みモデルを使うときは、信頼できる提供元かを確認することが大切です。
データ窃取とモデル窃取
データ窃取とは、AIの学習に使われたデータを、攻撃する人が盗み出したり、AIの出力から推測したりすることです。
例えば、AIへの問い合わせの結果から、ある人のデータが学習に使われたかどうかを推測する攻撃(メンバーシップ推論攻撃)があります。
学習データに個人情報が含まれていると、プライバシーの問題になりますよね。
モデル窃取とは、AIにたくさんの問い合わせをして、その入力と出力の組み合わせから、元のAIとよく似たモデルを作ってしまう攻撃のことです。
お金と時間をかけて作ったAIを、問い合わせるだけでまねされるおそれがあるんですね。
生成AIでは、AIへの指示文(プロンプト)に悪意のある命令を紛れ込ませて、AIに本来してはいけない動作をさせるプロンプトインジェクションという攻撃も問題になっています。
セキュリティ・バイ・デザイン
セキュリティ・バイ・デザインとは、システムを企画・設計する最初の段階から、セキュリティの対策を組み込んでおく考え方のことです。
完成してから対策をするよりも、最初から組み込む方が、手間もお金も少なく済みます。
プライバシーの保護を最初から組み込む「プライバシー・バイ・デザイン」と似た考え方ですね(プライバシー・バイ・デザインの記事で解説しています)。
AIでは、ここまで見てきたAIならではの攻撃も想定しておくことが大切です。
悪用|ディープフェイクとフェイクニュース
ディープフェイクとは
ディープフェイクとは、ディープラーニングを使って作られた、本物そっくりの偽の画像・動画・音声のことです。
ディープラーニング(Deep Learning)と偽物(Fake)を組み合わせた言葉です。
人の顔を別の人の顔に入れ替えたり、実在の人物が実際には言っていないことを話しているような動画を作ったりできます。
GANなどの生成モデルの進化で、本物と見分けるのが難しいほどの質になっています(GANはGANの記事で解説しています)。
有名人や政治家の偽の動画が作られたり、家族の声をまねした詐欺に使われたりする問題が起きています。
フェイクニュースとは
フェイクニュースとは、事実ではないうその情報を、本当のニュースのように見せかけて広めるもののことです。
2016年のアメリカ大統領選挙で、SNSを通じて多くのうその情報が広まったことで、大きな問題として注目されました。
ディープフェイクや生成AIを使えば、もっともらしいうその記事や動画を、誰でも簡単に大量に作れるようになってしまいます。
選挙の結果や人々の考えに影響を与えるおそれがあり、民主主義への脅威とも言われています(フィルターバブルとエコーチェンバーの記事もあわせてどうぞ)。
対策として、ディープフェイクを見破るAIの研究や、画像や動画がいつ誰によって作られたかを記録する技術(来歴の記録)などが進められています。
AIはもう大人だけのものではありません。お子さんと一緒に、生成AIの正しい使い方から学べる講座もあります。


自動運転のレベルと法律
AIを社会で使うときのリスクと法律の関係で、よく取り上げられるのが自動運転です(現行シラバスでは詳細キーワードから外れていますが、AIと法律の例として押さえておきましょう)。
自動運転のレベルとは、車の運転を人とシステムのどちらがどこまで担うかを、レベル0からレベル5の6段階で表したものです。
| レベル | 名前 | 運転するのは |
|---|---|---|
| レベル0 | 運転自動化なし | 人がすべて運転する |
| レベル1 | 運転支援 | ハンドルかアクセル・ブレーキのどちらかをシステムが支援する |
| レベル2 | 部分運転自動化 | ハンドルとアクセル・ブレーキの両方をシステムが支援する(人が監視する) |
| レベル3 | 条件付運転自動化 | 決まった条件の中でシステムが運転する。システムに頼まれたら人が代わる |
| レベル4 | 高度運転自動化 | 決まった条件の中で、システムがすべて運転する(人は不要) |
| レベル5 | 完全運転自動化 | どんな条件でもシステムがすべて運転する |
レベル3からは、決まった条件の中でシステムが運転の主体になります。
日本では、法律も次のように変わってきました。
- 道路交通法:2019年の改正(2020年4月施行)でレベル3、2022年の改正(2023年4月施行)でレベル4(特定自動運行)が可能に
- 道路運送車両法:2019年の改正で、自動運転の装置(自動運行装置)の安全の基準を定めた
事故が起きたときに誰が責任を負うのかなど、技術だけでなく法律やルールの整備も大切なんですね。
公平性・安全性・悪用の早見表
現行シラバスの「公平性」「安全性とセキュリティ」「悪用」のキーワードは、次の表で確認できます。
| 用語 | 一言でいうと | 詳しい解説 |
|---|---|---|
| アルゴリズムバイアス | 学習データの偏りなどによって、AIが特定の集団に不公平な判断をすること | この記事 |
| 公平性の定義 | 何をもって公平とするか。グループ間で結果をそろえる、条件ごとの誤り率をそろえるなど複数の定義がある | この記事 |
| サンプリングバイアス | データの集め方が偏り、母集団を正しく反映していないこと | この記事 |
| センシティブ属性 | 人種・性別・宗教など、差別につながりうる属性 | この記事 |
| 代理変数 | センシティブ属性を除いても、それと強く関係する別の変数(住所など)を通じて差別が起きること | この記事 |
| データの偏り | 学習データに特定の属性や状況が多すぎたり少なすぎたりすること | この記事 |
| Adversarial Attack(Adversarial Examples) | 人には分からない小さなノイズを加えて、AIに誤判定させる攻撃 | この記事 |
| セキュリティ・バイ・デザイン | 企画・設計の段階からセキュリティ対策を組み込んでおく考え方 | この記事 |
| データ汚染 | 学習データに不正なデータを混ぜて、AIの判断をゆがめる攻撃(ポイズニング) | この記事 |
| データ窃取 | AIへの問い合わせなどを通じて、学習に使われたデータを盗み出す攻撃 | この記事 |
| モデル窃取 | AIに大量に問い合わせた結果から、そっくりなモデルを複製する攻撃 | この記事 |
| モデル汚染 | 学習済みモデルに細工をして、特定の入力で誤動作するようにする攻撃 | この記事 |
| ディープフェイク | ディープラーニングで作られた、本物と見分けにくい偽の画像・動画・音声 | この記事 |
| フェイクニュース | 事実ではない情報を、ニュースのように見せかけて広めること | この記事 |
よくある質問
Q. アルゴリズムバイアスはなぜ起きる?
主な原因は、学習データの偏りです。
AIは学習したデータの傾向をそのまま覚えるので、過去のデータに偏り(例えば採用データに男性が多い)があると、AIの判断もかたよってしまいます。
データの集め方のかたより(サンプリングバイアス)や、代理変数も原因になります。
Q. 代理変数とは?
性別や人種などのセンシティブ属性そのものではないけれど、それと強く関係していて代わりになってしまう変数です。
例えば、住んでいる地域が人種と関係している場合などです。センシティブ属性を消しても、代理変数を通じてバイアスが残ることがあります。
Q. Adversarial Examplesの有名な例は?
パンダの画像に人には分からない小さなノイズを加えると、AIがテナガザルと判断してしまった例が有名です。
ほかにも、止まれの標識に小さなシールを貼ると別の標識と間違える例などがあります。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- アルゴリズムバイアスは、AIの判断が特定のグループに不公平にかたよること。主な原因はデータの偏りやサンプリングバイアス
- センシティブ属性を消しても、代理変数を通じてバイアスが残ることがある。公平性の定義は1つではない
- Adversarial Examplesは、小さなノイズでAIをだますデータ。対策には敵対的学習などがある
- データ汚染・モデル汚染・データ窃取・モデル窃取などAIならではの攻撃があり、セキュリティ・バイ・デザインで最初から備える
- ディープフェイクは本物そっくりの偽の画像や動画で、フェイクニュースに悪用され民主主義への脅威になる
次回は、こうしたリスクに組織としてどう向き合うかを、AI倫理のガイドラインやAIガバナンスとしてAIガバナンスの記事で解説していきます。
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
G検定に合格したあと、その資格をどう使うかまで考えておくと勉強のモチベーションが続きます。AI・データ系の求人では、こうした基礎知識を持っていることが評価される場面も増えています。どんな求人があるのか眺めておくだけでも、学ぶ内容の優先順位が見えてきますよ。


20代で未経験からIT職を目指す方は、若手向けの就職・転職サービスを使うと、書類作成から面接まで相談できます。