転移学習とファインチューニングの違い|データ拡張・Few-shotも解説
どーも、りけーこっとんです。
「転移学習とファインチューニング、何が違うの?」「Cutout、Mixup、CutMix…データ拡張の名前が多すぎて覚えられない」
このような、G検定のCNNの後半で混乱している方はいないでしょうか?
この記事では、データが少なくてもディープラーニングを活かすための工夫を解説します。
学習済みモデルを使い回す転移学習とファインチューニング、Few-shot学習、データを水増しするデータ拡張、そしてCNNの源流(ネオコグニトロン・LeNet)と、スマホでも動く軽量なCNN(MobileNet・EfficientNet)までまとめました。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- 転移学習は学習済みモデルの出力層だけを入れ替えて学習し、ファインチューニングは学習済みモデルの重みも少しずつ更新する
- ファインチューニングで新しい作業を学ぶと、前に覚えたことを忘れてしまうことがある(破滅的忘却)
- データ拡張は、画像の切り抜き・回転・反転や、一部を隠す・2枚を混ぜるなどで、訓練データを水増しする方法
- CNNの原型はネオコグニトロン(福島邦彦)、最初のCNNはLeNet(ヤン・ルカン)
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第5章「データ拡張」、第6章「転移学習・ファインチューニング」「画像認識」ほかの範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
- 紙で手元に置きたい方は → G検定カンペの印刷用PDF(無料・A4・15ページ)をダウンロードできます
転移学習とファインチューニングの違い
ディープラーニングで十分な精度を出すには、大量のデータが必要です。
でも、自分の作業のためにデータを何万枚も集めるのは大変ですよね。
そこで、すでに学習してあるモデルを使い回す方法が考えられました。
事前学習済みモデルとは
事前学習済みモデルとは、大量のデータであらかじめ学習させておいた、そのまま使い回せるモデルのことです。
例えば、ImageNetの1,000種類以上の画像で学習したCNNは、「線」「角」「模様」のような、どんな画像にも共通する特徴を取り出す力をすでに身につけています。
この力を、自分の作業に流用するわけですね。
文章ならBERTやGPTが代表的な事前学習済みモデルです。
転移学習とは
転移学習とは、学習済みモデルの最後の出力層だけを、自分の作業用のものに入れ替えて学習させ、別の作業に転用する方法です。
転移学習を図示すると、次のような感じです。
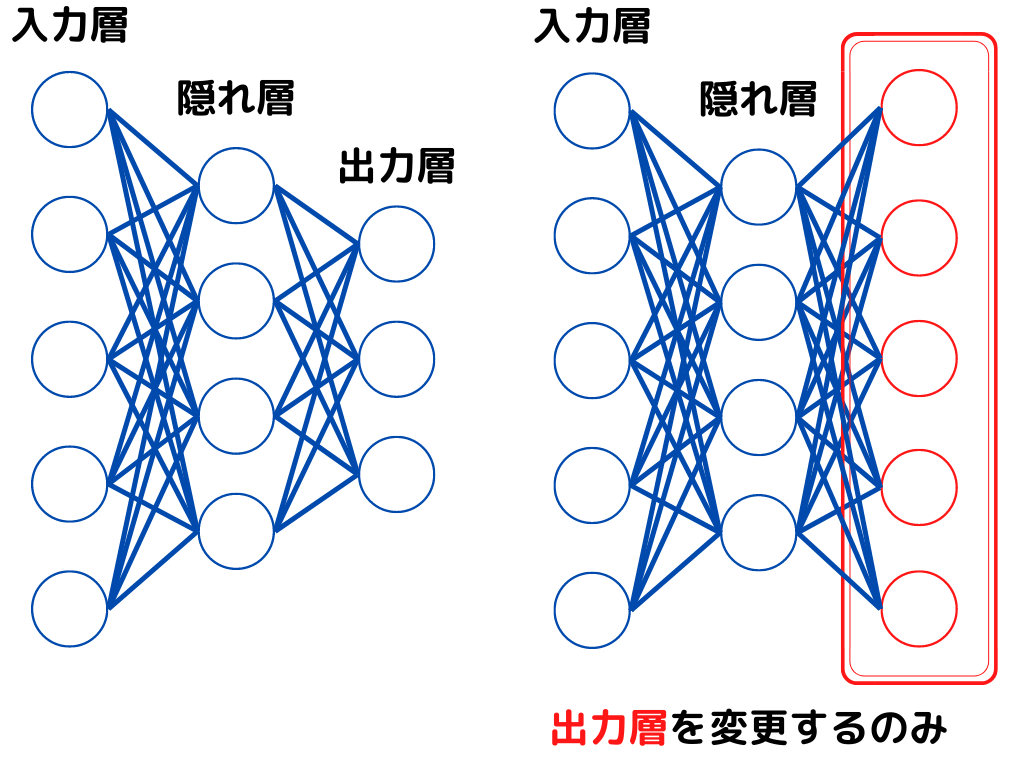
このように最終出力層を入れ替えるだけで、それ以外の層の重みは更新しません。
すでにモデルを学習してあるので、学習が速く進み、少ないデータでも精度が出やすいんです。
ファインチューニングとは
ファインチューニングとは、学習済みモデルの出力層を入れ替えたうえで、それ以外の層の重みも少しずつ調整(微調整)して、別の作業に合わせる方法です。
ファインチューニングを図示すると、次の通りです。
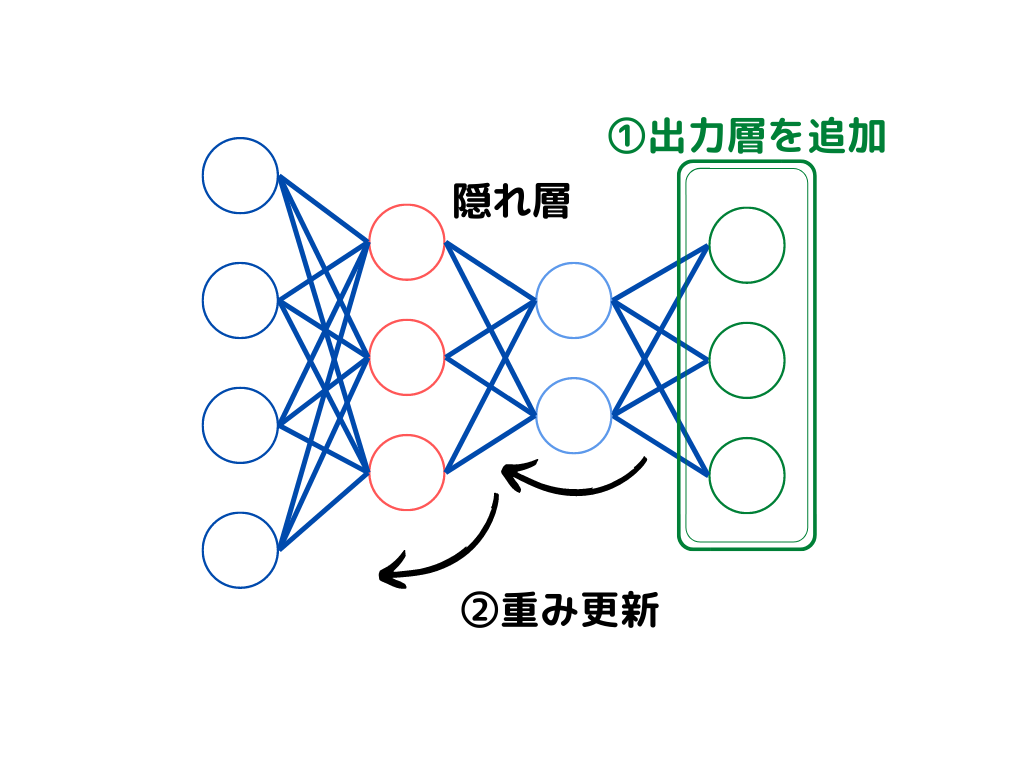
転移学習は「最終出力層の入れ替え」だけ、ファインチューニングは「最終出力層と、既存の重みの更新」まで行う、というのが違いです。混同しやすいので注意しましょう。
| 方法 | 最終出力層 | それ以外の層の重み |
|---|---|---|
| 転移学習 | 入れ替えて学習する | 更新しない(そのまま使う) |
| ファインチューニング | 入れ替えて学習する | 少しずつ更新する |
なお、大きな学習済みモデルの出力をお手本にして、小さいモデルを学習させる蒸留という方法もあります。
目的は「モデルを軽くすること」なので、転移学習・ファインチューニングとは目的が違います。蒸留はモデル軽量化の記事で解説しています。
破滅的忘却とは
破滅的忘却とは、ニューラルネットワークが新しい作業を学習すると、前に学習していた作業のことを急に忘れてしまう現象のことです。
ファインチューニングで重みを大きく更新しすぎると、事前学習で身につけた汎用的な力まで上書きされて失われてしまうんですね。
対策として、学習率を小さくして重みを少しずつしか変えない、入力層に近い層は固定しておく、といった工夫が行われます。
Few-shot学習とOne-shot学習
Few-shot学習とは、新しい作業について、ほんの数個の例だけを見せて対応させる学習方法のことです。
例えば、事前学習済みの大規模言語モデルに「りんご→apple、みかん→orange、ぶどう→」のように、数個の例を見せるだけで、新しい作業をこなさせることができます。
One-shot学習とは、新しい作業について、たった1つの例だけを見せて対応させる学習方法のことです。
顔認証で、1枚の顔写真を登録するだけでその人を見分けられるようにする、といった使い方がありますね。
例を1つも見せずに対応させるものはZero-shot学習と呼ばれます(CLIPとZero-shotの記事で解説しています)。
いずれも、大量のデータで事前学習したモデルの力があるからこそできる方法です。
データ拡張とは
データ拡張とは、手元の訓練データに加工を加えて新しいデータを作り、データを水増しする方法です。
ディープラーニングで十分な精度を出すには、数千、数万枚の画像が必要なこともあります。
でも、大量の画像を集めるのはシンプルに大変ですよね。データ拡張を使えば、同じ画像からでも何種類もの「違う」画像を作れます。
データが増えるので、過学習を防ぐ効果もあります。
画像の基本操作(Crop・Rotate・Random Flip・Brightness・Contrast)
まずは、画像に対する基本的な加工です。
| 手法 | やること |
|---|---|
| Crop | 画像の一部を切り抜く |
| Rotate | 画像を回転させる |
| Random Flip | ランダムに左右(上下)を反転させる |
| Brightness | 画像の明るさを変える |
| Contrast | 画像の明暗の差(コントラスト)を変える |
猫の写真を少し回転させても、明るくしても、猫は猫ですよね。こうした加工で、写り方の違いに強いモデルにできます。
ただし、数字の「6」を180度回転させると「9」になってしまうように、加工で正解が変わらないかには注意が必要です。
隠す・混ぜる手法(Cutout・Random Erasing・Mixup・CutMix)
Cutoutとは、画像の一部の正方形の領域を、0などで塗りつぶして隠す手法です。
「マスクをかける」とも言います。
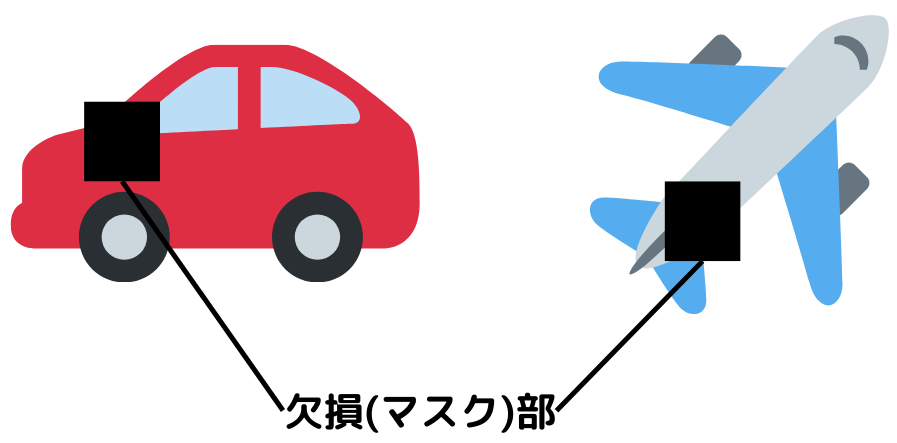
Random Erasingとは、画像の上に、ランダムな位置・大きさ・縦横比の長方形を重ねて、その中をランダムな値で埋める手法です。
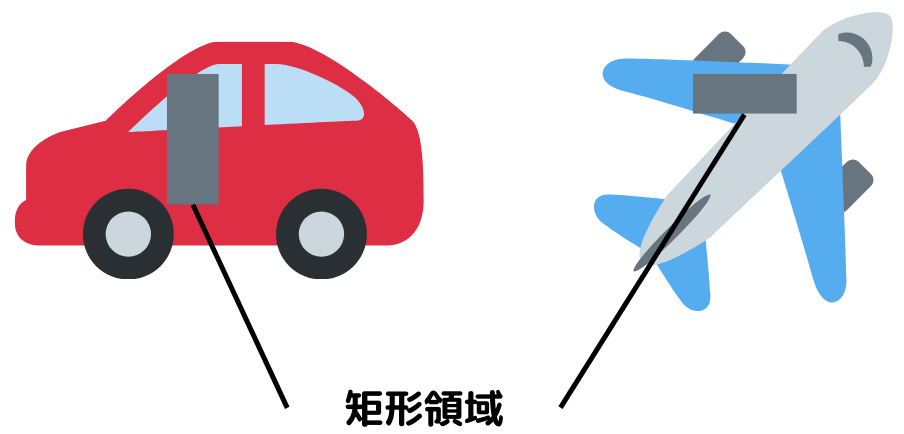
Cutoutとよく似ていますが、Random Erasingは大きさや縦横比もランダムに変える点が違います。
物体の一部が隠れていても見分けられるように、という狙いは同じですね。
Mixupとは、2つの訓練データの画像と正解ラベルを、ある割合で混ぜ合わせて新しい訓練データを作る手法です。
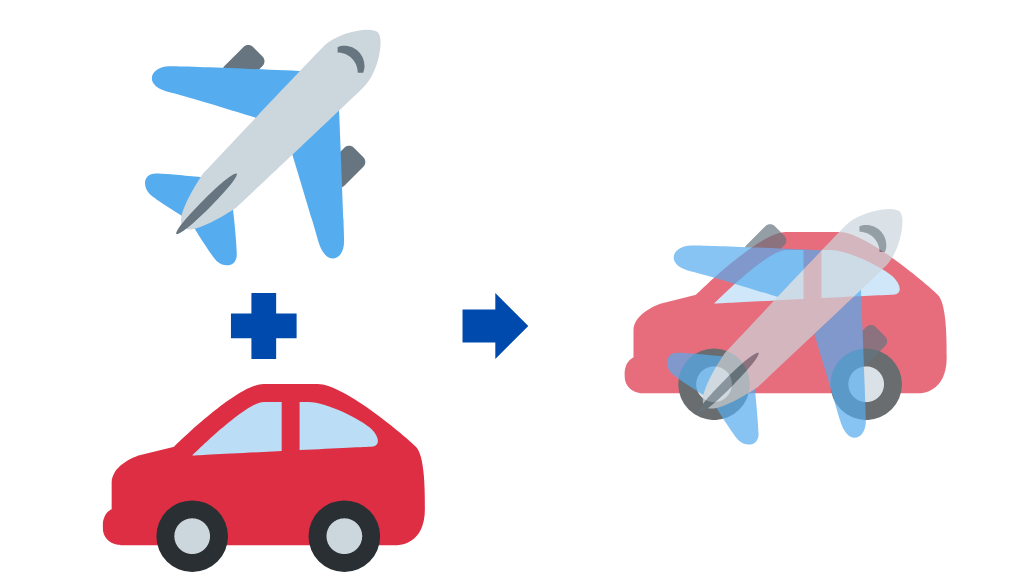
名前の通り、2つのデータを混合(mix)して水増ししていますよね。
例えば「犬の画像70%+猫の画像30%」を作り、正解も「犬0.7、猫0.3」にします。
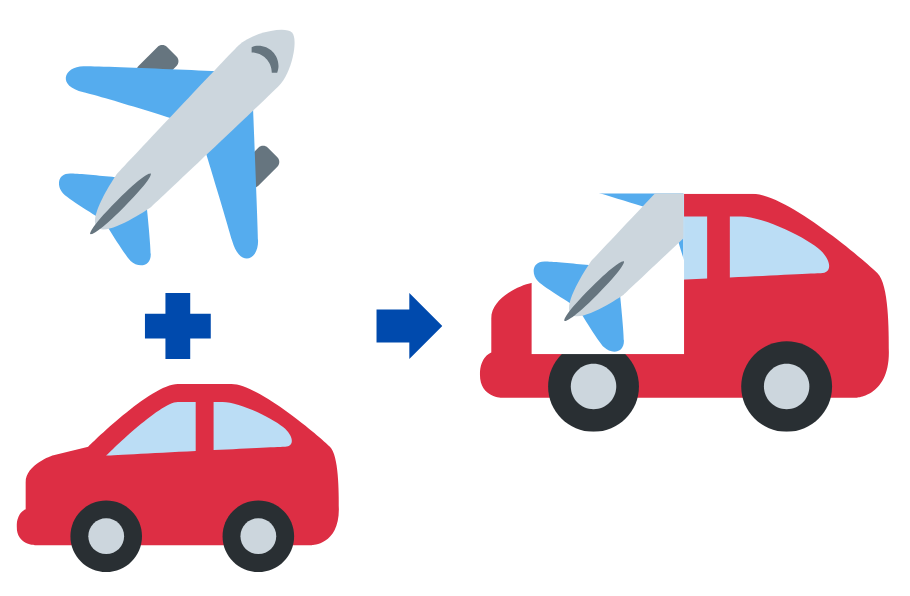
CutMixとは、画像の一部を切り取り、そこに別の画像の一部を貼り付けて、正解ラベルも貼り付けた面積の割合で混ぜる手法です。
CutoutとMixupを合わせたような改良手法ですね。
RandAugment
RandAugmentとは、たくさんのデータ拡張の手法の中からランダムにいくつかを選び、決めた強さで適用する手法です。
2019年にGoogleが発表しました。
それまでは、どの拡張をどの強さで使うかを、機械に何度も試させて探す(AutoAugment)必要があり、計算がとても大変でした。
RandAugmentは、「いくつ選ぶか」と「強さ」の2つだけを決めればよいので、手軽に高い効果が出せるようになりました。
テキストのデータ拡張(noising・paraphrasing)
データ拡張は画像だけのものではありません。文章のデータにも使えます。
- noising:文章の単語をランダムに削除したり、入れ替えたり、別の単語に置き換えたりして、少しノイズを加える
- paraphrasing:意味を変えずに、別の言い回しに言い換える(「とても良い」→「すごく良い」など)
文章の場合も、意味(正解)が変わらないように加工することが大切です。
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

CNNの源流|ネオコグニトロンとLeNet
ネオコグニトロンとは
ネオコグニトロンとは、福島邦彦が提唱した、人の視覚の仕組みをまねたニューラルネットワークで、畳み込みニューラルネットワークの原型です。
1979年に福島邦彦が発表しました(論文は1980年)。
人の視覚の神経回路には、「S細胞」と「C細胞」の2つがあります。
- S細胞:目で捉えた画像から、形などの特徴を取り出す
- C細胞:S細胞で取り出した特徴の、位置のずれを吸収する
この「特徴を取り出すS細胞の層」と「位置のずれを許すC細胞の層」を交互に何層も重ねたのが、ネオコグニトロンです。
CNNの基本に非常に似ていますよね。
「S細胞→畳み込み層」「C細胞→プーリング層」といった対応になっています。
このように、画像の一部分(局所)だけを次の層につなぐ構造を局所結合構造と言います。
LeNetとは
LeNetとは、1989年にヤン・ルカンらが提案した、誤差逆伝播法で学習する最初の畳み込みニューラルネットワークです。
手書き数字の認識(郵便番号の読み取りなど)に使われました。ヤン・ルカンもAI分野でとても有名な研究者なので、覚えておきましょう。実際の構造は次の通りです。
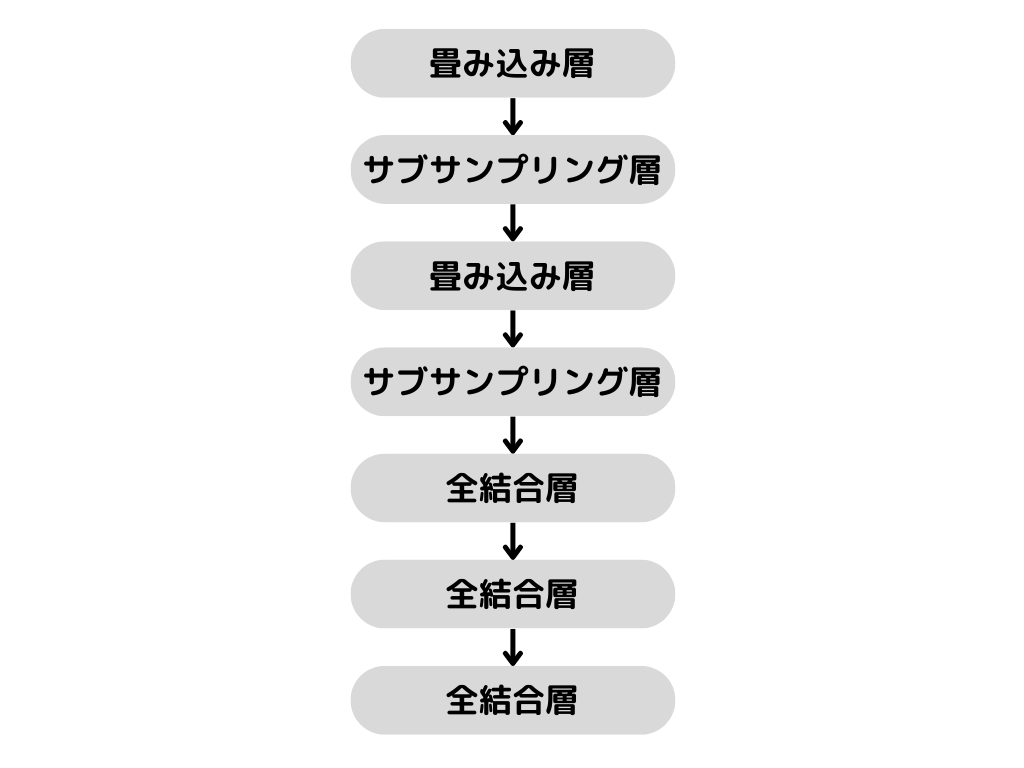
「畳み込み層→サブサンプリング層→畳み込み層→サブサンプリング層→全結合層」と、まさにCNNの基本に沿った構造ですね。
サブサンプリング層はプーリング層と同じ意味で、LeNetではこう呼ばれていました。
| モデル | 年 | 人物 | ポイント |
|---|---|---|---|
| ネオコグニトロン | 1979年 | 福島邦彦 | CNNの原型。S細胞とC細胞 |
| LeNet | 1989年 | ヤン・ルカン | 最初のCNN。誤差逆伝播法で学習 |
ネオコグニトロンは誤差逆伝播法を使わずに学習していた点が、LeNetとの大きな違いです。
軽量なCNN
スマホのような小さな端末でもCNNを動かせるように、計算量を減らす工夫が考えられてきました。
MobileNetとDepthwise Separable Convolution
MobileNetとは、スマホなどの小型端末でも動かせるように、計算量とパラメータを大きく減らした軽量なCNNです。
2017年にGoogleが発表しました。軽さの秘密が、次のDepthwise Separable Convolutionです。
Depthwise Separable Convolutionとは、普通の畳み込みを「空間方向の畳み込み」と「チャンネル方向の畳み込み」の2段階に分けて、計算量を減らす方法です。
- Depthwise Convolution:チャンネル(色や特徴マップ)ごとに別々に、縦横(空間)方向だけの畳み込みをする
- Pointwise Convolution:1×1のフィルタで、チャンネル方向だけをまとめる畳み込みをする
普通の畳み込みは、この2つを1回で同時に行っていました。
平たく言えば、1回で処理していた工程を2つに分けたことで、計算量とパラメータの数が大きく減ったんですね。
NASとMnasNet
NAS(Neural Architecture Search)とは、ニューラルネットワークの構造(層の数や種類、つなぎ方)を、人間の代わりに機械に自動で探させる方法です。
今までニューラルネットワークを作るには、手法の知識や最新技術の知識など、様々な能力が求められました。
つまり、分析者の腕に依存することが大きかったんですね。
NASでは、良い構造を機械が自動で探してくれます。CNNの「畳み込み」や「プーリング」をまとめた部品(セル)の構造を探すNASNetも有名です。
MnasNetとは、スマホでの処理速度(推論速度)も考えながら、NASで構造を探して作った軽量なCNNです。
2018年にGoogleが発表しました。精度だけでなく、実際の端末で速く動くかどうかも評価に入れたのがポイントです。
EfficientNet
EfficientNetとは、モデルの「深さ(層の数)」「幅(チャンネルの数)」「入力画像の大きさ(解像度)」を、バランスよく同時に大きくすることで、少ないパラメータで高い精度を出したCNNです。
2019年にGoogleが発表しました。
MnasNetと同じようにNASで見つけた土台のモデルを、3つの要素をバランスよく拡大して作っています。
既存のモデルより大幅に少ないパラメータで、当時の最高精度を達成しました。
| モデル | 年 | ポイント |
|---|---|---|
| MobileNet | 2017年 | Depthwise Separable Convolutionで軽量化 |
| NAS | 2016年〜 | ネットワークの構造を機械が自動で探す |
| MnasNet | 2018年 | スマホでの速度も考えてNASで設計 |
| EfficientNet | 2019年 | 深さ・幅・解像度をバランスよく拡大 |
G検定での問われ方|データ拡張の早見表
現行シラバスの「データ拡張」のキーワードを一言でまとめておきます。
| 用語 | 一言でいうと | 詳しい解説 |
|---|---|---|
| Contrast | 画像のコントラスト(明暗の差)を変えるデータ拡張 | この記事 |
| Brightness | 画像の明るさを変えるデータ拡張 | この記事 |
| Crop | 画像の一部を切り取るデータ拡張 | この記事 |
| CutMix | 画像の一部を別の画像で置き換え、ラベルも面積比で混ぜるデータ拡張 | この記事 |
| Cutout | 画像の一部を四角く隠す(塗りつぶす)データ拡張 | この記事 |
| Mixup | 2枚の画像とラベルを割合で混ぜ合わせるデータ拡張 | この記事 |
| noising | テキストの単語を削除・置換するなど、ノイズを加えるデータ拡張 | この記事 |
| paraphrasing | 文章を意味が同じ別の表現に言い換えるデータ拡張 | この記事 |
| RandAugment | たくさんの変換からランダムに選んで適用するデータ拡張。調整するパラメータが少ない | この記事 |
| Random Erasing | 画像の一部をランダムな値で塗りつぶすデータ拡張 | この記事 |
| Random Flip | 画像をランダムに左右(上下)反転するデータ拡張 | この記事 |
| Rotate | 画像を回転させるデータ拡張 | この記事 |
よくある質問
Q. 転移学習とファインチューニングの違いは?
転移学習は、学習済みモデルの最終出力層だけを入れ替えて学習し、それ以外の重みは更新しません。
ファインチューニングは、出力層の入れ替えに加えて、それ以外の層の重みも少しずつ更新します。
Q. MixupとCutMixの違いは?
Mixupは2枚の画像全体を、ある割合で半透明に重ねるように混ぜます。CutMixは、画像の一部を切り取って別の画像の一部を貼り付けます。
どちらも、正解ラベルも混ぜた割合に合わせて変えます。
Q. ネオコグニトロンとLeNetの違いは?
ネオコグニトロンは福島邦彦が発表したCNNの原型で、誤差逆伝播法を使わずに学習していました。
LeNetはヤン・ルカンらが発表した最初のCNNで、誤差逆伝播法で学習します。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- 転移学習は出力層だけを入れ替え、ファインチューニングは既存の重みも少しずつ更新する
- 破滅的忘却:新しい作業を学ぶと前の作業を忘れてしまう現象
- Few-shot学習は数個の例、One-shot学習は1つの例で新しい作業に対応させる
- データ拡張:Crop・Rotate・Random Flipなどの基本操作、Cutout・Random Erasing(隠す)、Mixup・CutMix(混ぜる)、RandAugment、テキストのnoising・paraphrasing
- CNNの原型はネオコグニトロン(福島邦彦)、最初のCNNはLeNet(ヤン・ルカン)。軽量なCNNはMobileNet・MnasNet・EfficientNet
次回は、ILSVRCで競い合ってきた画像分類の代表的なモデル(AlexNet・GoogLeNet・VGG・ResNet)をResNetとVGGの記事で解説していきます。覚える内容が多いですが、りけーこっとんも頑張ります!
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。
データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。