Grad-CAMとは?説明可能AIと蒸留・量子化(モデル軽量化)を解説
どーも、りけーこっとんです。
「Grad-CAMとLIMEとSHAP、どれも説明可能AIだけど何が違うの?」「蒸留・量子化・プルーニング、モデルを軽くする方法が3つあって混乱する」
このような、G検定のディープラーニングの最後の範囲で迷っている方はいないでしょうか?
この記事では、AIが「なぜその答えを出したのか」を見えるようにする説明可能AI(XAI)の手法と、スマホなどの小さな端末でもAIを動かせるようにするモデルの軽量化を解説します。どちらも実務でとても大事な技術なので、比較表で整理していきましょう。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- 説明可能AI(XAI)とは、AIがなぜその判断をしたのかを、人間が理解できるように説明する技術や考え方
- CAM・Grad-CAMは、画像のどこに注目して判断したかをヒートマップで示す。Grad-CAMは勾配を使うので多くのCNNに使える
- LIMEは予測の周りを単純なモデルで近似し、SHAPはゲーム理論のシャープレイ値で特徴量の貢献度を計算する
- モデルの軽量化には、蒸留(小さいモデルに教える)、量子化(数値のビット数を減らす)、プルーニング(不要な接続を削る)がある
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第6章「モデルの解釈性」「モデルの軽量化」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
Grad-CAMとは
Grad-CAMとは、画像認識のCNNが、画像のどの部分に注目して判断したのかを、勾配の情報を使ってヒートマップで見えるようにする手法です。Gradient-weighted Class Activation Mappingの略で、2017年に発表されました。
ディープラーニングは、構造が複雑すぎて「なぜその結果になったのか」が見えにくくなりがちですよね。画像認識でも、「なぜAIはこの画像を犬に分類したのか」が気になります。Grad-CAMを使うと、AIが特に注目した部分が赤く表示されるので、判断の理由がひと目で分かるんですね。
CAMとの違い
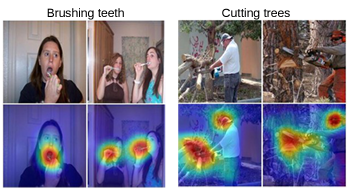
CAMとは、画像認識のCNNで、特定のクラスの判断に大きく関わった画像の領域をハイライトする手法です。Class Activation Mappingの略で、2016年に発表されました。イメージは次の図のような感じです。
引用:Learning Deep Features for Discriminative Localization(arXiv)
左は「なぜ歯磨きに分類したのか」、右は「なぜ木を切るに分類したのか」で、AIが注目した部分が赤くなっていますね。
ただしCAMは、ネットワークの最後がグローバルアベレージプーリング(GAP)になっている構造でしか使えませんでした(GAPはCNNの記事で解説しています)。Grad-CAMは、各特徴マップの重要度を「勾配」から計算するようにしたことで、構造を変えずに多くのCNNに使えるようになったのが違いです。画像分類だけでなく、画像の説明文を作るモデルなどにも使えます。
| 手法 | 使えるモデル | 重要度の求め方 |
|---|---|---|
| CAM | 最後がGAPになっているCNNだけ | GAPのあとの重み |
| Grad-CAM | 多くのCNN | 勾配の情報 |
説明可能AI(XAI)の手法
説明可能AI(XAI)とは、AIがなぜその予測や判断をしたのかを、人間が理解できる形で説明できるようにする技術や考え方のことです。Explainable AIの略です。
医療の診断やお金の貸し出しの審査のように、AIの判断が人の人生に大きく関わる場面では、「AIがそう言ったから」では納得できませんよね。AIの判断の理由が分かれば、間違いに気づいたり、偏った判断をしていないか確かめたりできます。そのため、ブラックボックスになりがちなAIの中身を説明する技術が重要になっているんですね。AIの透明性の考え方はAIのリスクと透明性の記事でも解説しています。
LIMEとは
LIMEとは、ある1つの予測について、その周りだけを線形回帰のような単純なモデルで近似し直すことで、どの特徴量が予測に効いたかを説明する手法です。Local Interpretable Model-agnostic Explanationsの略で、2016年に発表されました。
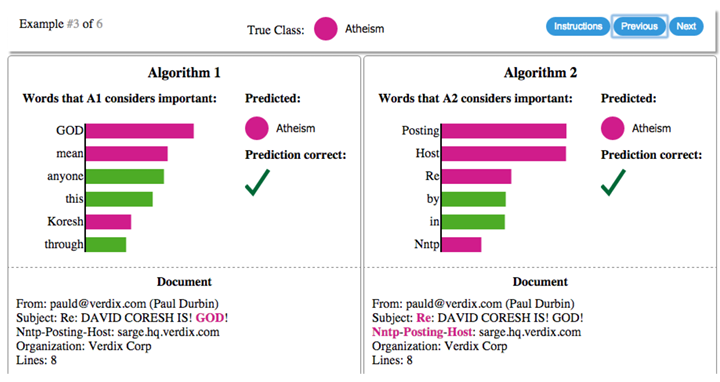
複雑なモデル全体を説明するのは難しいので、「この1件の予測の周りだけ」に注目して、分かりやすいモデルで置き換えるんですね。どんなモデルにも使え、画像でも文章でも使えます。可視化すると、次のような結果が得られます。
引用:“Why Should I Trust You?”: Explaining the Predictions of Any Classifier(arXiv)
これはメールの文面から「無神論」か「キリスト教」かを分類したときに、どの単語を根拠にしたかを示したものです。
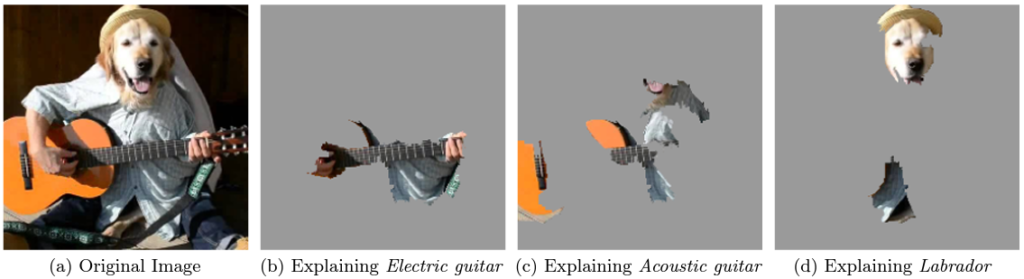
画像なら、次のように、どの部分を根拠に分類したかが分かります。
引用:“Why Should I Trust You?”: Explaining the Predictions of Any Classifier(arXiv)
とても便利ですが、近似した単純なモデルが、元のモデルと違う判断をしてしまうこともある点には注意が必要です。
SHAPとは
SHAPとは、協力ゲーム理論のシャープレイ値を使って、それぞれの特徴量が予測にどれだけ貢献したかを公平に計算する手法です。
SHapley Additive exPlanationsの略で、2017年にルンドバーグとリーが発表しました。
シャープレイ値は、チームで得た賞金を、各メンバーの貢献度に応じて公平に分けるための考え方です。SHAPでは、これを「予測値(と平均的な予測値の差)を、各特徴量の貢献度に応じて公平に分ける」ことに当てはめます。論文の図を見てみましょう。

引用:A Unified Approach to Interpreting Model Predictions(arXiv)
図のxが各特徴量、φがその特徴量の貢献度です。
平均的な予測値(E[f(z)])から、特徴量ごとの貢献度を足していくと、最終的な予測値f(x)になります。
φが大きいほど、その特徴量の影響が大きいということですね。周りの知り合いの実務でも、モデルの説明に使っていると聞くことが多い手法です。
Permutation Importanceとは
Permutation Importanceとは、ある特徴量の値だけをデータの中でバラバラに並べ替えたときに、予測の精度がどれだけ落ちるかで、その特徴量の重要度を測る方法です。
大事な特徴量の値をデタラメにすると、予測が大きく外れるようになりますよね。
逆に、並べ替えても精度がほとんど変わらなければ、その特徴量はあまり使われていないと分かります。
モデルの中身を見なくても計算できる、シンプルな方法です。
| 手法 | 何を説明するか | ポイント |
|---|---|---|
| CAM・Grad-CAM | 画像のどこに注目したか | ヒートマップで表示。主に画像認識 |
| LIME | 1件の予測で効いた特徴量 | 周りを単純なモデルで近似 |
| SHAP | 各特徴量の予測への貢献度 | シャープレイ値(ゲーム理論) |
| Permutation Importance | モデル全体での特徴量の重要度 | 値を並べ替えて精度の低下を見る |
G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。

エッジAIとモデルの軽量化(モデル圧縮)
エッジAIとは
エッジAIとは、スマホやカメラ、IoT機器などの端末(エッジ)にAIを載せて、その端末の中で推論を行う技術のことです。
これまでは、端末で集めたデータをインターネットでクラウドに送り、クラウドのAIで処理して結果を返すクラウドAIが一般的でした。
でも、データを毎回送ると、通信に時間がかかったり、通信費がかかったり、個人情報が漏れる心配があったりしますよね。
そこで、端末の中で処理を完結させるのがエッジAIです。次のようなメリットがあります。
- 通信を待たないので、速く、遅れが少ない(自動運転などで重要)
- 通信の費用を減らせる
- データを外に送らないので、プライバシーやセキュリティの面で安心
ただし、端末はクラウドのコンピュータほど計算の力もメモリもありません。そこで、モデルを小さく軽くするモデル圧縮の技術が必要になります。代表的なのが、次の3つです。
蒸留とは
蒸留とは、大きくて性能の高い学習済みのモデル(教師モデル)の出力をお手本にして、小さいモデル(生徒モデル)を学習させることで、軽くて性能の良いモデルを作る方法です。
知識蒸留とも言います。2015年にジェフリー・ヒントンらが提案しました。
生徒モデルは、正解のラベルだけでなく、教師モデルが出した「犬0.7、猫0.2、狐0.1」のような確率の出し方まで学びます。
「犬だけど、少し猫にも似ている」という教師モデルの知識まで受け継げるので、小さいモデルでも高い性能が出せるんですね。
転移学習やファインチューニングと似ていますが、目的が「モデルを軽くすること」である点が違います(転移学習の記事で比べています)。
量子化とは
量子化とは、モデルの重みなどの数値を、より少ないビット数で表すことで、モデルを軽くする方法です。
ふつう、ニューラルネットワークの数値は32ビットで表されています。これを8ビットなどに減らすと、ネットワークの構造は変えずに、データの量を大幅に減らせるんですね。
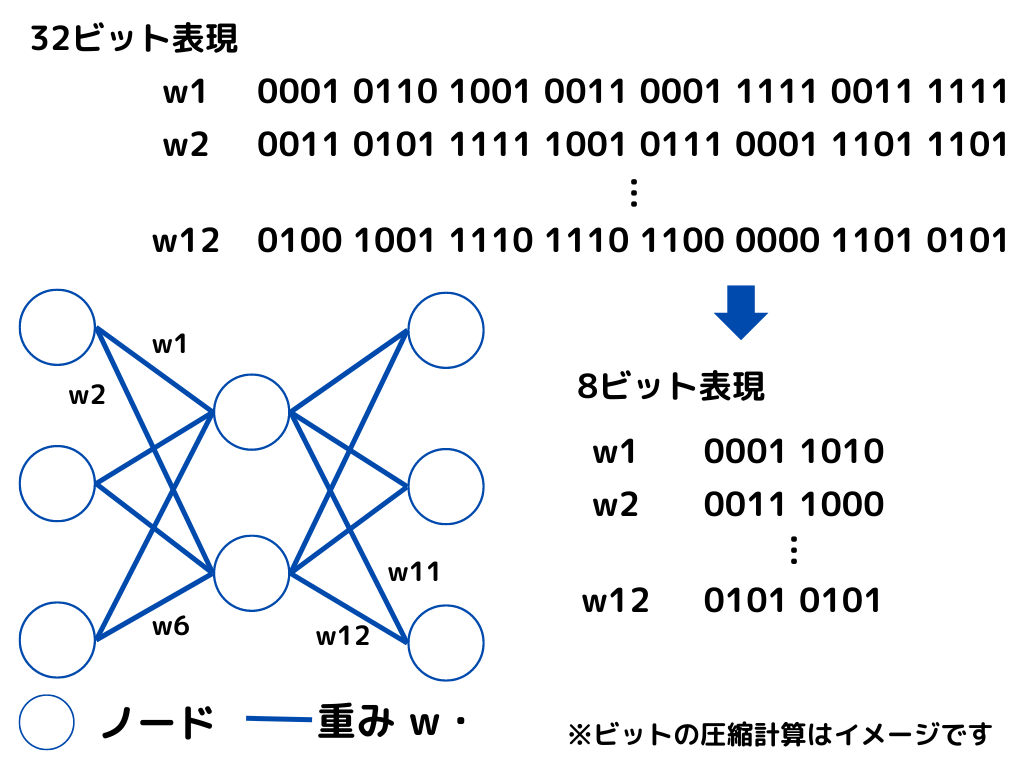
ただし、表せる数値の細かさが減るぶん、精度が少し落ちることがあるので注意が必要です。
音声処理のA-D変換に出てきた「量子化」とは意味が違うので、混同しないようにしましょう。
プルーニングと宝くじ仮説
プルーニングとは、学習したニューラルネットワークから、重みが小さく結果にあまり影響しない接続やノードを取り除いて、モデルを軽くする方法です。
枝刈りとも言います。
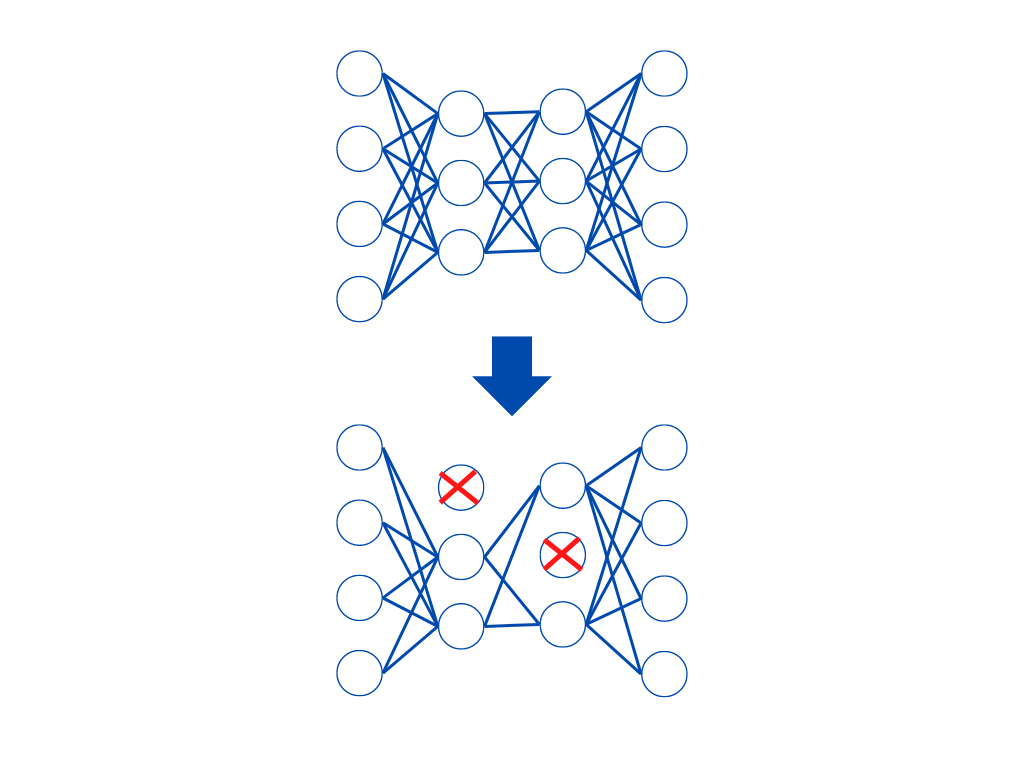
よく似た言葉にドロップアウトがありますが、目的が違います(ドロップアウトの記事で解説しています)。
- ドロップアウト:過学習を防いで精度を上げるため。学習のたびに違うノードをランダムに無効にし、予測のときはすべて使う
- プルーニング:モデルを軽くするため。重みの小さい接続を選んで、ずっと取り除いたままにする
宝くじ仮説とは、大きなニューラルネットワークの中には、最初からうまく学習できる小さなネットワーク(当たりくじ)が含まれていて、それだけを取り出して学習しても元と同じくらいの精度が出せる、という仮説です。
2019年に発表されました。プルーニングで小さくしても精度があまり落ちない理由を説明する考え方として注目されています。
| 手法 | やること | ポイント |
|---|---|---|
| 蒸留 | 大きいモデルの出力をお手本に小さいモデルを学習 | 教師モデルと生徒モデル |
| 量子化 | 数値のビット数を減らす(32ビット→8ビットなど) | 構造はそのまま |
| プルーニング | 重みの小さい接続を取り除く | 宝くじ仮説 |
モデルの解釈性と軽量化の早見表
現行シラバスの「モデルの解釈性」と「モデルの軽量化」のキーワードを一言でまとめておきます。
| 用語 | 一言でいうと | 詳しい解説 |
|---|---|---|
| CAM | 画像のどこに注目して判断したかを、ヒートマップで可視化する手法 | この記事 |
| Grad-CAM | 勾配を使ってCAMを一般化し、さまざまなCNNで注目箇所を可視化できるようにした手法 | この記事 |
| LIME | 1つの予測の周りで単純なモデルを作り、その予測の理由を近似的に説明する手法 | この記事 |
| Permutation Importance | ある特徴量の値をシャッフルしたときに精度がどれだけ下がるかで、その特徴量の重要度を測る手法 | この記事 |
| SHAP | ゲーム理論のシャープレイ値を使い、各特徴量が予測にどれだけ貢献したかを示す手法 | この記事 |
| 説明可能AI(XAI) | AIが判断した理由を人が理解できるようにする技術や研究 | この記事 |
| エッジAI | クラウドではなく、スマホやカメラなどの端末側でAIを動かすこと | この記事 |
| 蒸留 | 大きな教師モデルの出力をまねるように小さな生徒モデルを学習させ、軽量化する方法 | この記事 |
| 宝くじ仮説 | 大きなネットワークの中には、単独で学習しても同じくらいの性能を出せる小さな部分ネットワーク(当たりくじ)が含まれているという仮説 | この記事 |
| プルーニング | 影響の小さい重みや接続を削除してモデルを軽くする方法(枝刈り) | この記事 |
| モデル圧縮 | 精度をなるべく保ったままモデルを小さく軽くする技術の総称。蒸留・量子化・プルーニングなど | この記事 |
| 量子化 | 重みを32ビットから8ビットなどの少ないビット数で表し、モデルを軽くする方法 | この記事 |
よくある質問
Q. CAMとGrad-CAMの違いは?
どちらも画像のどこに注目して判断したかをヒートマップで示します。CAMは最後がグローバルアベレージプーリングになっているCNNでしか使えませんが、Grad-CAMは勾配の情報を使うので、構造を変えずに多くのCNNに使えます。
Q. LIMEとSHAPの違いは?
LIMEは、1つの予測の周りを線形回帰のような単純なモデルで近似して、効いた特徴量を説明します。SHAPは、協力ゲーム理論のシャープレイ値を使って、各特徴量の貢献度を公平に計算します。
Q. プルーニングとドロップアウトの違いは?
目的が違います。ドロップアウトは過学習を防ぐために、学習のたびにランダムにノードを無効にします。プルーニングはモデルを軽くするために、重みの小さい接続を選んで取り除き、取り除いたままにします。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- 説明可能AI(XAI):AIの判断の理由を人間が理解できるように説明する技術
- CAMは最後がGAPのCNNだけ、Grad-CAM(2017年)は勾配を使って多くのCNNで注目領域を示せる
- LIMEは予測の周りを単純なモデルで近似、SHAP(2017年)はシャープレイ値、Permutation Importanceは値を並べ替えて重要度を測る
- エッジAI:端末の中で推論する。速い・通信費が減る・プライバシーに強いが、モデルの軽量化が必要
- モデル圧縮:蒸留(小さいモデルに教える)、量子化(ビット数を減らす)、プルーニング(接続を削る・宝くじ仮説)
これで「ディープラーニングの応用例」の章は終わりです。次回からは、AIを実際のビジネスや社会でどう使っていくか、「AIの社会実装」の章に入っていきます。G検定の範囲全体はAIの定義の記事から順番に見直せるので、試験前の復習にも使ってみてください。
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。