混同行列とは?適合率・再現率・F値・ROC曲線をわかりやすく解説
どーも、りけーこっとんです。
「適合率と再現率、どっちがどっちだっけ?」「ROC曲線とAUCの関係がいまいち分からない」このような、G検定の評価指標でつまずいている方はいないでしょうか?
この記事では、分類問題で使う混同行列と4つの指標、ROC曲線とAUC、回帰問題で使うMSE・RMSE・MAEまでを、具体例と早見表で整理していきます。
合格に向けては必須の基礎知識で、これから先の機械学習の理解にも欠かせない内容なので、しっかり押さえておきましょう。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- 混同行列とは、分類問題の精度評価指標の一種。予測と実際の組み合わせ(真陽性・偽陽性・偽陰性・真陰性)を表にしたもの
- 適合率は「モデルの予測で陽性と判断した中で、どれだけ当たっていたか」、再現率は「実際の値が陽性の中で、どれだけ当たっていたか」
- ROC曲線の下の面積がAUC。1に近いほど良く、0.5はでたらめに予測しているのと同じ
- 回帰問題ではMSE(残差を二乗したものの平均)、RMSE(MSEの平方根)、MAE(残差の絶対値の平均)を使う
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第3章「機械学習の概要」の「モデルの選択・評価」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
- 紙で手元に置きたい方は → G検定カンペの印刷用PDF(無料・A4・15ページ)をダウンロードできます
モデルの評価とは|精度評価指標はどこで使われるのか
モデルの評価というのは、「作成したモデルが教師データや未知データに、どれだけ精度良く一致したか」を測るものです。
精度評価指標は、基本的には教師あり学習で用いられます。教師あり学習の概要を以下に示しますね。
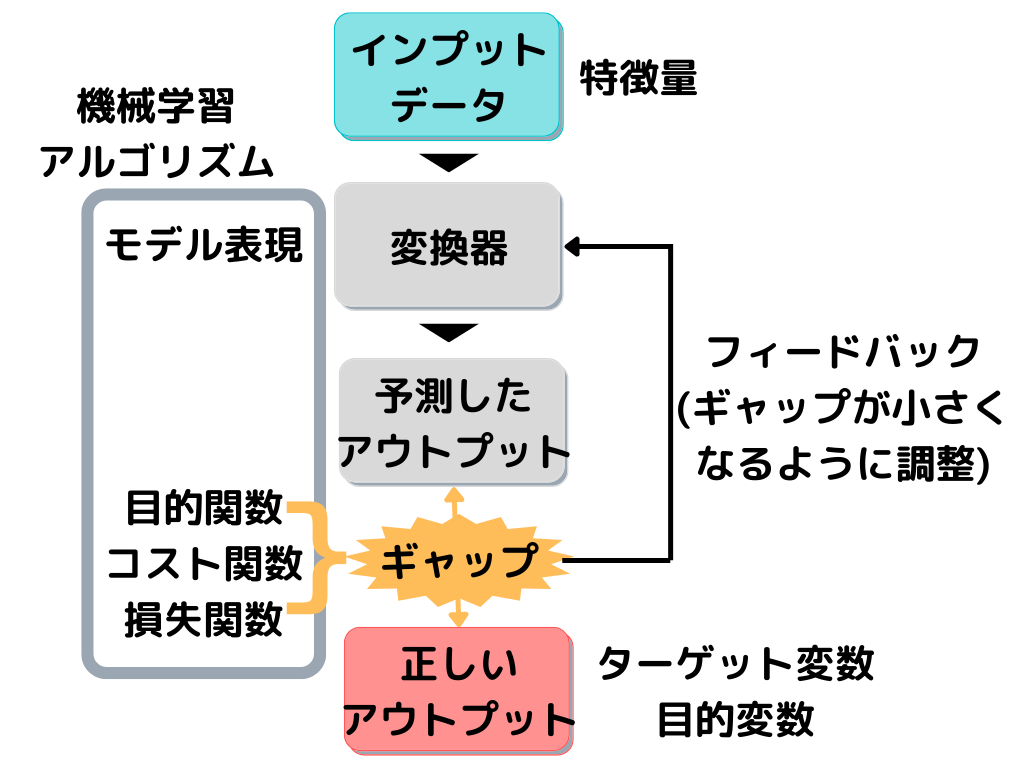
この図の「ギャップ」とある部分に、以下で紹介する精度評価指標が用いられます。
精度評価指標で出た「ギャップ(誤差)」が小さくなるように「変換器」を調整して、もう一回予測。これを繰り返すことで、精度を高めて(ギャップを小さくして)いきます。
教師あり学習には、解きたい問題によって分類問題と回帰問題の2種類がありましたよね。
それぞれの問題によって評価指標は異なるものを使用します。
結果の値が飛び飛びの値(カテゴリ)だったり、連続値だったりするので、評価指標も変えていかなければいけません。分類と回帰の違いは教師あり学習の記事で解説しています。
まずは、分類問題についての評価指標から見ていきましょう。
混同行列とは
混同行列とは、分類問題の精度評価指標の一種で、予測値と実際の値の組み合わせを表にしたものです。
英語ではConfusion Matrixといいます。
二値の分類問題を評価したいときには、以下のような2行×2列の行列を作成します。
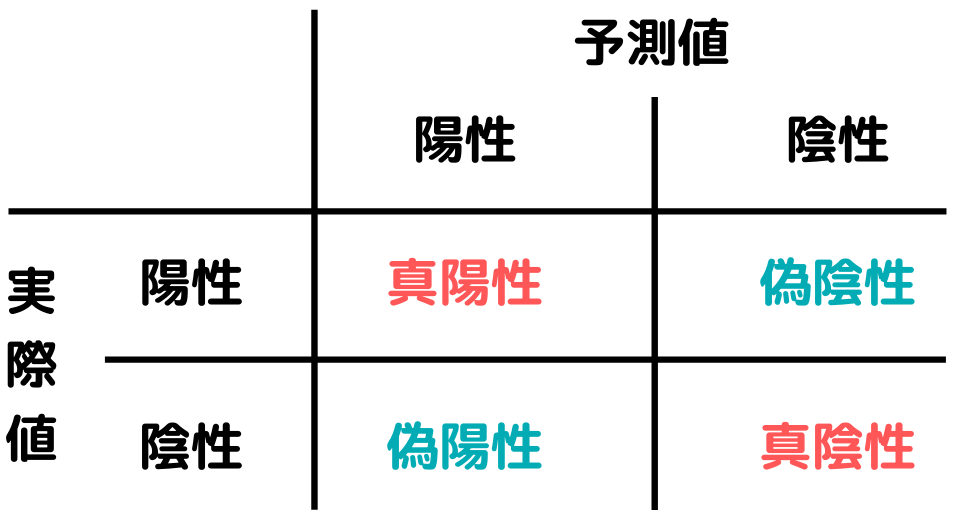
| 予測:陽性 | 予測:陰性 | |
|---|---|---|
| 実際:陽性 | 真陽性(TP) | 偽陰性(FN) |
| 実際:陰性 | 偽陽性(FP) | 真陰性(TN) |
真陽性・真陰性と偽陽性・偽陰性
予測値が実際のデータと一致していれば、真陽性・真陰性といいます。
そして、予測では陽性といっているのに実際には陰性であること(混同行列の左下)を偽陽性、予測では陰性といっているのに実際には陽性であること(混同行列の右上)を偽陰性といいます。
特に偽陽性と偽陰性がよくごっちゃになるので、しっかり覚えたいですね。
予測値が陽性と出したものには「陽性」と付きます。
この「陽性」が嘘か本当か、という意味で捉えると分かりやすくなるのではないでしょうか。
実務では、偽陽性は誤検知、偽陰性は見逃しと言い換えると、どちらが困るのかを考えやすくなりますよ。
正解率・適合率・再現率・F値
混同行列を作って何をしたいかというと、以下のような指標を考えるためです。
| 指標 | 意味 | 計算式 |
|---|---|---|
| 正解率(Accuracy) | 全データの中で、陽性・陰性をどれだけ正確に判定できたか | (TP+TN)÷ 全体 |
| 適合率(Precision) | モデルが陽性と判断した中で、どれだけ当たっていたか | TP ÷(TP+FP) |
| 再現率(Recall) | 実際の値が陽性の中で、どれだけ当たっていたか | TP ÷(TP+FN) |
| F値 | 再現率と適合率の調和平均 | 2×適合率×再現率 ÷(適合率+再現率) |
正解率
正解率(Accuracy)とは、全データの中で「陽性・陰性」をどれだけ正確に判定できたかの指標です。
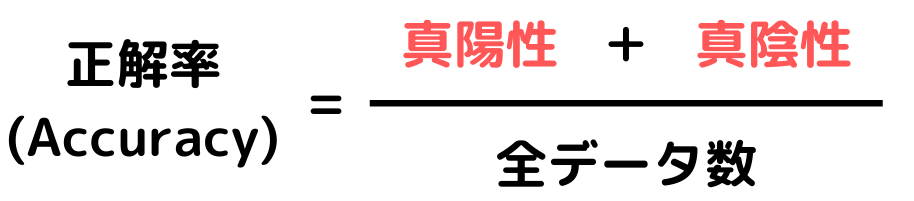
一番分かりやすい指標ですが、陽性と陰性の数が大きく偏ったデータでは注意が必要です。
たとえば100人のうち病気の人が5人しかいないデータで、モデルが「全員健康」と予測すると、病気の5人を全員見逃しているのに正解率は95%になってしまいます。
適合率
適合率(Precision)とは、モデルの予測で「陽性」と判断した中で、どれだけ当たっていたかの指標です。
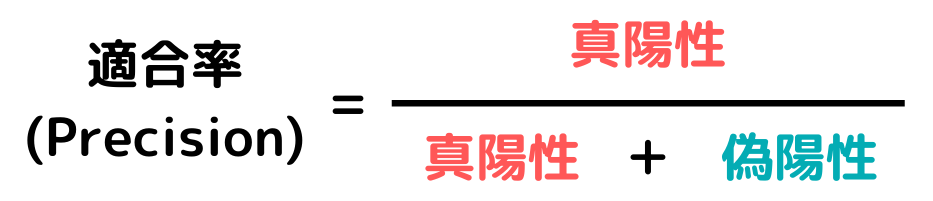
モデルの予測が実際の値にどれだけ「適合」したか、という意味で「適合」率といえるのではないでしょうか。
誤検知(偽陽性)を減らしたいときに重視する指標です。
再現率
再現率(Recall)とは、実際の値が「陽性」の中で、どれだけ当たっていたかの指標です。
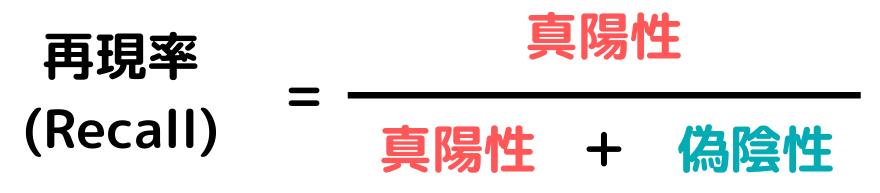
実際の値をモデルの予測がどれだけ「再現」できたか、という意味で「再現」率といえるのではないでしょうか。見逃し(偽陰性)を減らしたいときに重視する指標です。
F値
F値とは、再現率と適合率の調和平均です。
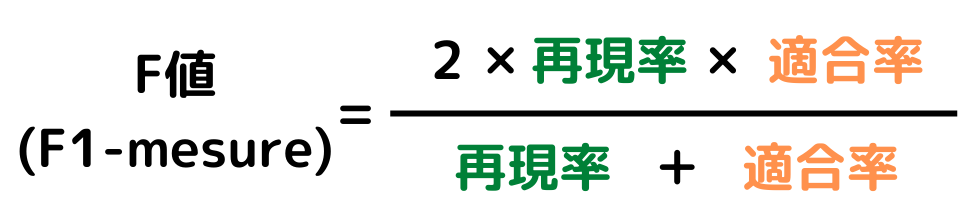
調和平均なので、どちらか片方が極端に低いとF値も低くなります。適合率と再現率は、片方を上げるともう片方が下がりやすいトレードオフの関係にあるので、両方のバランスを見たいときに使います。
適合率と再現率の使い分け
このそれぞれの指標を見ることで、モデルがどれだけ正確に予測できるのかを見ることができます。
適合率と再現率は間違えがちなので、しっかり覚えたいですね。G検定では「どちらを重視するべき場面か」がよく問われます。
| 場面 | 重視する指標 | 理由 |
|---|---|---|
| がん検診・不良品の検出 | 再現率 | 見逃し(偽陰性)が致命的。多少の誤検知は再検査で済む |
| 迷惑メールの判定 | 適合率 | 大事なメールを迷惑メール扱いする誤検知(偽陽性)を避けたい |
| 両方バランスよく見たい | F値 | 適合率と再現率はトレードオフの関係にあるため |
具体例で計算してみよう
病気の検査を100人に行ったところ、次のような結果になったとします。
| 予測:陽性 | 予測:陰性 | |
|---|---|---|
| 実際:陽性 | TP=40人 | FN=10人 |
| 実際:陰性 | FP=20人 | TN=30人 |
- 正解率:(40+30)÷ 100 = 70%
- 適合率:40 ÷(40+20)= 約66.7%
- 再現率:40 ÷(40+10)= 80%
- F値:2 × 0.667 × 0.8 ÷(0.667+0.8)= 約0.73
混同行列の数字から指標を計算させる問題も出ます。適合率は予測が陽性の列、再現率は実際が陽性の行を分母にする、と覚えておくと速く解けますよ。
ROC曲線とAUC
ROC曲線とAUCを分かりやすくするために、作り方から順に説明します。ROC曲線やAUCはどうやって作っていくのか、そのやり方を以下に書きますね。
- 閾値を決め、真陽性率・偽陽性率を計算
- 横軸:偽陽性率、縦軸:感度(真陽性率)のグラフにプロット
- 閾値を変更する
- 1〜3を繰り返す
偽陽性率と感度の式に関しては、以下に示します。
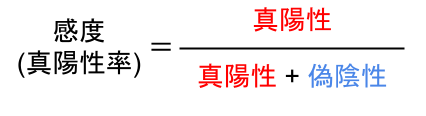
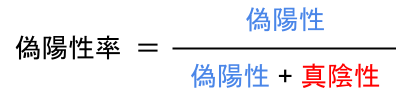
感度(真陽性率)の式、どこかで見たことありませんか?実は、再現率と同じ式なんです。
さらに偽陽性率とは、混同行列でいう「実際の値が”陰性”の中で、どれだけ間違っていたか」を示す指標です(紛らわしいですよね)。
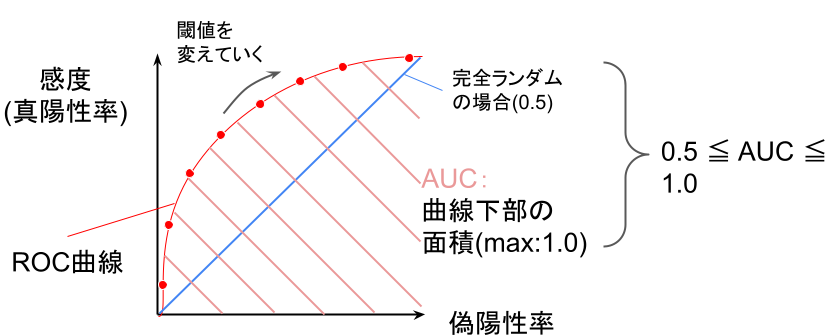
そしてROCとAUCを図示すると、以下のようになります。
ROC曲線とは
ROC曲線とは、上図の赤い曲線のことで、閾値を変えながら横軸に偽陽性率、縦軸に真陽性率をとってプロットした曲線です。
軸を逆に覚えないよう、横軸が偽陽性率と押さえておきましょう。
AUCとは
AUCとは、上図の赤い斜線で示される面積、つまりROC曲線の下側の面積のことです。
- AUCが1に近いほど、性能の良いモデル
- AUCが0.5だと、でたらめに予測しているのと同じ
AUCは閾値に左右されないので、モデル同士を比べるときによく使われます。
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

回帰問題の精度評価指標|MSE・RMSE・MAE
先ほどまで、分類問題の指標を見てきました。そして教師あり学習には、もう一つ回帰問題がありました。
結果の値が連続値になるような問題でしたね。精度評価指標には以下の3つが代表例です。現行シラバスでも「モデルの選択・評価」のキーワードになっています。
平均二乗誤差(MSE)とは
MSE(Mean Squared Error、平均二乗誤差)とは、以下の式で表される誤差のことで、つまりは残差を二乗したものの平均です。
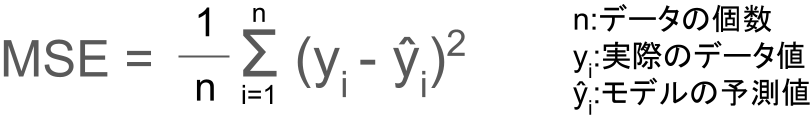
MSEが小さくなるということは、残差が小さくなるので、より良いモデルと言えそうですよね。
2乗するので、大きく外れた予測があると値が一気に大きくなる、外れ値に厳しい指標です。
二乗平均平方根誤差(RMSE)とは
RMSE(Root Mean Squared Error、二乗平均平方根誤差)とは、以下の式で表される誤差のことで、単純にMSEの平方根を求めたものです。
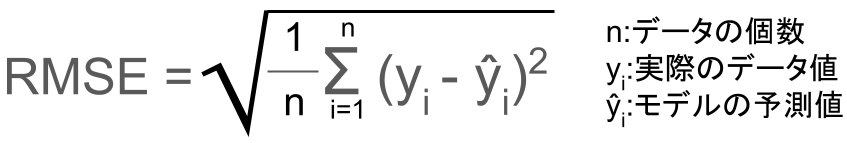
MSEだと二乗されているので値が大きくなりがちで、単位も二乗されてしまっています。RMSEは元の単位で表したいときなどに使えるようですね。
平均絶対値誤差(MAE)とは
MAE(Mean Absolute Error、平均絶対値誤差)とは、以下の式で表される誤差のことで、残差の絶対値の平均を取ったものです。
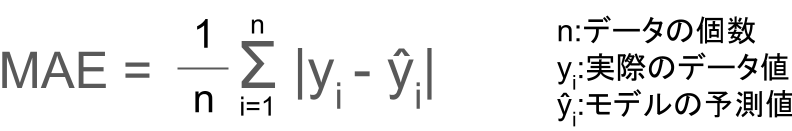
2乗しないので、MSEやRMSEに比べて外れ値の影響を受けにくいのが特徴です。実務では、外れ値をどれだけ重く見たいかでRMSEとMAEを使い分けることが多いですね。
この記事に関係するシラバスのほかのキーワード
現行シラバスの「モデルの選択・評価」には、評価指標のほかに検証方法やモデル選択のキーワードも含まれています。
それぞれ別の記事で詳しく解説しているので、ここでは一言で押さえておきましょう。
| キーワード | ひとことで言うと |
|---|---|
| 過学習 | 訓練データに合わせすぎて、未知のデータでの性能が落ちること(過学習の記事) |
| 汎化性能 | 学習に使っていない未知のデータに対する性能。これを高めるのが機械学習の目的(交差検証の記事) |
| ホールドアウト検証 | データを学習用とテスト用に1回だけ分けて評価する方法(交差検証の記事) |
| 交差検証 | データの分け方を変えながら何度も評価して、性能を公平に測る方法(交差検証の記事) |
| k-分割交差検証 | データをk個に分け、テスト役を入れ替えながらk回評価して平均する交差検証(交差検証の記事) |
| 赤池情報量規準(AIC) | 当てはまりの良さとモデルの複雑さのバランスを見る指標。小さいほど良い(AICの記事) |
| ベイズ情報量規準(BIC) | AICより複雑さへのペナルティが強い指標。小さいほど良い(AICの記事) |
| オッカムの剃刀 | 同じくらい説明できるなら、より単純なモデルを選ぶべきという考え方(AICの記事) |
評価指標の早見表
本番で迷ったときは、この表で確認してください。
| 指標 | 問題の種類 | 一言でいうと |
|---|---|---|
| 正解率 | 分類 | 全体で当たった割合。偏ったデータでは当てにならない |
| 適合率 | 分類 | 陽性と判断した中で当たった割合。誤検知を減らしたいとき |
| 再現率(感度) | 分類 | 実際の陽性の中で当たった割合。見逃しを減らしたいとき |
| F値 | 分類 | 再現率と適合率の調和平均 |
| AUC | 分類 | ROC曲線の下の面積。1に近いほど良い、0.5はでたらめ |
| MSE(平均二乗誤差) | 回帰 | 残差を二乗したものの平均。外れ値に厳しい |
| RMSE(二乗平均平方根誤差) | 回帰 | MSEの平方根。元の単位で読める |
| MAE(平均絶対値誤差) | 回帰 | 残差の絶対値の平均。外れ値に強い |
よくある質問
Q. 適合率と再現率はどちらが大事ですか?
どちらが大事かは目的で決まります。
見逃しが致命的な場面(病気の検査、不良品の検出)では再現率、誤検知を避けたい場面(迷惑メールの判定)では適合率を重視します。
両方のバランスを見たいときはF値を使います。
Q. AUCが0.5だとどういう意味ですか?
AUCが0.5のモデルは、陽性と陰性をランダムに当てているのと同じ性能です。
1に近いほど良いモデルで、0.5を下回る場合は予測が逆になっている可能性があります。
Q. MSEとMAEはどう使い分けますか?
大きく外れた予測を特に問題にしたいならMSE(またはRMSE)、外れ値に引っ張られずに平均的なずれを見たいならMAEが向いています。
RMSEとMAEは元のデータと同じ単位で読めるので、報告用にはこの2つがよく使われます。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- 混同行列:分類問題の精度評価指標の一種。真陽性・偽陽性・偽陰性・真陰性の表
- 正解率:全データの中でどれだけ正確に判定できたか
- 適合率:陽性と判断した中でどれだけ当たっていたか(誤検知を減らしたいとき)
- 再現率:実際の陽性の中でどれだけ当たっていたか(見逃しを減らしたいとき)
- F値は再現率と適合率の調和平均。ROC曲線の下の面積がAUC
- 回帰はMSE・RMSE・MAE。「正解率・適合率・再現率」は「どれがどれだっけ?」となりがちなので、しっかり覚えましょう
評価指標の次は、モデルの良し悪しを公平に測るための検証方法です。
交差検証やホールドアウト検証、誤差関数、正則化は交差検証と正則化の記事で、AICや第一種・第二種の過誤はAICとオッカムの剃刀の記事で解説しています。
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。