教師あり学習とは?回帰分析・重回帰分析・線形回帰・決定木・疑似相関を解説
どーも、りけーこっとんです。
「回帰と分類って、どうやって見分ければいいの?」「決定木のジニ係数、式を見ても意味が分からない」このような、G検定で機械学習の手法に入ったばかりの方はいないでしょうか?
この記事から、いよいよ前半のメインパート「機械学習の具体的な手法」に入っていきます。
まずは教師あり学習の全体像、分類問題と回帰問題の違い、回帰分析と最小二乗法、決定木、そして実務で一番多い落とし穴の疑似相関を解説します。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- 教師あり学習とは、正解データ(教師データ)に予測を近づけるように学習する機械学習の手法
- 出力が飛び飛びのカテゴリなら分類問題、連続した数値なら回帰問題
- 線形回帰は、残差二乗和が最小になる直線を最小二乗法で求める
- 決定木は、ジニ係数などで「分けたあとの純度」が高くなるようにデータを分けていく
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第3章「機械学習の概要」の「教師あり学習」、第8章「AIに必要な数理・統計知識」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
教師あり学習とは
教師あり学習とは、教師データ(正解データ)に、学習の結果を近づけようとする機械学習の手法です。
教師データとは、あらかじめ人間が用意した正解付きのデータのことです。
例えば犬と猫の画像があったとしましょう。人間が「これは犬」「これは猫」と正解を付けて用意した画像が「教師データ」です。
機械が画像に何が写っているかを予測した結果、犬を犬、猫を猫と出せるようにしたいのが、教師あり学習ですね。
全体的な構成は次の図の通りです。
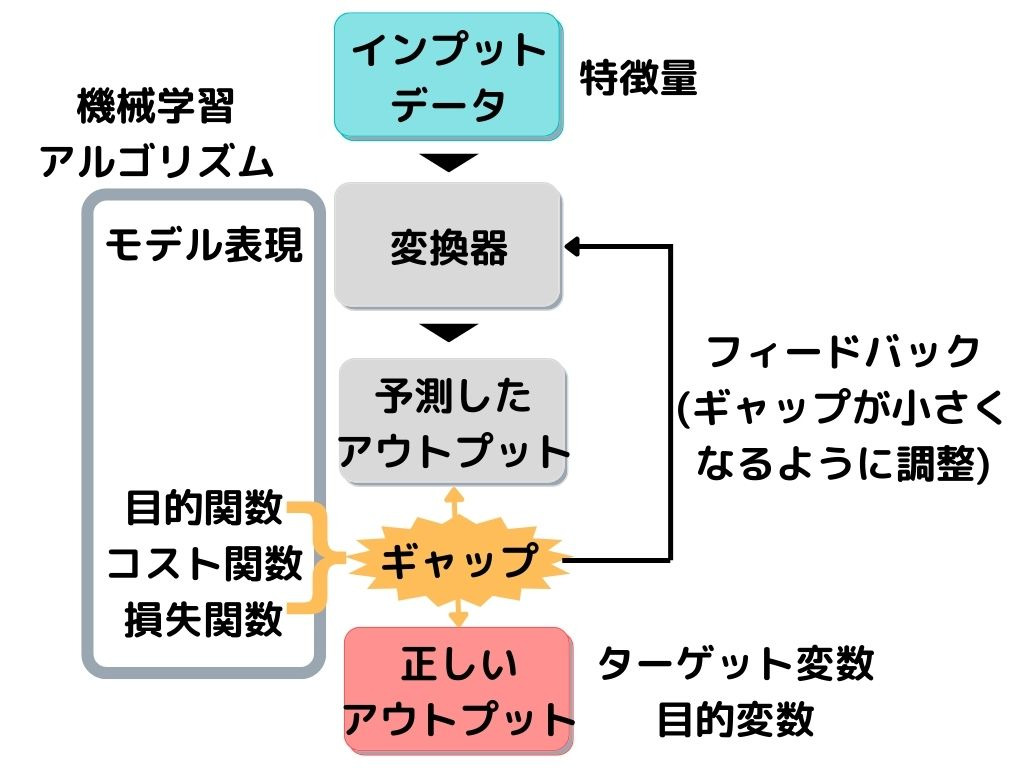
教師データは、上の図で言うと「正しいアウトプット」に相当します。
変換器が「予測したアウトプット」と「正しいアウトプット」のギャップ(誤差)を埋めるために、何回も調整(学習)するのが教師あり学習です。
図の用語は、専門用語では次のように呼ばれます。
| 図の言葉 | 専門用語 |
|---|---|
| 変換器に入力するデータ | 特徴量(説明変数) |
| 正しいアウトプット | 目的変数(ターゲット変数) |
| 変換器 | モデル表現 |
| ギャップや誤差 | 目的関数・コスト関数・損失関数 |
| モデル表現と目的関数を合わせたもの | 機械学習アルゴリズム |
これから出てくる手法は、すべて「変換器(モデル表現)」の部分です。ちなみにりけーこっとんは、よく目的関数と目的変数がごっちゃになります。
目的変数は「当てたい値」、目的関数は「どれだけ外れたかを測る式」と区別しておきましょう。
分類問題と回帰問題の違い
教師あり学習を行うときに、解決したい問題は次の2種類に分けることができます。
- 分類問題
- 回帰問題
分類問題とは
分類問題とは、出力が有限個の離散カテゴリである問題のことです。
離散カテゴリというのは「国・都道府県・人名・5段階評価」といった、飛び飛びになっている種類のデータのことです。
例えば「このメールは迷惑メールか」「この写真に写っているのは犬か猫か」などは、出力(出る結果)がカテゴリの名前ですよね。これらは分類問題と呼ばれます。
さらに「迷惑メールか、そうでないか」のように出力が2つに限られる問題を2クラス分類、「犬・猫・鳥のどれか」のように出力が3つ以上ある問題を多クラス分類と言います。
回帰問題とは
回帰問題とは、出力値が連続値である問題のことです。
こちらの方がイメージはしやすいかもしれません。例えば「1年後の身長の予測」「明日の売上の予測」みたいな問題ですね。
身長や売上は飛び飛びの値にはならず、小数点以下までの数字もあり得ます。そのため、こうした問題は回帰問題です。
| 比べるところ | 分類問題 | 回帰問題 |
|---|---|---|
| 出力 | カテゴリ(離散値) | 数値(連続値) |
| 例 | 迷惑メールかどうか、犬か猫か | 身長、売上、気温 |
| 見分け方 | 答えが「どれか」 | 答えが「いくつ」 |
見分けるときは、出力が離散値か連続値かだけを見ればOKです。
「病気にかかる確率は何%か」のように、出力が数値でも中身はカテゴリの確率、という問題もあります。
この場合はロジスティック回帰のように「名前は回帰でも分類の手法」を使うことが多いので、ロジスティック回帰の記事で確認しておきましょう。
線形回帰と最小二乗法
回帰分析とは
回帰分析とは、ある変数xと、それに関係のある連続値yの関係を数式で表し、予測・説明することです。
変数には色々なものが入ります。例えば「身長と体重の関係」を知りたければ、「身長」「体重」が変数となりますね。よく次の図のようなイメージで表されます。
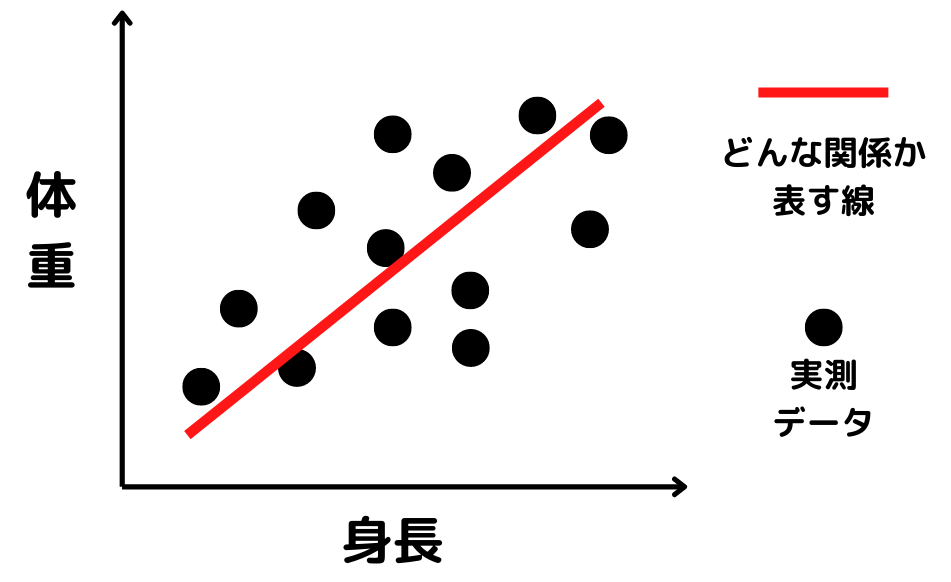
まず図の赤線の式を求めます。式で書けると、「身長」「体重」にどんな関係があるのか説明できるようになるんですね。
さらに、未知のデータが来ても身長が分かれば体重を求められる、という「予測」もできるようになります。
単回帰分析と重回帰分析
単回帰分析とは、1つの説明変数(特徴量)で回帰分析を行うことです。上の「身長から体重を予測する」みたいな感じですね。
重回帰分析とは、2つ以上の説明変数(特徴量)で回帰分析を行うことです。
2つの違いは説明変数の数だけです。単回帰分析なんて現実問題ほぼ無くない?と思った方は鋭いですね。実際、分析モデルの構築などの実務で使う回帰モデルはほとんど重回帰分析です。
例えば「売上」を「立地」「商品数」「清潔さ」という説明変数で説明、予測するというような感じですね。
一方で単回帰分析を侮るなかれ!
ビジネスの説明の場では「ざっくり右肩上がり?下がり?」みたいな説明で単回帰を使ったりもするので、知っておいて損はありません。
線形回帰とは
線形回帰とは、説明変数と目的変数の間に、直線(線形)の関係があると仮定した回帰分析です。
さっきの「身長と体重の関係」の例のようなものです。線形の関係というのは、一直線の線を引ける関係のこと。曲がった線でしか関係を表せないときは、線形の関係とは言えません。
最小二乗法とは
最小二乗法とは、残差二乗和が最小になるような直線を探す方法です。
簡単に言うと、全てのデータからの距離が一番近くなるような線を引こう!ということです。
残差とは、実際のデータと直線の予測値とのズレのことで、残差二乗和はイメージにするとこんな感じです。
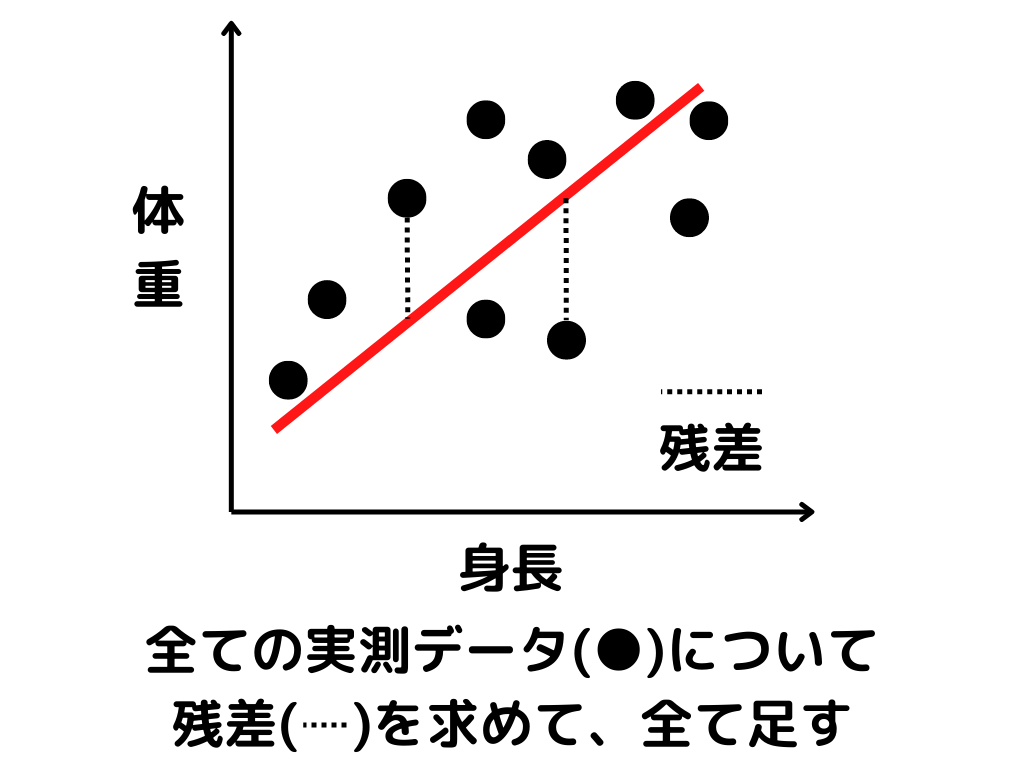
式は次のような感じです。
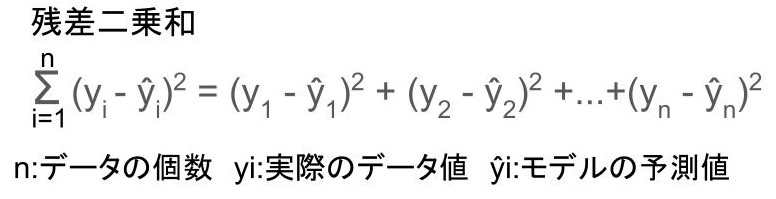
ズレをそのまま足すと、プラスとマイナスで打ち消し合ってしまいますよね。そこで二乗してから足すことで、ズレの大きさだけを合計しているんです。
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

決定木とは
決定木とは、データを分類する条件を木のように枝分かれさせて、予測を行うモデルのことです。
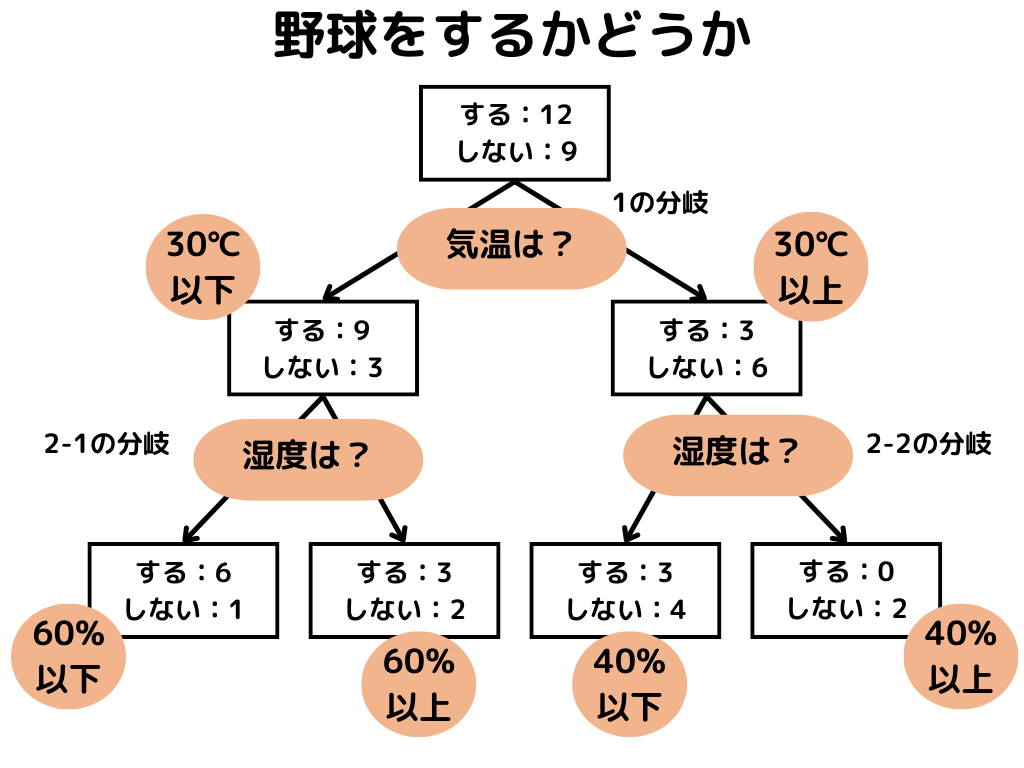
どの特徴量・値を基準にすれば上手く分けられるかを学習します。グラフを分けていくイメージで図示すると、次のような感じです。
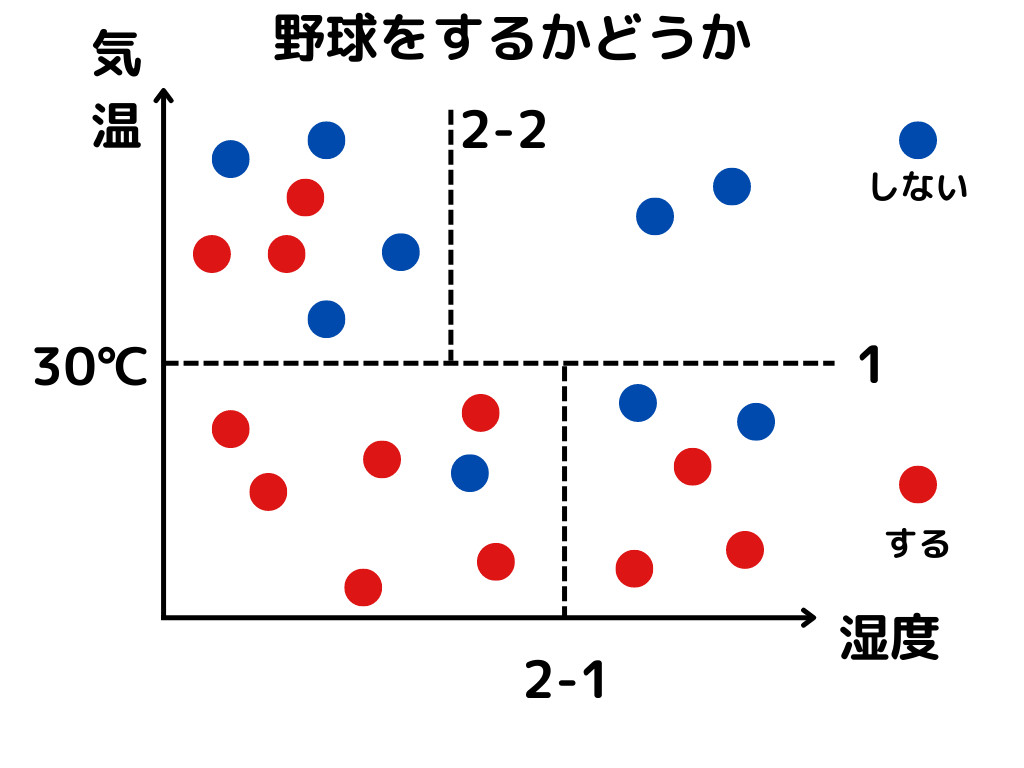
木のような図にすると、次のような感じです。
分類木と回帰木
教師あり学習には「分類問題」と「回帰問題」の2つがありましたね。決定木は、どちらの問題に使うかによって名前が変わります。
- 分類木:分類問題で用いられる決定木
- 回帰木:回帰問題で用いられる決定木
ジニ係数
ジニ係数とは、決定木で区切った部屋の中の純度(どれだけ同じクラスばかりか)を測る指標のことです。
決定木の学習で、どこで分けるかを決める基準として使います。ジニ係数は次の式で与えられます。
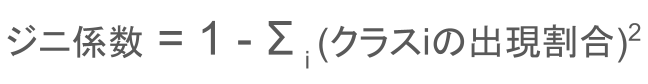
「クラスiの出現確率」というのは、区切った部屋の中で、1つのクラス(区分け)が出てくる割合のことです。
例えば、ある部屋に「野球をする人」だけが7人いれば、1−1²=0で純度は最高です。
「野球をする人」6人と「しない人」1人が混ざっていれば、1−(6/7)²−(1/7)²≒0.24になります。
つまり、ジニ係数は小さいほど純度が高いという意味です。そのため、決定木の学習ではジニ係数が小さくなるように分け方を選んでいきます。
決定木のメリット・デメリット
| メリット | デメリット |
|---|---|
| 解釈可能性が高い | 過学習を起こしやすい |
| 連続値の正規化が不要 | ― |
専門用語が多くなってしまいましたね。それぞれ軽く説明します。
- 解釈可能性:「なぜその結論に達したか」を人が理解しやすいかどうかです。
決定木は分岐をたどれば理由が分かりますが、ディープラーニングは「精度は高いけど中で何を計算したか分からない」となりがちです - 正規化:たくさんのデータを1つの基準に沿って変換し、スケールを合わせることです。
身長(1.2〜2.0m)と体重(40〜100kg)のように桁が違うデータでも、決定木は値の大小で分けるだけなので、そろえなくて大丈夫です - 過学習:訓練用のデータを学習しすぎて、未知のデータの予測精度がむしろ落ちることです。
決定木は枝を深くするほど訓練データに合わせすぎてしまいます
実際に使う場面としては、手軽に予測モデルを作りたいときや、どの特徴量が重要なのかを理解したいときでしょうか。(意外とビジネスの場でも頻出です)
決定木をたくさん集めて弱点を補うランダムフォレストはアンサンブル学習の記事で解説しています。
疑似相関とは(実務で一番多い落とし穴)
疑似相関とは、2つの変数の間に本当は因果関係がないのに、見えない要因(潜伏変数)によって相関関係があるように見えてしまうことです。
例えば「昨日の食事量」と「体重」には相関があるように見えるかもしれません。
でも「昨日食べすぎたから太った」ということは本当にあるのでしょうか。
「生活習慣で食べすぎているから、太っている」の方がしっくりきますよね。
この例では「毎日の平均食事量」が見えない要因(潜伏変数)になっていたわけです。
G検定でよく使われる例が、アイスクリームの売上と水難事故です。
どちらも夏に増えるので相関がありますが、アイスを食べると溺れるわけではありません。本当の原因は「気温」という見えない要因ですね。
実務でも、相関が強いデータを見つけると「これが原因だ!」と飛びつきたくなります。
りけーこっとんもデータ分析で何度もヒヤッとしたことがあるので、相関と因果は別物と常に疑うようにしています。
G検定での問われ方|教師あり学習の早見表
現行シラバスの「教師あり学習」のキーワードを一言でまとめておきます。この記事で扱っていない手法は、リンク先の記事で解説しています。
| 用語 | 一言でいうと | 詳しい解説 |
|---|---|---|
| アンサンブル学習 | 複数のモデルを組み合わせて精度を上げる方法の総称 | 解説記事 |
| カーネル | SVMで、データを高次元に写したときの類似度を計算する関数(カーネル関数) | 解説記事 |
| カーネルトリック | データを高次元に写す計算を、実際に写さずカーネル関数だけで効率よく行う工夫 | 解説記事 |
| 回帰問題 | 売上や気温のように、連続した数値を予測する問題 | この記事 |
| 決定木 | 「もし〜なら」の分岐を木の形で積み重ねて予測する。結果を説明しやすい | この記事 |
| 勾配ブースティング | 誤差の勾配を使って、前のモデルの間違いを直す木を順番に足していくブースティング | 解説記事 |
| サポートベクターマシン(SVM) | クラスの境界線と、最も近いデータとの距離(マージン)を最大化する手法 | 解説記事 |
| 線形回帰 | データに一番よく合う直線(平面)を引く回帰手法。最小二乗法で求める | この記事 |
| 自己回帰モデル(ARモデル) | 過去の自分の値から未来の値を予測する時系列モデル | 解説記事 |
| 単回帰分析 | 1つの説明変数で目的変数を予測する回帰分析 | この記事 |
| 重回帰分析 | 2つ以上の説明変数で目的変数を予測する回帰分析 | この記事 |
| 多クラス分類 | 3つ以上のカテゴリから1つを選ぶ分類問題。出力層でソフトマックス関数をよく使う | この記事 |
| バギング | データを重複ありで抜き出して複数のモデルを並列に学習し、多数決や平均でまとめる | 解説記事 |
| ブースティング | 前のモデルが間違えたところを重点的に、次のモデルを直列に学習していく | 解説記事 |
| ブートストラップサンプリング | 元データから重複を許してランダムに抜き出すこと。バギングで使う | 解説記事 |
| 分類問題 | 犬か猫か、スパムか否かのように、カテゴリを予測する問題 | この記事 |
| ベクトル自己回帰モデル(VARモデル) | 複数の時系列を同時に扱い、互いの影響も含めて予測する自己回帰モデル | 解説記事 |
| マージン最大化 | 境界線と一番近いデータ(サポートベクター)の距離を最大にする考え方 | 解説記事 |
| ランダムフォレスト | たくさんの決定木をバギングで作り、多数決(平均)で予測する手法 | 解説記事 |
| ロジスティック回帰 | 名前は回帰だが「分類」の手法。シグモイド関数で確率を出す | 解説記事 |
よくある質問
Q. 回帰と分類はどう見分けますか?
出力(答え)で見分けます。「犬か猫か」のようにカテゴリを選ぶなら分類問題、「身長は何cmか」のように数値を当てるなら回帰問題です。
Q. 決定木はなぜ説明しやすいのですか?
「年齢が30歳以上か」「年収が500万円以上か」のような条件の分岐をたどるだけで、予測の理由が分かるからです。
ディープラーニングのように中身が複雑すぎて理由が分からない、ということが起きにくいモデルです。
Q. 疑似相関の具体例は?
アイスクリームの売上と水難事故の件数が代表例です。どちらも気温が高い夏に増えるため相関しますが、片方がもう片方の原因になっているわけではありません。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- 教師あり学習:教師データ(正解)に予測を近づけるように学習する手法
- 出力がカテゴリなら分類問題(2クラス・多クラス分類)、連続値なら回帰問題
- 単回帰分析は説明変数1つ、重回帰分析は2つ以上。線形回帰は最小二乗法で直線を求める
- 決定木:ジニ係数が小さく(純度が高く)なるように分ける。解釈しやすいが過学習しやすい
- 疑似相関:見えない要因で相関があるように見えること。相関と因果は別物
教師あり学習の手法は他にもあります。次は、マージン最大化で境界線を引くサポートベクターマシン(SVM)と、k近傍法、ラッソ回帰・リッジ回帰をSVMの記事で解説していきます。覚える内容が多いですが、りけーこっとんも頑張ります!
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。