サポートベクターマシン(SVM)とは?カーネルトリック・k近傍法も解説
どーも、りけーこっとんです。
「SVMのマージン最大化って、何を最大にしているの?」「ラッソ回帰とリッジ回帰、どっちがL1でどっちがL2?」このような、G検定の教師あり学習の手法で混乱している方はいないでしょうか?
この記事では、教師あり学習の第2弾として、最近傍法とk近傍法、サポートベクターマシン(SVM)、ラッソ回帰とリッジ回帰、時系列データの自己回帰モデルを解説します。
どれも「何が違うのか」を比べて問われるので、表で整理しながら進めていきましょう。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- k近傍法は、近い順にk個の教師データを見て、多数決でカテゴリを決める。最近傍法より外れ値に強い
- SVMは、境界線と一番近いデータとの距離(マージン)が最大になるように境界線を引く
- カーネルトリックは、直線で分けられないデータを、高次元で分けられるようにする工夫
- ラッソ回帰はL1正則化で不要な重みを0にでき、リッジ回帰はL2正則化で重みを小さく抑える
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第3章「機械学習の概要」の「教師あり学習」、第4章「正則化」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
最近傍法とk近傍法(kNN)
教師あり学習の全体像(特徴量・目的変数・モデル表現)は教師あり学習の記事で解説しました。
これから示す方法は全て、「変換器・モデル表現」の中の話です。では、一つずつ見ていきましょう。
最近傍法
最近傍法とは、入力されたデータと学習データの距離を計算し、最も近いデータのカテゴリを答えとして出力することです。
この方法の手順は次の通りです。
- 既にある「教師データ」をグラフにプロットしておく
- 未知データが入力され、新しい点がグラフにプロットされる
- その「未知データの新しい点」と「教師データの点」の距離を計算する
- 最も近い教師データの結果を「未知のデータも同じ結果になるだろう」と予想して出力する
今までのデータと照らし合わせて、条件が一番近いものに未知データもなるでしょう、という考えで行っている、最も簡単な方法です。
k近傍法
k近傍法(kNN)とは、入力されたデータに近いk個の学習データを取り上げて、その中で最も多いカテゴリを答えとして出力することです。
方法としては、最近傍法とほぼ一緒です。違うのは手順の3と4で、最も近い1点だけではなく、近い順にk個の点を選び、その中で多数決を取って結果を出力します。
この方法は、最近傍法に比べて外れ値に強い特徴を持っています。1点しか取らないと、その1点が外れ値だった場合に、間違った分類をしてしまいますよね。
ちなみにkは分析者が決めるハイパーパラメータで、多数決が引き分けにならないよう奇数にすることが多いです。
名前が似ているk-means法(クラスタリング)とは別物なので、k-means法の記事で違いを確認しておきましょう。
サポートベクターマシン(SVM)とは
サポートベクターマシン(SVM)とは、マージンが最大になるように、データを分ける境界線を決める手法です。
ここで大事なのは「境界線」という線を引くこと。先ほどまでの近傍法とは違って、明確な線が引かれます。
境界線を明確にできそう、させたいというときに使えそうですね。分類問題だけでなく、回帰問題に使う方法(サポートベクター回帰)もあります。
マージン最大化とは
マージンとは、境界線と、境界線に最も近いデータとの距離のことです。図で示すとこんな感じです。
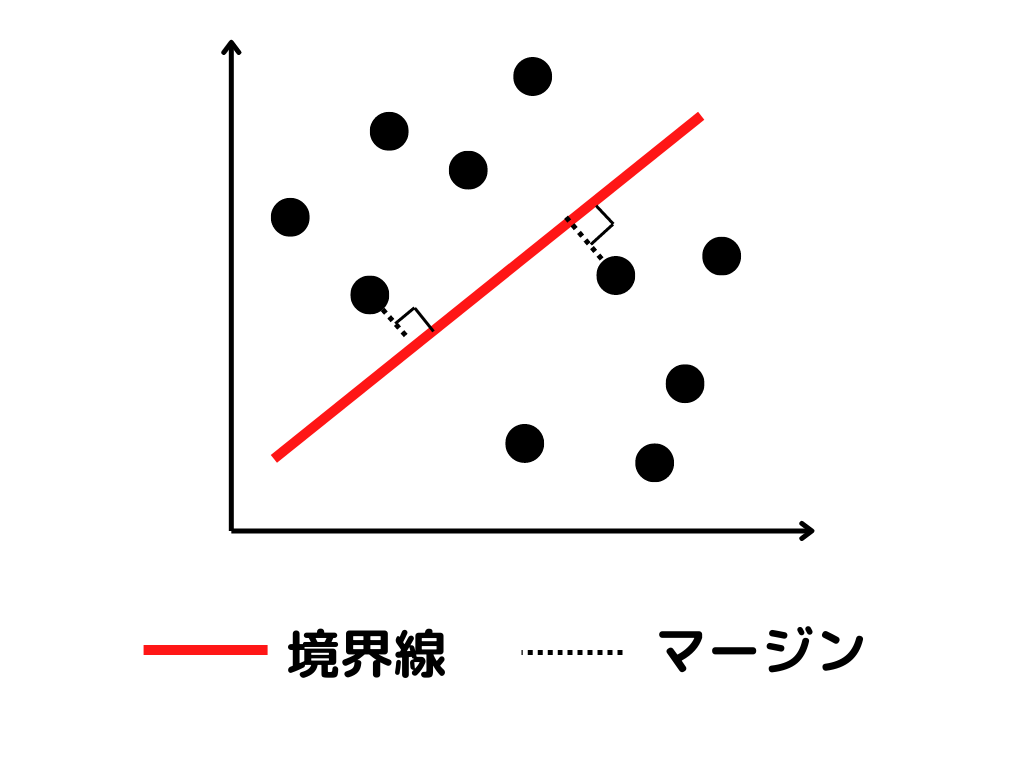
言葉で説明すると、境界線に最も近いデータから、境界線に下ろした垂線の長さとなります。
マージン最大化とは、このマージンが最も長くなるように境界線を引くことです。これがSVMの考え方の中心ですね。
境界線ギリギリにデータがあると、少し違うデータが来ただけで間違えてしまいますが、マージンを広く取ることで、未知のデータにも強い境界線になります。
境界線に最も近いデータのことをサポートベクトルと言います。
境界線は、このサポートベクトルだけで決まるのがポイントです。
ハードマージンとソフトマージン
ハードマージンとは、データがA・Bにきっぱり分けられることを前提とした、境界線の引き方のことです。
計算は、先ほどまで述べてきた方法で行います。
ただし、そう上手くはいかないのが現実世界。そこで外れ値にも対応できるようにした引き方が、次のソフトマージンです。
ソフトマージンとは、データがA・Bにきっぱり分けられないことを考慮した、境界線の引き方のことです。
現実世界では、A・Bできっぱり分けられないデータが多いですよね。何個かは、違うデータの分類に入ってしまうことがあります。
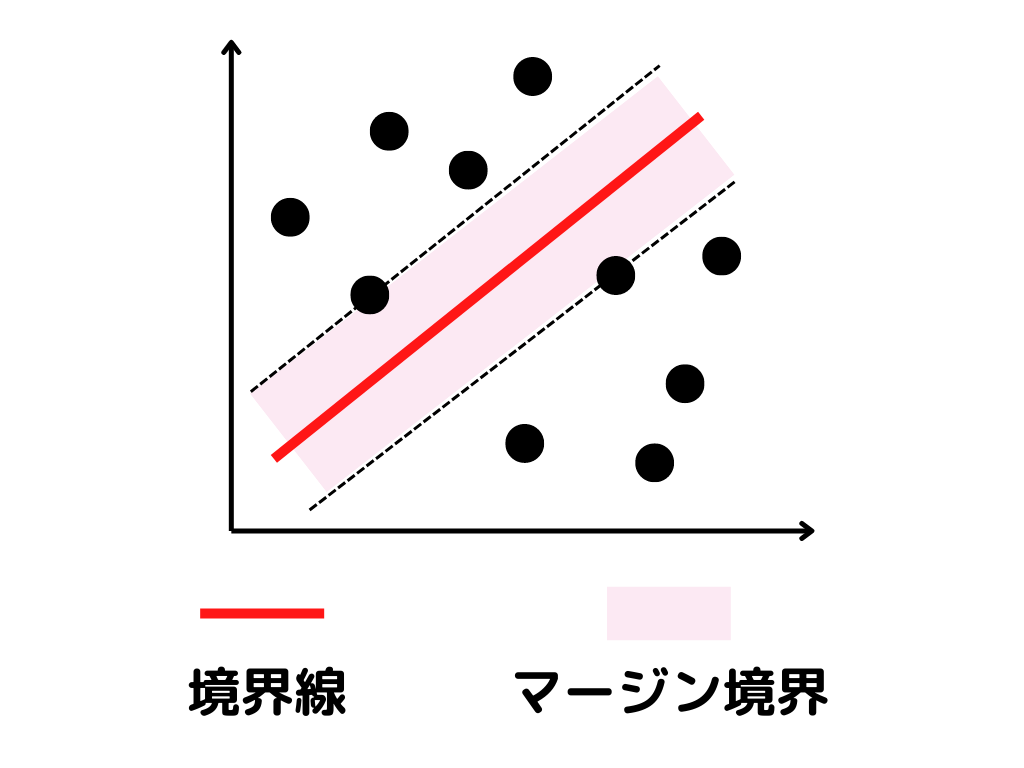
そこで、誤分類したデータとマージンの内側に入ったデータにペナルティを与えます。
こうすることで、何個かは違う分類のデータがあったとしても、それを考慮した線の引き方ができるんです。
マージンの内側というのは、図で言うと点線の内側の部分です。
カーネルとカーネルトリック
ここまでの話を聞いて、「直線だけじゃ分類できない問題もあるでしょ」と思ったあなた。その通りです。
カーネルとは
カーネル(カーネル関数)とは、直線では分類できない複雑なデータを、高次元(2次元⇒3次元など)に写像するために使う関数のことです。
例えば、2次元の平面で、真ん中に赤い点が集まり、その周りを青い点が囲んでいるデータは、直線では分けられません。
でも「中心からの距離」という3つ目の軸を足して3次元にすると、赤い点が下、青い点が上に分かれて、平らな面できれいに分けられるようになります。
このように、曲線だったり円形だったりしても、分類できるようにするのがカーネル関数です。
カーネルトリックとは
カーネルトリックとは、高次元への写像を実際には計算せずに、カーネル関数を使って高次元での計算結果だけを手早く求める工夫のことです。
イメージとしての手順はこんな感じです。
- カーネル関数を使って、データを高次元に写像する
- 高次元の空間で境界線(平らな面)を引く
- データと境界線を元の次元に戻すと、複雑な曲線が引けている
ただ、まともに高次元へ写像すると、次元が増えて計算量が膨大になってしまいます。
そこで、SVMの計算に必要な「データ同士の内積」だけをカーネル関数で直接求めることで、計算量を抑えているのが「トリック(うまい工夫)」と呼ばれる理由です。
G検定では「計算量を抑える工夫」という点まで押さえておけば十分です。
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

ラッソ回帰とリッジ回帰の違い
ラッソ回帰とは
ラッソ(Lasso)回帰とは、残差二乗和にパラメータの絶対値の和(L1正則化項)を足した式を、最小化するように学習する手法のことです。
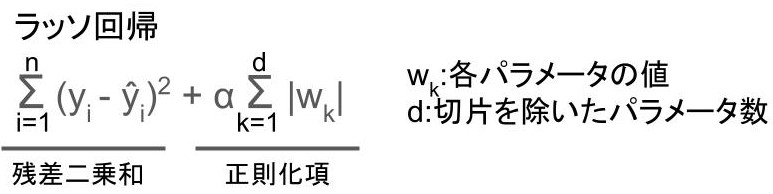
残差二乗和は最小二乗法の記事で出てきましたね。足している正則化項というのは、過学習を防ぐための部分です。
wのパラメータというのは、単純なものだと「切片」と「傾き」のことです。αはパラメータの大きさをどれだけ制限したいかによって、分析者自身が決めます。
これはハイパーパラメータと言いましたね。
ラッソ回帰のように、パラメータの絶対値の和を用いた正則化のことをL1正則化と言います。
L1正則化では、不要な特徴量の重みがちょうど0になりやすいので、自動で特徴量を選んでくれるのが特徴です。
使いどころとしては、特徴量の数が膨大で、ほとんどの要素が0の場合などに使えますね。こういう場合は、自然言語処理の分野などに見られるそうです。
リッジ回帰とは
リッジ(Ridge)回帰とは、残差二乗和にパラメータの二乗和(L2正則化項)を足した式を、最小化するように学習する手法のことです。
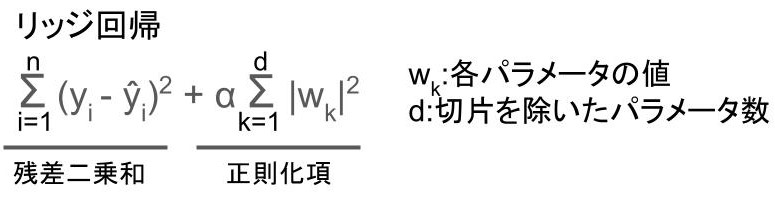
ラッソ回帰とほぼ同じですね。異なる点は、正則化項が二乗になっている点です。
リッジ回帰のように、パラメータの二乗和を用いた正則化のことをL2正則化と言います。
L2正則化では、重みは0にはならず、全体的に小さく抑えられます。
使いどころとしては、特徴量が多く、多重共線性による問題や過学習が起こるおそれのある場合です。
多重共線性とは、ある特徴量が別の特徴量で説明できてしまうことで、発生すると学習が上手く進まなくなってしまいます。例えば次のような式があったとしましょう。
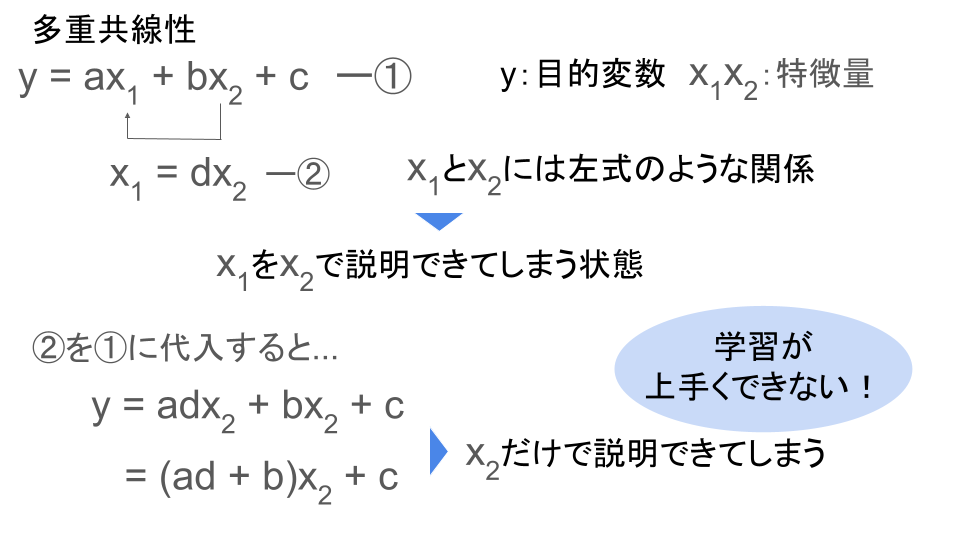
このように、ある変数を別の変数で説明できてしまうことを、多重共線性と言います。
| 比べるところ | ラッソ回帰 | リッジ回帰 |
|---|---|---|
| 正則化 | L1正則化(絶対値の和) | L2正則化(二乗和) |
| 重みの変化 | 不要な重みがちょうど0になる | 重みが全体的に小さくなる(0にはならない) |
| 向いている場面 | 特徴量が多く、絞り込みたいとき | 多重共線性があるとき |
両方を組み合わせたElastic Netという手法もあります。正則化の種類(L0・L1・L2)は正則化と交差検証の記事でまとめて解説しています。
時系列の回帰|自己回帰モデル(ARモデル)とベクトル自己回帰モデル(VARモデル)
自己回帰モデルとは
自己回帰モデル(ARモデル)とは、1つの変数のある時刻tの値を、時刻tよりも前の自分自身のデータを使って予測・説明するモデルのことです。
例えば「明日の気温」を「今日・昨日・おとといの気温」から予測するようなイメージですね。自然科学や経済学など、時間に対して変動する過程を知りたいときに使います。
ベクトル自己回帰モデルとは
ベクトル自己回帰モデル(VARモデル)とは、2つ以上の変数を、時刻tより前のそれぞれのデータを使って予測・説明するモデルのことです。
1変数のみだった自己回帰モデルを、2変数以上に拡張したものと言えますね。
例えば「金利」と「株価」のように、お互いに影響し合う複数の時系列を、まとめて予測するときに使います。
G検定では、ARは1変数、VARは2変数以上という違いが重要です。
G検定での問われ方
この記事の手法は、似たもの同士の違いを問う問題がよく出ます。
| 手法 | 一言でいうと | 覚えるポイント |
|---|---|---|
| 最近傍法 | 一番近い1点のカテゴリを答える | 外れ値に弱い |
| k近傍法(kNN) | 近いk個で多数決 | 外れ値に強い・kはハイパーパラメータ |
| サポートベクターマシン | マージン最大化で境界線を引く | サポートベクトルだけで境界が決まる |
| ハードマージン/ソフトマージン | きっぱり分ける/はみ出しを許す | ソフトはペナルティを与える |
| カーネルトリック | 高次元の計算を手早く行う工夫 | 計算量を抑える |
| ラッソ回帰 | L1正則化 | 重みが0になる(特徴量選択) |
| リッジ回帰 | L2正則化 | 重みが小さくなる(多重共線性対策) |
| 自己回帰モデル(AR) | 過去の自分の値で予測 | 1変数 |
| ベクトル自己回帰モデル(VAR) | 複数の変数を過去の値で予測 | 2変数以上 |
よくある質問
Q. SVMは分類だけに使えますか?
分類が代表的な使い方ですが、回帰問題にも使えます。回帰に使う方法はサポートベクター回帰(SVR)と呼ばれます。
Q. カーネルトリックは何が「トリック」なのですか?
データを高次元に写像して計算すると、計算量が膨大になってしまいます。
カーネル関数を使えば、写像そのものを計算せずに必要な結果だけを求められるので、計算量を抑えられる点がトリック(うまい工夫)と呼ばれる理由です。
Q. ラッソ回帰とリッジ回帰はどう使い分けますか?
特徴量が多く、不要なものを自動で外したいときはラッソ回帰(L1正則化)、特徴量同士が強く関係している(多重共線性がある)ときはリッジ回帰(L2正則化)が向いています。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- k近傍法:近いk個の教師データで多数決。最近傍法より外れ値に強い
- SVM:マージンが最大になるように境界線を引く。ソフトマージンははみ出しにペナルティを与える
- カーネルトリック:高次元への写像を計算せずに済ませ、計算量を抑える工夫
- ラッソ回帰はL1正則化で重みを0に、リッジ回帰はL2正則化で重みを小さくする
- 自己回帰モデル(AR)は1変数、ベクトル自己回帰モデル(VAR)は2変数以上の時系列を予測
実は教師あり学習は、まだ他にも手法があります。
次回は、複数のモデルを組み合わせるアンサンブル学習(バギング・ブースティング・ランダムフォレスト)とロジスティック回帰をアンサンブル学習の記事で解説していきます。一緒に頑張っていきましょう!
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。