強化学習とは?Q学習・方策勾配法・Actor-Criticをわかりやすく解説

どーも、りけーこっとんです。
「状態価値関数と行動価値関数、名前がややこしすぎる」「Q学習とSARSAの違いが分からない」このような、G検定の強化学習で手が止まっている方はいないでしょうか?
この記事では、強化学習の基本の流れから、価値関数ベース手法(Q学習・SARSA)、方策ベース手法(方策勾配法・REINFORCE)、両方を組み合わせたActor-Criticまでを解説します。
強化学習を深く理解しようとすると数学が難しくなるので、G検定に必要な「何が違うのか」に絞って、表で整理していきます。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- 強化学習とは、エージェントが環境の中で行動し、もらえる報酬の合計が最大になるように学ぶ手法
- 状態価値関数は「今の状態」の価値、行動価値関数(Q値)は「今の状態でその行動を取る」価値
- Q学習は次の状態の最大のQ値で更新(方策オフ型)、SARSAは実際に選んだ行動のQ値で更新(方策オン型)
- 方策勾配法は方策そのものを直接改善する。Actor-Criticは方策(Actor)と価値(Critic)を同時に学ぶ
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第3章「機械学習の概要」の「強化学習」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
- 紙で手元に置きたい方は → G検定カンペの印刷用PDF(無料・A4・15ページ)をダウンロードできます
強化学習とは|試行錯誤で報酬を最大化する
強化学習とは、ある環境の中で目的を達成するために、一連の行動で得られる報酬の合計を最大化するように学習する機械学習の手法です。
具体的な手順は次の通りです。
- 現在の「環境」から「状態」を観測する
- 「状態」から「方策」に基づいて「行動」する
- 「行動」によって変わった次の「状態」と「報酬」を受け取る
- 1に戻る
「方策」とは簡単に言うと、エージェント(ロボットなど学習する主体)の行動選択のルールのことです。イメージとしては次のような感じです。
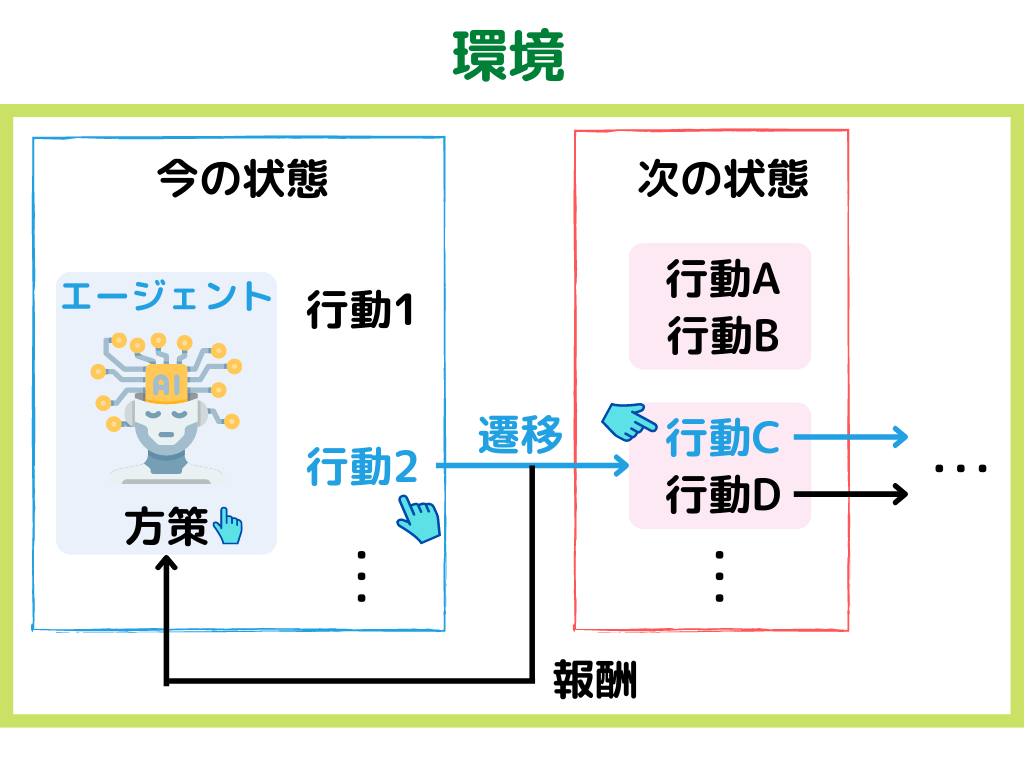
ゲームで言えば、エージェントがプレイヤー、環境がゲームの世界、報酬がスコアですね。正解の手を教えてもらうのではなく、試行錯誤で報酬から学ぶのが、教師あり学習との大きな違いです。
強化学習の手法は、次の3種類に分かれます。
| 手法 | 考え方 | 代表例 |
|---|---|---|
| モデルベース手法 | 環境の仕組み(状態の移り方と報酬)を使って学ぶ | 方策反復法 |
| 価値関数ベース手法 | 状態や行動の「価値」を学び、価値の高い行動を選ぶ | Q学習、SARSA |
| 方策ベース手法 | 行動を選ぶルール(方策)そのものを直接学ぶ | 方策勾配法、REINFORCE |
価値関数ベース手法と方策ベース手法は、環境の仕組みが分からなくても使えるのでモデルフリー手法と呼ばれます。
現実世界で「どの状態で、どんな行動を取るとどうなるか」を全部分かっている状況なんてまずないので、モデルフリー手法がよく使われるんですね。
モデルベース手法は半教師あり学習とモデルベース強化学習の記事で解説しています。
状態価値関数と行動価値関数(Q値)・割引率
価値関数ベース手法は、報酬の期待値を「状態」や「行動」の価値として計算し、価値の高い行動を選ぶようにします。
使う関数は次の2つです。名前がややこしいですが、それぞれ見ていきましょう。
状態価値関数とは
状態価値関数とは、ある状態から方策に従って行動したときに、将来もらえる報酬の合計の期待値を表す関数で、「今の状態」の価値を表します。
計算するときは、直近の報酬に「1ステップ先の状態の価値」を足したもの、という形で表します。
ただし、方策や状態の移り方によって未来は枝分かれするので、その期待値を取っていますね。具体的には次の式で表せます。

具体的な式まで覚える必要はありませんが、「今の状態の価値を表す関数」ということは覚えておきましょう。
行動価値関数とは
行動価値関数とは、ある状態で、ある行動を取ったときに、将来もらえる報酬の合計の期待値を表す関数で、「今の状態で、その行動を取る」価値を表します。
こちらも、直近の報酬に「1ステップ先の行動価値の期待値」を足したもの、という形で表せます。

Q値とは
Q値とは、行動価値関数の値のことで、ある状態で今の行動にどれくらいの価値があるかを表す値です。
上の行動価値関数の式で出てくる値そのものですね。行動価値関数はQ関数とも呼ばれます。
このQ値を最大にする行動を選ぶことが、価値関数ベース手法の目的です。
| 関数 | 何の価値か | イメージ |
|---|---|---|
| 状態価値関数 | 今の状態の価値 | 迷路のこの場所にいることの良さ |
| 行動価値関数(Q値) | 今の状態で、ある行動を取る価値 | この場所で「右に進む」ことの良さ |
割引率とは
割引率とは、将来もらえる報酬を、今の時点でどれだけ割り引いて考えるかを決めるパラメータのことです。
0から1の値で、記号はγ(ガンマ)を使います。
割引率の基本的な考え方は、「将来に行くほど、報酬の価値は小さく見積もる」というものです。
今日もらえる1万円と、10年後にもらえる1万円なら、今日のほうがうれしいですよね。
割引率が0に近いほど目先の報酬を重視し、1に近いほど将来の報酬まで重視します。
Q学習とSARSA(価値ベース)
Q学習とは
Q学習とは、行動したあと、次の状態で取れる行動のうち最大のQ値を使って、今のQ値を更新していく手法です。
状態価値関数も行動価値関数も、「今の価値」を計算するために「次の状態の価値」を使っていましたよね。
この「次の状態の価値」として、次の状態での最大のQ値を使うのがQ学習です。
実際に次にどの行動を取るかに関係なく、一番良い行動を取ったと仮定して更新するので、方策オフ型と呼ばれます。
Q学習にディープラーニングを組み合わせたものがDQN(Deep Q-Network)で、Atariのゲームで人間並みのスコアを出して話題になりました。
詳しくはDQNと深層強化学習の記事で解説しています。
SARSAとは
SARSAとは、次の状態で実際に選んだ行動のQ値を使って、今のQ値を更新していく手法です。
名前は、更新に使う「State(状態)、Action(行動)、Reward(報酬)、次のState、次のAction」の頭文字から来ています。
実際に方策に従って選んだ行動で更新するので、方策オン型と呼ばれます。
| 比べるところ | Q学習 | SARSA |
|---|---|---|
| 次の状態の価値として使うもの | 最大のQ値 | 実際に選んだ行動のQ値 |
| 分類 | 方策オフ型 | 方策オン型 |
| 性格 | 楽観的(最善手を取る前提) | 慎重(失敗も含めて評価する) |
TD学習とは
TD学習とは、1ステップ進むたびに「予測していた価値」と「実際の報酬+次の状態の価値」のズレ(TD誤差)を使って、価値の見積もりを少しずつ更新していく手法です。
TDはTemporal Difference(時間的な差分)の略です。
ゲームの最後まで待たずに、1手ごとに見積もりを直せるのが特徴ですね。
Q学習やSARSAも、このTD学習の考え方を使っています。
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

方策勾配法とREINFORCE(方策ベース)
方策ベース手法とは、価値を経由せずに、どの行動を取る確率を増やすかという「方策」そのものを直接学習する手法です。
価値関数ベース手法では、「状態」と「行動」の価値を毎回計算して、どう行動するのかを決めていました。
一方、方策ベース手法では、方策を直接計算して改善します。
行動の選択肢が多すぎたり、ロボットの関節の角度のように連続的な値だったりして、全部の行動の価値を計算するのが難しいときに向いています。
方策勾配法とは
方策勾配法とは、報酬の期待値が大きくなる方向に、方策のパラメータを少しずつ更新していく手法です。
具体的な手順は次の通りです。
- まず初期の方策を決める
- その方策で一連の行動をする
- 行動の結果から、方策を評価する
- 評価値が大きくなるように、方策勾配定理を使って方策を更新する
- 2から繰り返す
方策勾配定理は詳しい式を覚えるのではなく、「方策勾配法で、方策をどの方向に更新すればよいかを計算するための定理」くらいの理解で大丈夫です。
REINFORCEとは
REINFORCEとは、方策勾配法の一種で、一連の行動を最後まで終えてから得られた報酬を使って、方策を評価・更新する手法です。
方策勾配法では「方策を評価する」ことが重要です。評価値が出ないと、方策を更新できませんからね。
でも行動の選択肢が多すぎると、適切な価値関数を求めるのは難しいですよね。
そこでREINFORCEは、実際に得られた報酬を、Q値の代わりの評価として使います。
これによって方策を評価し、直接方策を改善していきます。
Actor-Critic(両方の組み合わせ)
Actor-Criticとは、行動を選ぶ「Actor(行動者)」と、その行動を評価する「Critic(評価者)」の2つを組み合わせて、同時に学習する手法です。
- Actor:方策に従って行動を選ぶ(方策ベースの部分)
- Critic:行動価値関数などで、その行動がどれだけ良かったかを評価する(価値ベースの部分)
Actorは、Criticの評価(TD誤差)を受けて方策を改善し、CriticはActorの行動結果を受けて評価の精度を上げる、という形で交互に学習していきます。
演技をする役者(Actor)と、それを評価する批評家(Critic)のイメージですね。
方策ベースと価値ベースのいいとこ取りで、ロボットの制御などでも活用が進んでいます。
Actor-Criticを並列化して発展させたのがA3Cです。A3Cは多腕バンディットとA3Cの記事で解説しています。
手法の比較表と深層強化学習へのつながり
| 手法 | 分類 | 何を学ぶか | ポイント |
|---|---|---|---|
| Q学習 | 価値ベース(方策オフ型) | 行動価値(Q値) | 次の状態の最大のQ値で更新 |
| SARSA | 価値ベース(方策オン型) | 行動価値(Q値) | 実際に選んだ行動のQ値で更新 |
| TD学習 | 価値ベース | 価値の見積もり | 1ステップごとのズレ(TD誤差)で更新 |
| 方策勾配法 | 方策ベース | 方策 | 報酬の期待値が大きくなる方向に更新 |
| REINFORCE | 方策ベース | 方策 | 実際に得られた報酬で評価 |
| Actor-Critic | 両方の組み合わせ | 方策と価値 | ActorとCriticを同時に学ぶ |
これらの手法にディープラーニングを組み合わせたものが深層強化学習です。
DQNやAlphaGoは、まさにこの延長線上にあります。現行シラバスの「強化学習」のキーワードは、次の表ですべて確認できます。
| 用語 | 一言でいうと | 詳しい解説 |
|---|---|---|
| Actor-Critic | 行動を決めるActor(方策)と、それを評価するCritic(価値)を組み合わせた手法 | この記事 |
| ε-greedy方策 | 確率εでランダムに探索し、それ以外は今一番良い行動を選ぶ方策 | 解説記事 |
| REINFORCE | 方策勾配法の代表的なアルゴリズム | この記事 |
| Q学習 | 行動価値(Q値)を更新しながら最適な行動を学ぶ代表的手法。方策オフ型 | この記事 |
| UCB方策 | まだあまり試していない行動を優先して試す方策 | 解説記事 |
| 行動価値関数 | ある状態である行動を取ったときに、将来得られる報酬の期待値(Q値) | この記事 |
| 状態価値関数 | ある状態にいるときに、将来得られる報酬の期待値 | この記事 |
| バンディットアルゴリズム | 「今わかっている良い手を使う(活用)」と「新しい手を試す(探索)」のバランスを取る方法 | 解説記事 |
| 方策勾配法 | 価値ではなく、方策(行動の選び方)そのものを直接最適化する方法 | この記事 |
| マルコフ決定過程 | 次の状態が今の状態と行動だけで決まる(マルコフ性)環境での意思決定のモデル | 解説記事 |
| 割引率 | 将来の報酬をどれだけ割り引いて考えるかを表す0〜1の値 | この記事 |
| SARSA | 実際に選んだ次の行動のQ値で更新する手法。方策オン型 | この記事 |
よくある質問
Q. Q学習とSARSAの違いは?
Q値を更新するときに使う「次の状態の価値」が違います。
Q学習は次の状態で取れる最大のQ値を使い(方策オフ型)、SARSAは実際に選んだ行動のQ値を使います(方策オン型)。
Q. 割引率とは何ですか?
将来もらえる報酬を、今の時点でどれだけ割り引いて評価するかを決める0〜1のパラメータです。
0に近いほど目先の報酬を、1に近いほど将来の報酬を重視します。
Q. 強化学習は教師あり学習と何が違う?
教師あり学習は、正解(教師データ)を見て学びます。強化学習には正解がなく、行動した結果の報酬だけを手がかりに、試行錯誤で良い行動を学びます。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- 強化学習:環境の中で行動し、報酬の合計を最大化するように学ぶ。モデルフリー手法がよく使われる
- 状態価値関数は「今の状態」、行動価値関数(Q値)は「今の状態でその行動を取る」価値
- 割引率は将来の報酬をどれだけ割り引くかのパラメータ(0〜1)
- Q学習は最大のQ値で更新(方策オフ型)、SARSAは実際の行動のQ値で更新(方策オン型)
- 方策勾配法・REINFORCEは方策を直接学ぶ。Actor-Criticは方策と価値を同時に学ぶ
次回は「強化学習」最後の章として、探索と活用のジレンマを扱う多腕バンディット問題と、ε-greedy方策・UCB方策、マルコフ決定過程を多腕バンディットの記事で解説していきます。
覚える内容が多いですが、りけーこっとんも頑張ります!
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。