半教師あり学習とは?自己教師あり学習・モデルベース強化学習も解説

どーも、りけーこっとんです。
「半教師あり学習と自己教師あり学習、名前が似すぎていて区別できない」「強化学習のモデルベースって、何のモデルのこと?」このような、G検定で学習方法の種類が増えてきて混乱している方はいないでしょうか?
この記事では、教師あり学習と教師なし学習の間にある「半教師あり学習」と、ChatGPTのような生成AIの土台になっている「自己教師あり学習」を解説します。
後半では、強化学習の入口として、モデルベース手法と方策反復法もまとめました。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- 半教師あり学習とは、少しのラベル付きデータと大量のラベルなしデータを組み合わせて学習する手法
- 自己教師あり学習とは、データそのものから正解ラベルを自動で作って学習する手法。BERTやGPTの事前学習で使われる
- 強化学習は、報酬を最大化するように行動を学ぶ、教師あり・教師なしとは別の3つ目の学習方法
- モデルベース手法は、環境の仕組み(状態の移り方と報酬)が分かっているときに使える。代表が方策反復法
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第6章「転移学習・ファインチューニング」、第3章「強化学習」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
- 紙で手元に置きたい方は → G検定カンペの印刷用PDF(無料・A4・15ページ)をダウンロードできます
半教師あり学習とは
半教師あり学習とは、一部のラベル付きデータ(教師データ)と、大量のラベルなしデータを組み合わせて学習する手法です。
名前から予想できるとおり、教師あり学習と教師なし学習の間(半分)、といった感じでしょうか。
正解ラベルを使って学ぶという意味では教師あり学習、一部のデータにラベルがないという意味では教師なし学習ですね。
写真に「犬」「猫」と正解を付ける作業は、人の手がかかってとても大変です。
全データの教師データを用意できなかった場合などに、半教師あり学習が使えます。
教師あり学習のイメージ図を、もう一度載せておきますね。
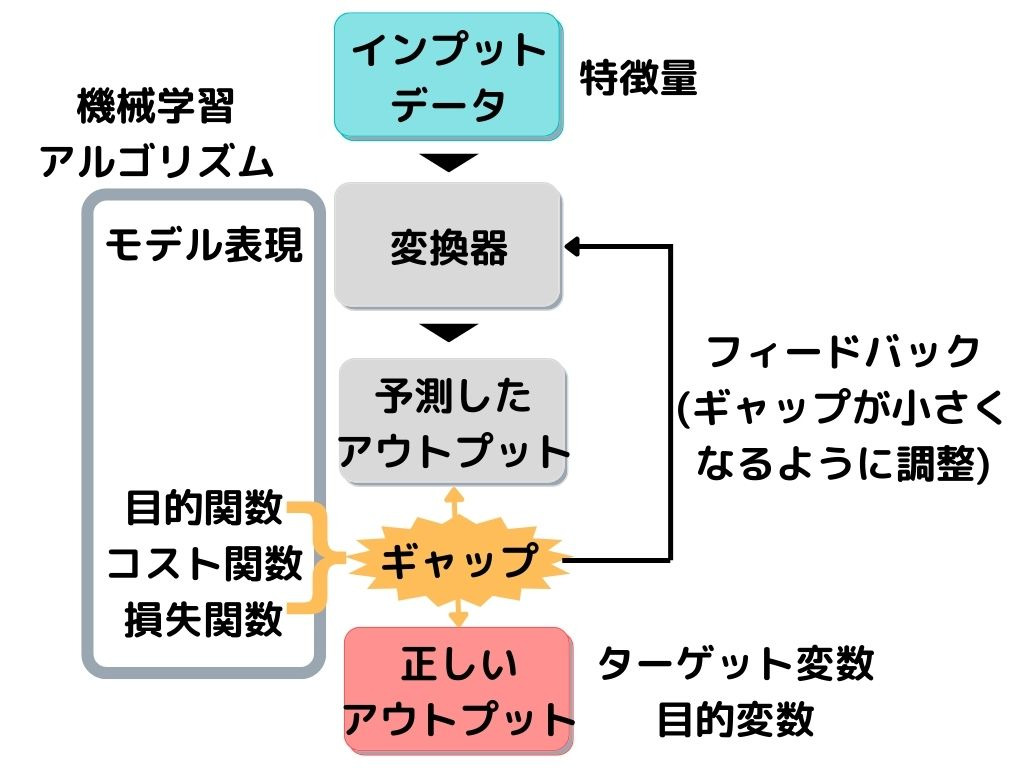
具体的な手順の一例は、次の通りです。
- 教師データがある訓練データだけで、教師あり学習を行ってモデルを作る
- できたモデルで、教師データがないデータの正解ラベルを予測する(擬似ラベル)
- 予測したラベル付きのデータも含めて、モデルを学習し直す
このように学習に使えるデータの規模を大きくすることで、少ないラベルでも、より良いモデルが作れるんですね。
ただし、2で間違ったラベルを付けてしまうと、その間違いまで学習してしまう点には注意が必要です。
自己教師あり学習とは
自己教師あり学習とは、人が正解ラベルを付けなくても、データそのものから問題と正解を自動で作って学習する手法です。
例えば文章なら、「今日は[ ]が良いので散歩に行こう」のように一部の単語を隠して、隠した単語を当てる問題を作れますよね。
正解(「天気」)は元の文章に書いてあるので、人がラベルを付ける必要がありません。
インターネット上の大量の文章を、そのまま教材にできるわけです。
- BERT:文章の一部の単語を隠して、それを当てる問題で事前学習する
- GPT:文章の続きの単語を当てる問題で事前学習する
- 画像では、同じ画像を回転・切り抜きしたものを「同じ画像だ」と見分ける問題(対照学習)で学習する方法がある
こうして大量のデータで事前学習したモデルを、少しのラベル付きデータで目的の作業に合わせて調整するのがファインチューニングです。
生成AIの事前学習の土台になっているので、現行シラバスでは「転移学習・ファインチューニング」の範囲に入っています。
BERTとGPTの事前学習の中身はBERTとTransformerの記事で解説しています。
教師あり・教師なし・半教師あり・自己教師ありの比較
4つの学習方法は、「正解ラベルを誰が用意するか」で比べると整理しやすいです。
| 学習方法 | 正解ラベル | 代表的な使い方 |
|---|---|---|
| 教師あり学習 | すべてのデータに人が付ける | 分類問題、回帰問題 |
| 教師なし学習 | 使わない | クラスタリング、次元削減 |
| 半教師あり学習 | 一部のデータにだけ人が付ける | ラベル付けが大変な画像の分類など |
| 自己教師あり学習 | データから自動で作る | BERT・GPTなどの事前学習 |
「自己教師あり学習は教師なし学習の一種と見なされることもある」点も押さえておきましょう。
人がラベルを付けない点は教師なし学習と同じですが、自動で作った正解を使って教師あり学習の形で学ぶのが違いです。
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

強化学習とは
強化学習とは、ある環境の中で目的を達成するために、一連の行動で得られる報酬の合計を最大化するように学習する機械学習の手法です。
具体的な手順としては、次の通りです。
- 現在の「環境」から「状態」を観測する
- 「状態」から「方策」に基づいて「行動」する
- 「行動」によって変わった次の「状態」と「報酬」を受け取る
- 1に戻る
このように、教師あり学習・教師なし学習とは異なる、3種類目の機械学習の手法です。
「方策」とは簡単に言うと、エージェント(ロボットなどの学習する主体)の行動選択のルールのことですね。
イメージとしては次のような感じです。
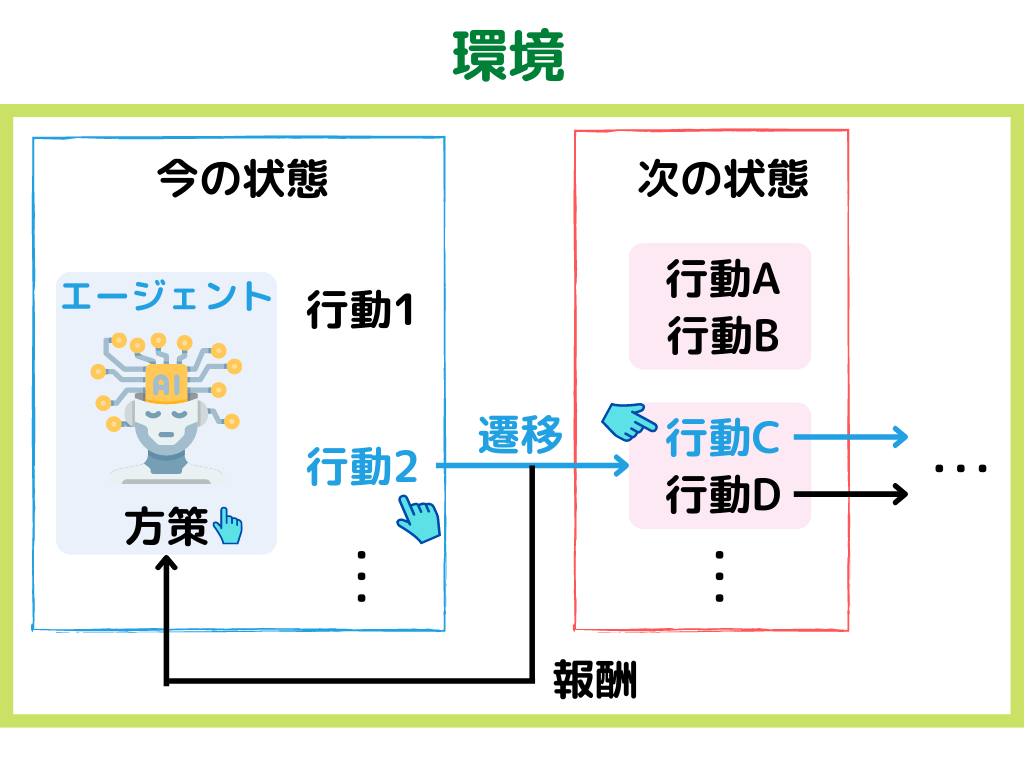
上の例では、「方策」で行動2を選んだ後、行動Cを選ぶ、という例です。強化学習は、大きく次の3種類の方法に分かれます。
- モデルベース手法
- 価値関数ベース手法
- 方策ベース手法
価値関数ベース手法と方策ベース手法は強化学習とQ学習の記事で解説しています。ここではモデルベース手法を見ていきましょう。
強化学習のモデルベース手法と方策反復法
モデルベース手法とは
モデルベース手法とは、環境の仕組み(ある行動でどの状態に移るかの確率と、もらえる報酬)が分かっている、または学習して手に入れた「環境のモデル」を使う強化学習の手法です。
環境の仕組みというのは、「この行動を取ったときに、どれくらいの報酬がもらえるか、次はどんな状態になるのか」が、目的達成までの過程ですべて分かっていることです。
オセロ・囲碁・将棋などのボードゲームは、ルールが決まっているので使いやすいようですね。
逆に、環境の仕組みが分からないまま、試行錯誤だけで学ぶ方法をモデルフリーと言います。
現実の世界では環境の仕組みが全部分かっていることはまずないので、Q学習などのモデルフリー手法がよく使われます。
モデルベースの代表的な手法には、次の2つがあります。
方策反復法とは
方策反復法とは、今の方策に従ったときの各状態の価値を計算し(方策評価)、その価値が高くなるように方策を改善する(方策改善)ことを、繰り返す手法です。
方策が改善されなくなるまで繰り返します。
ここで「方策」とは、「こんな状態のときに、次はどう行動するのが良いのか」を表す確率のルールのことです。
例えば、迷路でロボットが前・右・左に分かれる道にたどり着いたとしますね。このときの「状態」は、分岐にたどり着いたロボットの位置です。
- 方策1は「前33%、右33%、左33%」の確率で進む道を選ぶ
- 方策2は「前50%、右25%、左25%」の確率で進む道を選ぶ
方策2に従った方が方策1よりも迷路を解きやすいなら、「方策2を使ったとき、今この分岐にいること(状態)の価値は高い」と言えますね。
方策反復法は、このように方策を評価しては改善することを繰り返し、価値が一番高くなる方策を最適解とするイメージです。
モンテカルロ木探索とは
モンテカルロ木探索とは、ある状態から先の行動を何回もシミュレーションして、得られた報酬の平均で、どの行動が良いかを見積もる手法です。
先ほどの迷路の例なら、前・右・左に進む行動を、それぞれ何回も試して報酬の平均を計算します。
そして最も高い報酬が期待できる行動を取って、次の分岐(状態)へ…ということを繰り返していきます。
シミュレーションするには環境のルールが分かっている必要があるので、モデルベースの手法に分類されます。
囲碁AIのAlphaGoは、このモンテカルロ木探索とディープラーニングを組み合わせて強くなりました。
詳しくはAlphaGoの記事、もとになったモンテカルロ法はモンテカルロ法の記事で解説しています。
G検定での問われ方
この記事の用語は、「正解ラベルをどう用意するか」と「環境の仕組みを使うかどうか」がよく問われます。
| 用語 | 一言でいうと | 覚えるポイント |
|---|---|---|
| 半教師あり学習 | 一部のラベル付きデータと大量のラベルなしデータで学ぶ | 擬似ラベルでデータを増やす |
| 自己教師あり学習 | データから正解を自動で作って学ぶ | BERT・GPTの事前学習 |
| モデルベース手法 | 環境の仕組み(遷移確率と報酬)を使う強化学習 | ボードゲームで使いやすい |
| 方策反復法 | 方策評価と方策改善を繰り返す | モデルベース手法 |
| モンテカルロ木探索 | シミュレーションの報酬の平均で行動を選ぶ | AlphaGoで使われた |
よくある質問
Q. 半教師あり学習はどんな場面で使いますか?
正解ラベルを付けるのに手間やお金がかかる場面です。
例えば医療画像の診断のように専門家しかラベルを付けられないデータは、一部だけラベルを付けて、残りはラベルなしのまま使う半教師あり学習が役立ちます。
Q. 自己教師あり学習と教師なし学習の違いは?
どちらも人が正解ラベルを付けない点は同じです。
自己教師あり学習は、データの一部を隠すなどして自動で「問題と正解」を作り、教師あり学習の形で学ぶ点が違います。
教師なし学習の一種として扱われることもあります。
Q. モデルベース強化学習とモデルフリーの違いは?
モデルベースは、環境の仕組み(どの行動でどの状態に移り、どれだけ報酬がもらえるか)を使って計画的に学びます。
モデルフリーは、環境の仕組みを使わず、実際に行動して得た報酬だけから試行錯誤で学びます。Q学習はモデルフリーの代表です。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- 半教師あり学習:一部のラベル付きデータと大量のラベルなしデータを組み合わせて学ぶ
- 自己教師あり学習:データから正解を自動で作って学ぶ。BERTやGPTの事前学習の土台
- 強化学習:報酬の合計が最大になるように行動を学ぶ、3つ目の機械学習
- モデルベース手法:環境の仕組みを使う強化学習。方策反復法とモンテカルロ木探索が代表
次回は、強化学習のモデルフリー手法として、価値関数ベースのQ学習と、方策ベースの方策勾配法・Actor-Criticを強化学習とQ学習の記事で解説していきます。
強化学習は深く理解しようとすると数学が難しくなるので、「何が違うのか」を中心に押さえていきましょう。
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。