パーセプトロンとは?単純パーセプトロンとコーパス・第3次AIブームの技術
どーも、りけーこっとんです。
「パーセプトロンって、ニューラルネットワークと何が違うの?」「単純パーセプトロンで解けない問題って、どんな問題?」このような、G検定でニューラルネットワークの入口に来た方はいないでしょうか?
この記事では、第3次AIブームの技術として、身近な機械学習の応用(レコメンデーションエンジン、スパムフィルタ)、コーパスと統計的自然言語処理、そして人間の神経回路をまねた単純パーセプトロンを解説します。
ここで出てくる「重み」と「閾値」は、この先のディープラーニングすべての基礎になります。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- 第3次AIブームのきっかけは、2012年の画像認識大会でディープラーニング(AlexNet)が圧勝したこと
- パーセプトロンは、人間の神経回路(ニューロン)をまねた仕組み。1958年にローゼンブラットが考案
- 単純パーセプトロンは入力層と出力層の2層だけで、線形分離可能な問題しか解けない
- コーパスは、文章を大量に集めて整理したデータ。統計的自然言語処理や機械翻訳の材料になる
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第2章「機械学習」「ディープラーニング」、第4章「ニューラルネットワークとディープラーニング」ほかの範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
第3次AIブームとは
第3次AIブームとは、2000年代から現在にかけて、機械学習とディープラーニングでAIが急速に注目されていることを言います。
大きなきっかけは2012年の画像認識大会ILSVRCです。
トロント大学のチームが開発した「AlexNet」が、他を圧倒して優勝したことが衝撃的だったんですね。
この「AlexNet」に使われていたのがディープラーニングでした。
過去にもディープラーニングの考え方はあったのですが、コンピュータの性能やデータの量が足りず、うまく学習できていませんでした。
それが、GPUの進化とインターネット上の大量のデータ(ビッグデータ)によって実現できるようになり、現在のAIブームのきっかけを作ったと言われています。
ILSVRCについては特徴量とILSVRCの記事で解説しています。
人間の神経回路とパーセプトロン
人間の神経回路
最近よく聞く「ニューラルネットワーク」は、人間の神経回路をまねたプログラムのことです。人間の神経回路の主な特徴は次の2つです。
- 神経細胞同士の結合の強さによって、次のニューロンに伝わる電気の量が変わる
- 受け取った電気が閾値(しきいち)を超えると発火する(次のニューロンに伝わる)
人間の脳には、ニューロンという神経細胞がたくさんあります。
この神経細胞同士のつなぎ目(シナプス)の結合の強さによって、伝えられる電気の量が変わります。

さらに、ニューロンはすべての電気信号を別のニューロンに伝えるわけではありません。次のニューロンに伝えるには、ある程度の量(閾値)が必要なのです。
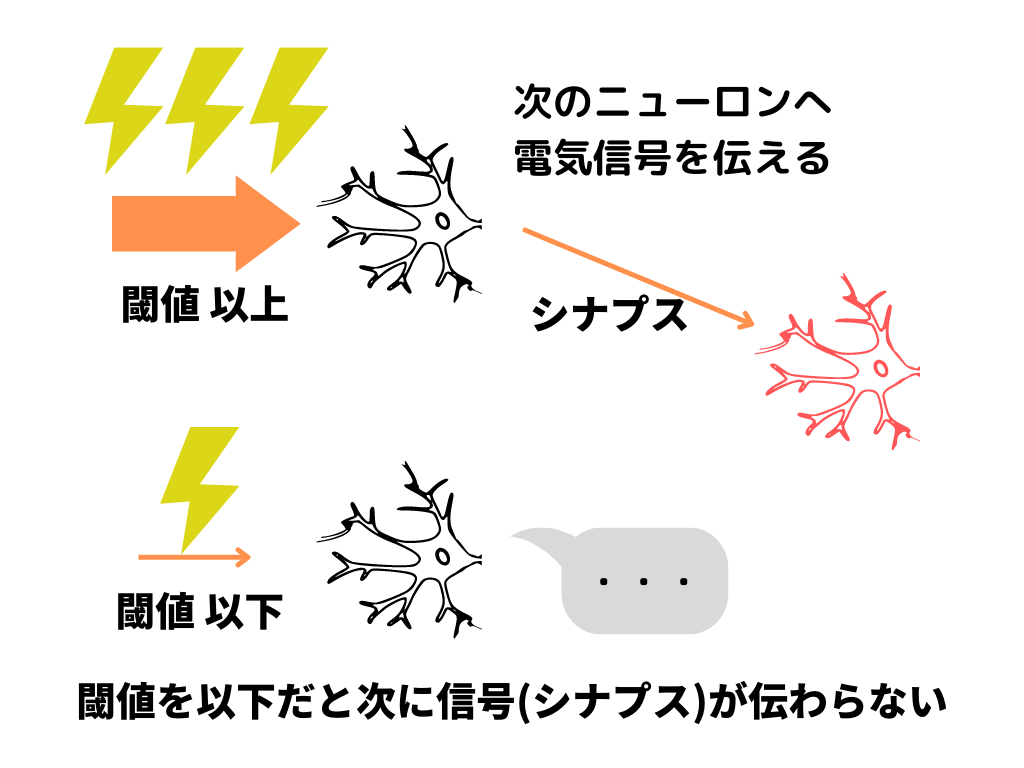
このようにニューロンが日々大量の情報(電気)をやりとりすることで、脳は「考える・判断する」ことができているようです。
パーセプトロンとは
パーセプトロンとは、人間の神経回路の仕組みをまねて、入力に重みを掛けて足し合わせ、閾値を超えたら1を出力する計算の仕組みのことです。
1958年に、アメリカの心理学者フランク・ローゼンブラットが考案しました。
人間の神経回路との対応は次の通りです。
| 人間の神経回路 | パーセプトロン |
|---|---|
| ほかのニューロンから届く電気信号 | 入力 |
| シナプスの結合の強さ | 重み |
| 閾値を超えたら発火する | 活性化関数(ステップ関数)とバイアス |
| 次のニューロンに伝える信号 | 出力 |
単純パーセプトロンの限界(線形分離)
単純パーセプトロンとは
単純パーセプトロンとは、入力層と出力層の2層だけで構成された、最もシンプルなニューラルネットワークのことです。

入力から送る信号に「重み」や「バイアス」をつけて活性化関数に送り、出力を決めます。
この構造が、今後たくさん出てくる「ニューラルネットワーク」「ディープラーニング」のすべての基礎です。
線形分離可能な問題しか解けない
単純パーセプトロンの弱点は、線形分離可能な問題しか解けないことです。
線形分離可能とは、グラフ上の2種類のデータを、1本の直線できれいに分けられることです。
例えば「AかつB(AND)」なら直線で分けられますが、「AとBのどちらか一方だけ(XOR、排他的論理和)」は、どう線を引いても1本の直線では分けられません。
この限界を1969年にマービン・ミンスキーらが指摘したことで、ニューラルネットワークの研究は一時下火になりました。
その後、隠れ層を加えた多層パーセプトロンと、それを学習させる誤差逆伝播法によって、XORのような問題も解けるようになります。
誤差逆伝播法(概要)
誤差逆伝播法とは、出力と正解データとの誤差を小さくするように、出力層に近い層から順に重みを調整していく方法のことです。
「出力」から「入力」と逆向きに計算が伝わっていくように見えるのが、名前の由来ですね。
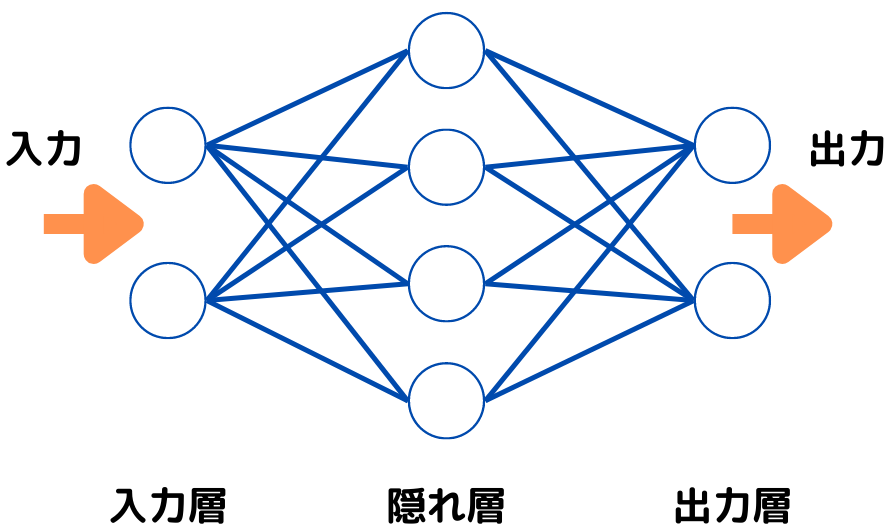
ここで覚えられなくても大丈夫です。仕組みや勾配消失問題は誤差逆伝播法の記事で詳しく解説しています。
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

機械学習の身近な応用
第3次AIブームでは、AIが私たちの身近なサービスで使われるようになりました。G検定では、その代表例として次の2つが問われます。
レコメンデーションエンジン
レコメンデーションエンジンとは、その名の通り、利用者におすすめの商品を勧めるシステムのことです。
利用者が購入・閲覧した商品と関連があり、購買意欲をかき立てるような商品を勧めてくれます。
Amazonの「この商品を買った人はこんな商品も買っています」が良い例でしょう。
中で使われている協調フィルタリングなどの手法は教師なし学習とレコメンドの記事で解説しています。
スパムフィルタ
スパムフィルタとは、迷惑メール(スパムメール)を自動で見分けて、振り分けたり削除したりする仕組みのことです。
スパムフィルターとも書きます。
Gmailや、ドコモ・auなどのキャリアメールにも「迷惑メール」というフォルダがありますよね。
過去の迷惑メールのデータから「迷惑メールらしさ」を学習して、新しく届いたメールを振り分けているのが、スパムフィルタです。
コーパスと統計的自然言語処理
コーパスとは
コーパスとは、文章を大量に集めて、コンピュータで扱えるように整理したデータのことです。
特に、原文と訳文をペアにして集めたものを対訳コーパスと言います。
従来の辞書は単語とその意味だけでしたが、コーパスは文章全体を、実際に使われた形のまま大量に集めているのがすごいところです。
データの集め方や加工の方法はデータの収集・加工の記事でも解説しています。
統計的自然言語処理とは
統計的自然言語処理とは、コーパスから単語の並び方や出現する確率を学習して、統計的に言葉を処理する方法のことです。
人が文法のルールを書くのではなく、「この単語の次にはこの単語が来やすい」「この英文はこう訳されることが多い」といった傾向を、大量の文章から確率として学ぶんですね。
翻訳に使ったものが統計的機械翻訳です。
ニューラル機械翻訳への流れ
対訳コーパスから学ぶという考え方は、ニューラルネットワークを使ったニューラル機械翻訳に引き継がれました。
ニューラルネットワークを用いることで、未知の文章でも「似たような意味の訳」を文全体の流れから作れるようになり、最近の機械翻訳は精度が大きく向上しています。
機械翻訳の3つの方式は機械翻訳の歴史の記事で比較しています。
G検定での問われ方
この記事の用語は、「何をするものか」と「年・人物」がよく問われます。
| 用語 | 一言でいうと | 覚えるポイント |
|---|---|---|
| 人間の神経回路 | ニューロンが閾値を超えると発火して信号を伝える | ニューラルネットワークのお手本 |
| 単純パーセプトロン | 入力層と出力層の2層だけのネットワーク | ローゼンブラット・1958年・線形分離可能な問題のみ |
| レコメンデーションエンジン | おすすめの商品を勧めるシステム | Amazonのおすすめ |
| スパムフィルタ | 迷惑メールを自動で振り分ける | 過去のメールから学習 |
| コーパス | 文章を大量に集めて整理したデータ | 対訳コーパスは原文と訳文のペア |
| 統計的自然言語処理 | コーパスから確率的に言葉を処理する | ルールを人が書かない |
よくある質問
Q. 単純パーセプトロンで解けない問題の例は?
XOR(排他的論理和)が代表例です。
「AとBのどちらか一方だけが1のときに1」という問題は、1本の直線ではデータを分けられないため、単純パーセプトロンでは解けません。
Q. コーパスとは何ですか?
文章を大量に集めて、コンピュータで扱えるように整理したデータです。
原文と訳文のペアを集めたものは対訳コーパスと呼ばれ、機械翻訳の学習に使われます。
Q. パーセプトロンとニューラルネットワークの違いは?
パーセプトロンは、ニューラルネットワークの一番基本の形です。
パーセプトロンを何層も重ねたもの(多層パーセプトロン)が、ニューラルネットワーク、さらに層を深くしたものがディープラーニングです。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- 第3次AIブームのきっかけは、2012年のILSVRCでのディープラーニング(AlexNet)の圧勝
- パーセプトロンは人間の神経回路をまねた仕組み(ローゼンブラット、1958年)
- 単純パーセプトロンは2層だけで、線形分離可能な問題しか解けない(XORは解けない)
- レコメンデーションエンジンとスパムフィルタは、身近な機械学習の応用例
- コーパスは文章を大量に集めたデータ。統計的自然言語処理や機械翻訳の材料になる
次は、第3次AIブームの続きとして、機械学習で一番大事な「特徴量」と、特徴量が増えすぎると起きる「次元の呪い」を特徴量と次元の呪いの記事で解説していきます。お楽しみに!
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。