主成分分析とは?教師なし学習の次元削減・t-SNEをわかりやすく解説
どーも、りけーこっとんです。
「主成分分析って、結局なにをしているの?」「t-SNEと主成分分析、どう使い分けるの?」このような、G検定の教師なし学習で手法の名前が多すぎて困っている方はいないでしょうか?
この記事では、教師なし学習の全体像と、得意分野の1つ「次元削減」の手法(主成分分析、特異値分解、t-SNE、多次元尺度構成法)を解説します。
さらに、文書のトピックを見つけるトピックモデルと潜在的ディリクレ配分法、レコメンドの手法(協調フィルタリングなど)までまとめました。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- 教師なし学習とは、正解データを使わずに、データの中の傾向やまとまりを見つける機械学習の手法
- 次元削減とは、データの特徴をなるべく残したまま、変数(次元)の数を減らすこと
- 主成分分析は分散が最大になる新しい軸に情報をまとめる。t-SNEとMDSは主に可視化に使う
- 協調フィルタリングは行動履歴、コンテンツベースフィルタリングは商品の特徴でおすすめを決める
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第3章「機械学習の概要」の「教師なし学習」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
教師なし学習とは
教師なし学習とは、どういう特徴や傾向があるか分からないデータから傾向を見出したり、似たデータをまとめたりする機械学習の手法です。
教師あり学習とは異なり、その名の通り「教師データ(正解データ)」がありません。
なので、教師なし学習で得られた結果を解釈するのは、分析者などの人間です。
教師あり学習と教師なし学習の違いは、次の図の通りです。
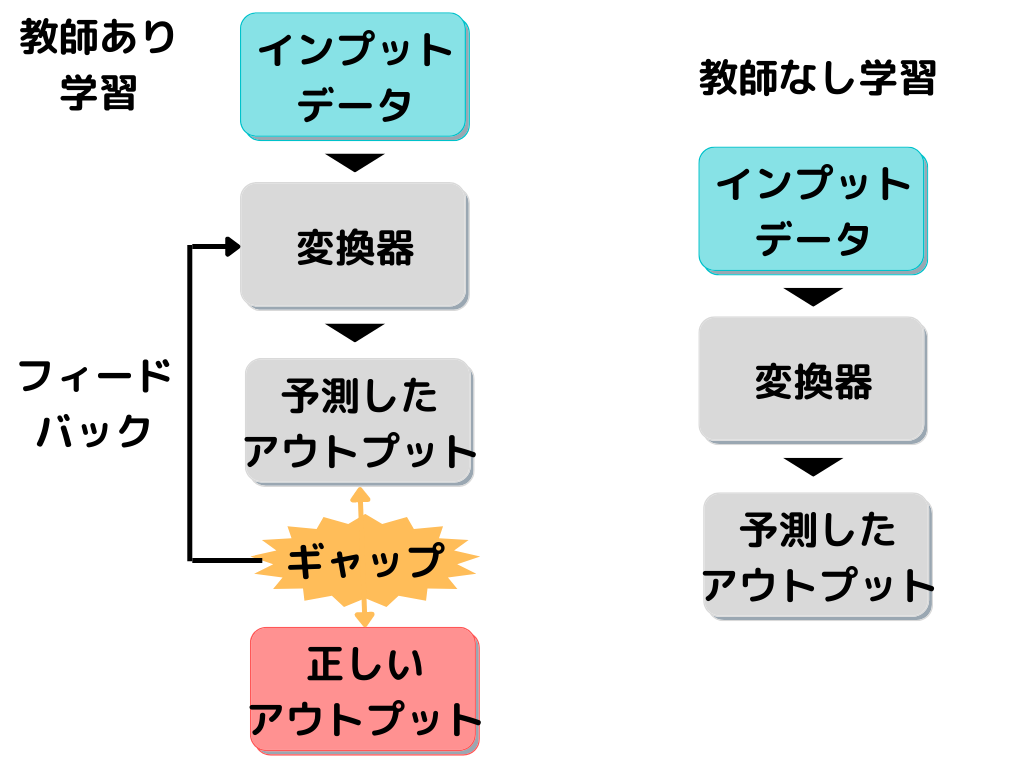
「正しいアウトプット」がないので、教師データがない、つまり「教師なし学習」というわけです。さらに教師なし学習のイメージはこんな感じです。
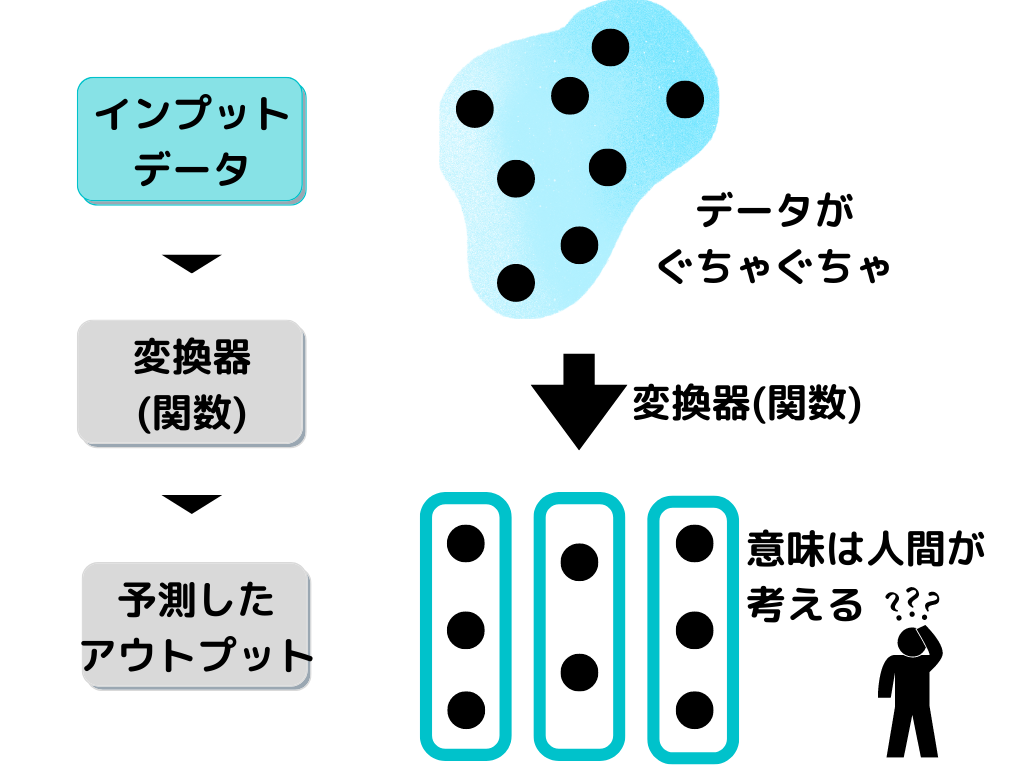
図のように、元々のデータには規則性がなく、ぐちゃぐちゃの状態です。そのデータに教師なし学習を行うことで、どういう規則性があるのか、パターンを見出します。
ただし、見つけたパターンの意味を解釈するのは人間です。規則性から何が言えるのかを考察することで、ビジネスに活かすことができますよね。
教師なし学習が得意なことは、大きく「次元削減」と「クラスタリング」です。
この記事では次元削減を中心に解説し、クラスタリングはk-means法とクラスタリングの記事で解説しています。
次元削減とは(なぜ次元を減らすのか)
次元削減とは、データの特徴をなるべく残したまま、より少ない変数(次元)で元のデータを表現しようとすることです。
「次元削減・圧縮」とも言います。
実際の現場でも、元データの変数が多すぎると計算に時間がかかってしまいますよね。
さらに、変数が増えすぎると必要なデータ量が爆発的に増える次元の呪いも起きます(次元の呪いの記事で解説しています)。
そこで、データの特徴をなるべく消さないように、データ量を少なくする方法がいろいろ考えられました。代表的な手法は次の通りです。
- 主成分分析(PCA)
- 特異値分解(SVD)
- t-SNE
- 多次元尺度構成法(MDS)
- 潜在的ディリクレ配分法(LDA)
- 非負値行列因子分解(NMF)
ニューラルネットワークを使った次元削減のオートエンコーダはオートエンコーダの記事で解説しています。それでは一つずつ見ていきましょう。
主成分分析(PCA)とは
主成分分析とは、たくさんの変数を、情報をなるべく失わない少数の新しい軸(主成分)にまとめる手法です。
Principal Component Analysisの略でPCAとも呼ばれます。イメージだと次の図のような感じです。
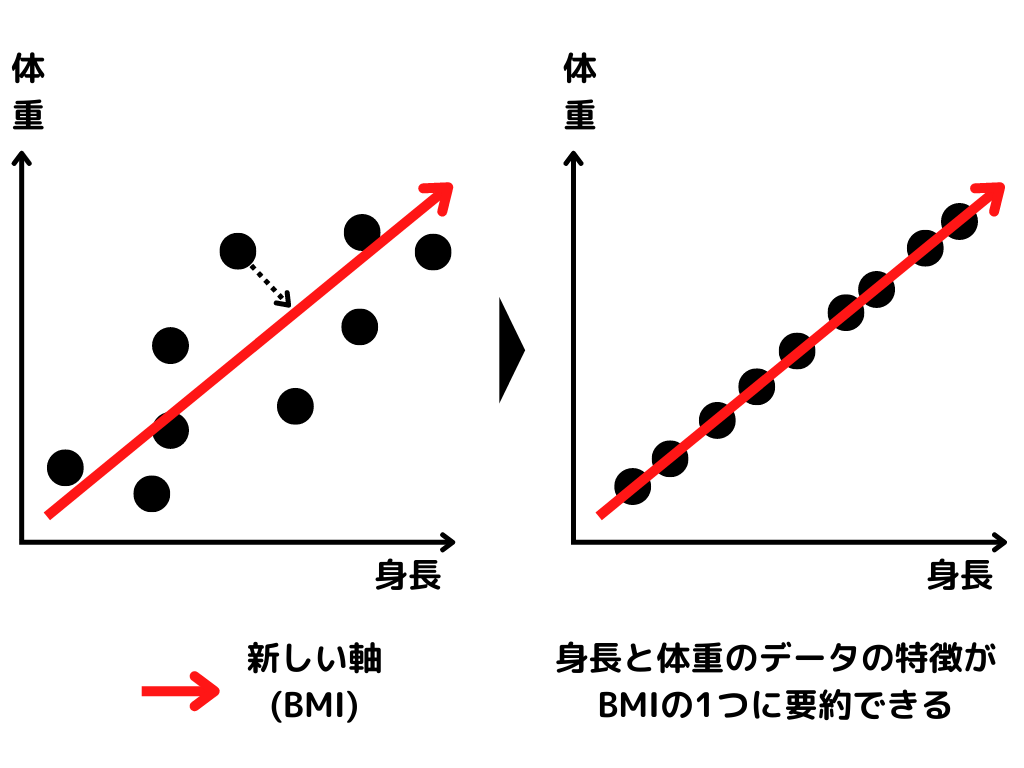
このように2軸あったデータに、新しい軸を1本引きます。
この新しい軸1本に情報を集約することで、2変数のデータが1変数のデータに変わっていますよね。これが主成分分析です。
新しい軸は、分散が最大になる方向に引きます。
分散はデータのばらつきのことで、ばらつきが大きい方向ほど、データの違いをよく表している(情報量が多い)からですね。
イメージとしては、体重と身長を「BMI」という1つの指標にまとめるような感じです(BMIそのものは主成分分析で作られたわけではありませんが、2つの変数を1つの軸で表す点が似ています)。
使いどころとしては、次のようなものがあります。
- 顧客満足度調査の結果をまとめる
- 複数ブランドのイメージマップを作る
- 特徴量間の相関関係をビジュアルで理解したいとき
特異値分解(SVD)とは
特異値分解とは、1つの行列を、3つの行列の掛け算に分解する手法です。
Singular Value Decompositionの略でSVDとも言われます。
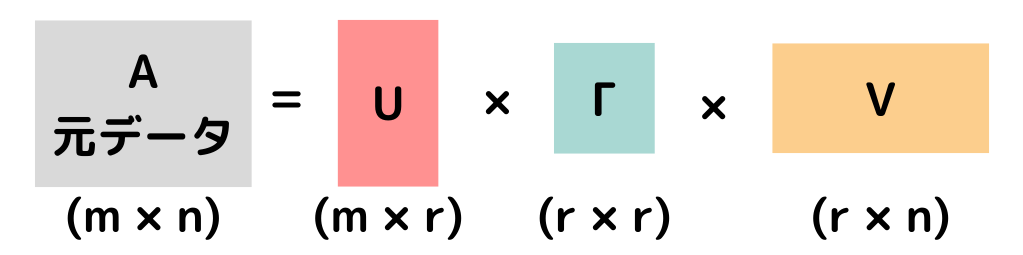
元の行列(A)を、左特異ベクトル(U)・特異値(図ではΓ)・右特異ベクトル(V)の3つに分ける、ということを行っていますが、専門用語が多いので「そんなもんなのね」でG検定は良いと思います。
特異値分解を行うと、次のようなメリットがあります。
- 行列の特徴が、特異値の大きさで見えやすくなる
- 小さい特異値を無視する(次元削減する)ことで、高い精度で近似計算できる
- 近似することで、計算コストやデータ量を減らせる
主成分分析の計算の中でも、特異値分解が使われています。
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

t-SNEと多次元尺度構成法(MDS)(可視化の手法)
t-SNEとは
t-SNEとは、高次元のデータを2次元や3次元に圧縮して、似たデータが近くに並ぶように可視化する次元削減の手法です。
ほかの次元削減と異なるのは、次の点です。
- データの局所的な構造(似たデータを、低次元でも近くに保つこと)を維持できる
- 高次元の非線形なデータでも、似たものを近くに保ったまま圧縮できる
近くに保つために、距離の分布を使うのですが、低次元側ではスチューデントのt分布を使っています。
t-SNEのtは、t分布のtですね(t分布とは何か、までは知らなくても大丈夫だと思います)。
多次元尺度構成法(MDS)とは
多次元尺度構成法とは、データ同士の似ている度合い(距離)をもとに、似たものは近く、違うものは遠くになるように2次元や3次元に配置する手法です。
Multi-Dimensional Scalingの略でMDSとも言われます。主成分分析の仲間の、多変量解析の手法の1つですね。作成できるグラフは次のようなものです。
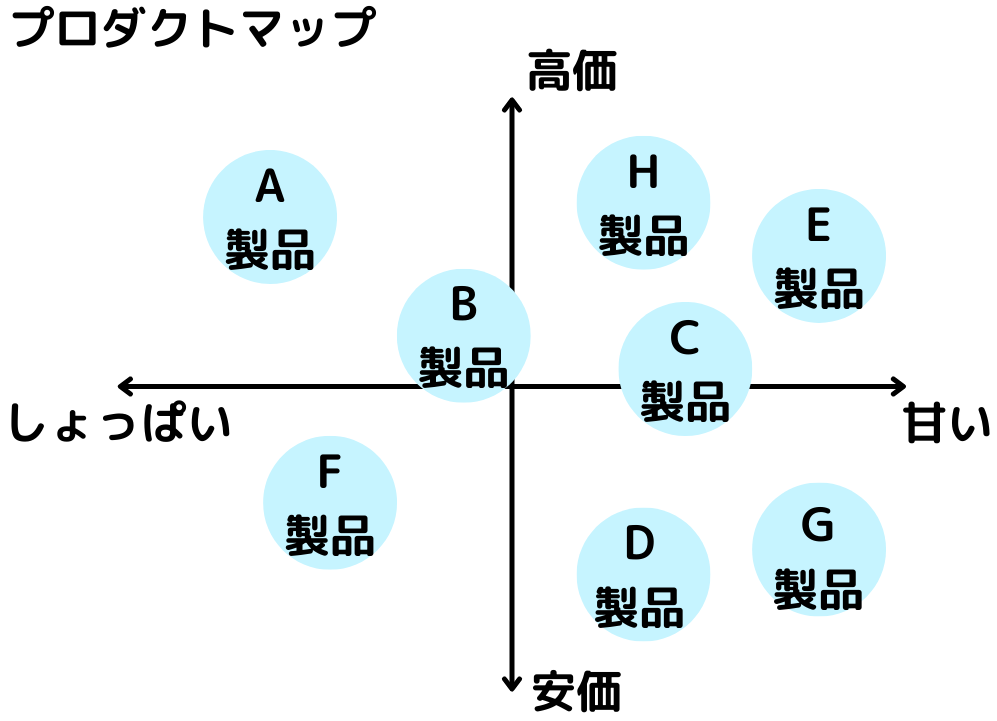
自社製品と他社製品を比べるプロダクトマップなど、マーケティング分野との相性が良いようです。
非負値行列因子分解(NMF)
非負値行列因子分解とは、全部の成分が0以上の行列を、同じく0以上の2つの行列の掛け算に分解する手法です。
情報量が多すぎる1つの行列から、掛けると元の行列に近くなる2つの小さな行列を求めることで、データを少なくできます。
自然言語処理の計算効率を上げたり、画像の特徴抽出に使われたりします。
トピックモデルと潜在的ディリクレ配分法(LDA)
トピックモデルとは
トピックモデルとは、文書が複数の潜在的なトピックから確率的に作られると考えて、文書に含まれるトピックを見つけるモデルのことです。
トピックごとに単語の出やすさ(出現頻度の分布)を想定することで、トピック同士の似ている度合いや意味を理解できるようになります。
簡単に言ってしまえば「たくさんある文書(記事など)は、それぞれどういうトピックに分類できるのかな?」を考えられるモデルです。
潜在的ディリクレ配分法とは
潜在的ディリクレ配分法(LDA)とは、トピックモデルの代表的な手法で、文書と単語の行列を「文書×トピック」と「トピック×単語」の2つに分解して、トピックを見つけるものです。
新しく入るトピックの要素が、文書と単語をつなぐ役割をしています。
潜在的ディリクレ配分法では、次のような三角形のグラフが得られます。
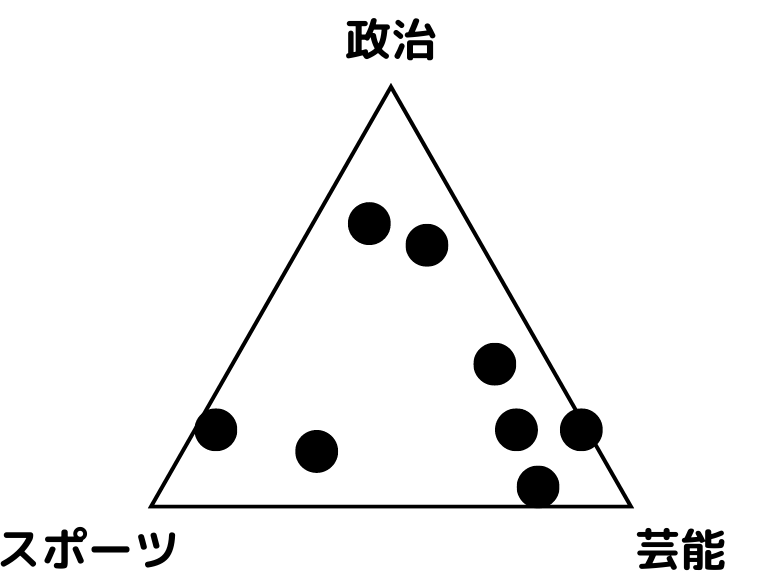
各頂点にある「政治」「芸能」「スポーツ」がトピックで、トピックは実際に文書に出てきた単語で構成されています(「政治」なら内閣、選挙、衆議院…、「スポーツ」ならサッカー、野球、NBA…)。
頂点に近い文書ほど、そのトピックの文書だと読み解けます。1つの文書が複数のトピックを持てるのがポイントです。
使いどころは、ニュース記事のトピック分類や、ユーザーのプロファイリングなどです。
なお、G検定では同じ「LDA」という略称で線形判別分析(教師あり学習の分類手法)もあるので、混同しないように注意しましょう。
レコメンドの手法
レコメンデーションとは、顧客の閲覧履歴や購入履歴をもとに、顧客に合った商品を自動的に勧めることです。
Amazonや楽天の「この商品を買った人はこんな商品も買っています」が身近な例ですね。シラバスには、その手法として次の2つが載っています。
協調フィルタリング
協調フィルタリングとは、対象者と似た行動履歴を持つ人のデータから、おすすめの商品を決める手法です。
一番想像しやすい手法ではないでしょうか。
「AさんとBさんは買う物が似ている。Bさんが買ったこの商品を、Aさんはまだ買っていないから勧めよう」という考え方です。
対象者とそれ以外の人の購入・閲覧データの相関を見て、行動履歴を関連づけることで行います。
コールドスタート問題
コールドスタート問題とは、協調フィルタリングで、データが少ないために適切なおすすめができない問題のことです。次のような場面で起こります。
- 新規顧客は行動履歴が少なく、似ている人を見つけられない
- 新商品は誰にも買われていないので、勧める根拠がない
つまり、元となる「行動履歴」のデータが少なすぎて、上手くおすすめできないという問題ですね。
コンテンツベースフィルタリング
コンテンツベースフィルタリングとは、商品そのものの特徴(ジャンル、価格、成分など)が似ている商品をおすすめする手法です。
行動履歴をもとにはせず、あくまで商品の内容に注目して似た商品を勧めます。
例えば「新宿・和食」の店を見ている人に、同じ条件のお店を勧めるイメージですね。
商品の特徴さえ分かれば勧められるので、コールドスタート問題が起きにくいのが強みです。
手法の比較表
G検定では「どの手法が何に向いているか」がよく問われます。
| 手法 | 何をするか | 向いている使い方 |
|---|---|---|
| 主成分分析(PCA) | 分散が最大の軸に情報をまとめる | 変数を減らす、相関を理解する |
| 特異値分解(SVD) | 行列を3つに分解する | データの圧縮・近似 |
| t-SNE | 似たデータを近くに保って2〜3次元に圧縮 | 高次元データの可視化(非線形もOK) |
| 多次元尺度構成法(MDS) | 似ている度合いをもとに点を配置 | プロダクトマップ |
| 潜在的ディリクレ配分法(LDA) | 文書を複数トピックの混ざり方で表す | 文書の分類・トピック抽出 |
| 協調フィルタリング | 似た人の行動履歴で勧める | ECサイトのおすすめ(コールドスタート問題あり) |
| コンテンツベースフィルタリング | 似た特徴の商品を勧める | 新商品・新規顧客にも勧められる |
現行シラバスの「教師なし学習」のキーワードは、すべて次の表で確認できます。
| 用語 | 一言でいうと | 詳しい解説 |
|---|---|---|
| k-means法 | あらかじめ決めたk個のグループに、重心との距離で分けるクラスタリング手法 | 解説記事 |
| t-SNE | 高次元データを2〜3次元に落として可視化する手法。近いもの同士の関係を保つ | この記事 |
| ウォード法 | 階層的クラスタリングで、まとめたときのばらつきの増え方が最小になる組を順に結合する方法 | 解説記事 |
| 協調フィルタリング | 「自分と似た人が好きなもの」を勧める推薦方法。購買履歴などを使う | この記事 |
| クラスタリング | 正解ラベルなしで、似たデータ同士をグループに分けること | 解説記事 |
| コールドスタート問題 | 新しい利用者や商品は履歴がなく、協調フィルタリングで推薦できない問題 | この記事 |
| コンテンツベースフィルタリング | 商品自体の特徴(ジャンル等)が好みに近いものを勧める推薦方法 | この記事 |
| 次元削減 | 情報をなるべく失わずに、特徴量の数(次元)を減らすこと | この記事 |
| 主成分分析(PCA) | データのばらつきが最大になる方向に軸を取り直して次元を減らす手法 | この記事 |
| 潜在的ディリクレ配分法(LDA) | 文書が複数のトピックの混ざり合いでできていると考え、トピックを推定する手法 | この記事 |
| 多次元尺度構成法(MDS) | データ同士の距離関係をできるだけ保って低次元に配置する手法 | この記事 |
| デンドログラム(樹形図) | 階層的クラスタリングの結合の順番を木の形で表した図 | 解説記事 |
| 特異値分解(SVD) | 行列を3つの行列の積に分解する方法。次元削減や推薦に使う | この記事 |
| トピックモデル | 文書の背後にある話題(トピック)を推定するモデルの総称。LDAが代表 | この記事 |
よくある質問
Q. 主成分分析とt-SNEの使い分けは?
主成分分析は、データ全体のばらつきを残しながら変数を減らしたいときに使います。
t-SNEは、似たデータ同士の近さを保つのが得意なので、高次元のデータを2次元のグラフにして眺めたい(可視化したい)ときに使います。
Q. LDAという略語が2つあるのはなぜ?
英語の頭文字がたまたま同じだからです。
Latent Dirichlet Allocation(潜在的ディリクレ配分法)は教師なし学習のトピックモデル、Linear Discriminant Analysis(線形判別分析)は教師あり学習の分類手法です。
Q. 次元削減で情報は失われませんか?
少しは失われます。そのため主成分分析では、元のデータのばらつき(情報)をどれだけ残せたかを「寄与率」で確認しながら、残す次元の数を決めます。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- 教師なし学習:正解データなしで、データの傾向やまとまりを見つける。解釈は人間が行う
- 次元削減:データの特徴を残したまま変数を減らす。次元の呪いの対策にもなる
- 主成分分析は分散が最大の軸にまとめる、特異値分解は行列を3つに分解する
- t-SNEとMDSは可視化向き。LDAは文書を複数トピックの混ざり方で表すトピックモデル
- 協調フィルタリングは行動履歴、コンテンツベースフィルタリングは商品の特徴で勧める
次回は、教師なし学習のもう1つの代表「クラスタリング」を、k-means法と階層的クラスタリング(デンドログラム)を中心にk-means法の記事で解説していきます。
しっかり押さえて、合格を目指しましょう!
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。