特徴量とは?次元の呪い・ILSVRCと第3次AIブームを解説
どーも、りけーこっとんです。
「特徴量って、結局なにを指しているの?」「次元の呪いって、名前は怖いけど何が起きるの?」このような、G検定で機械学習の基本用語につまずいている方はいないでしょうか?
この記事では、第3次AIブームの続きとして、機械学習で一番大事な「特徴量」と、特徴量を増やしすぎると起きる「次元の呪い」を、表と図で解説します。
あわせて、ブームのきっかけになったImageNetとILSVRC、機械学習の定義、パターン認識・一般物体認識・OCRも整理しました。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- 特徴量とは、データの特徴を表す量のこと。機械学習のモデルに入力するデータでもある
- 次元の呪いとは、特徴量(次元)を増やすと、必要なデータ数が指数関数的に増えてしまう問題
- ILSVRCはImageNetの画像を使った画像認識の大会。2012年にトロント大学のAlexNetが圧勝した
- 機械学習の定義は、アーサー・サミュエルの「明示的にプログラムしなくても学習する能力をコンピュータに与える研究分野」
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第2章「人工知能をめぐる動向」の「機械学習」「ディープラーニング」、第6章「画像認識」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
特徴量とは|データのどこに注目するか
特徴量とは、データの特徴を表す量のことです。
機械学習のモデルにインプットさせるデータでもあります。説明変数と言われることもあります。
エクセルの表データでイメージすると分かりやすいかもしれません。

例えば上の表で「売上」というデータの特徴を表したいとします。
すると、列名にも入っている「場所」「来店者数」「商品数」が「売上」に影響していそうではないでしょうか。「ID」は微妙ですよね。
別の言い方をすると、「売上」というデータの特徴を「場所」「来店者数」「商品数」が表していそうです。この「場所」「来店者数」「商品数」を特徴量と言います。
りけーこっとんも実務でデータを扱うときは、どの特徴量を使うかを決める特徴量設計に一番時間をかけています。
ここで良い特徴量を選べるかどうかで、予測の精度が大きく変わるんですね。特徴量設計については特徴量設計とフレーム問題の記事でも触れています。
特徴量を絞る(特徴抽出)
元データの特徴量を全て学習しても良いのですが、それだとビッグデータは計算に時間がかかりすぎてしまいますよね。
そこで、分析に重要だと思われる特徴量を少数に絞ったり、まとめたりして学習することがあります。
(Kaggleのようなデータコンペで分析するときも基本の概念ですね)
必要最低限な特徴量に絞ることで、よりたくさんのデータを短い時間で計算できるようになります。
特徴量を絞る理由は計算時間だけではありません。それが次の「次元の呪い」です。
次元の呪いとは
次元の呪いとは、特徴量の数(次元)を増やすと、学習に必要なデータの数が指数関数的に増えてしまう問題のことです。
「次元」というのは、特徴量の数とも言えます。次元の呪いでは、次の2つのことが起きます。
- 次元を増やすと、必要なデータ数が指数関数的に増えていく
- データの空間が膨張する(データの端同士の距離が遠くなる)
イメージは次の図のような感じです。

1つの特徴量を3段階に分けるとします。
このように全データを埋めようとすると、必要なデータ数は1次元で3、2次元で9、3次元で27と、一気に増えていきます。
これが指数関数的に増えていく、ということですね。
さらに、データの端同士の距離も3→√18(4.24…)→√27(5.19…)とだんだん遠くなっています。
これが「データの空間が膨張する」ということです。データ同士がスカスカに離れてしまうので、似ているデータを見つけにくくなり、モデルの精度が落ちてしまいます。
次元の呪いへの対策
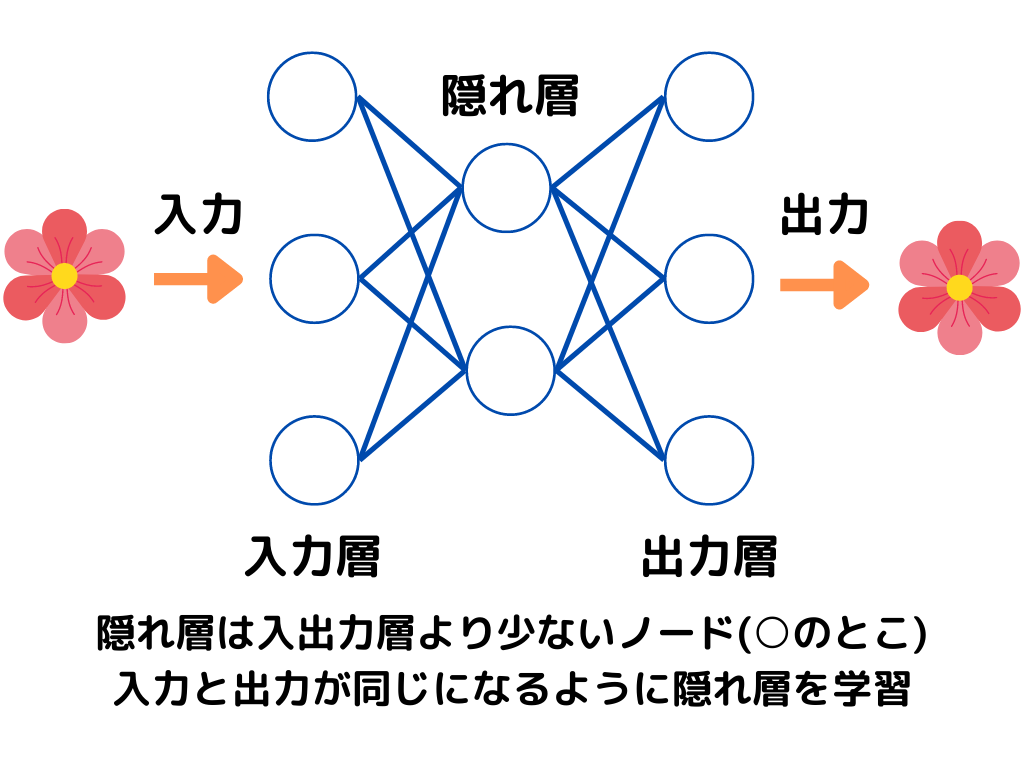
対策は、特徴量の数を減らす次元削減です。代表的な方法が、統計的な手法の主成分分析や、ニューラルネットワークを使ったオートエンコーダですね。
オートエンコーダは入力層・隠れ層・出力層で構成され、隠れ層の次元を入力より少なくすることで、元のデータの特徴を損なわないように次元を減らします。
主成分分析は主成分分析の記事、オートエンコーダはオートエンコーダの記事で詳しく解説しています。
第3次AIブームとは|機械学習とビッグデータの時代
第3次AIブームとは、2000年代から現在にかけて、機械学習とディープラーニングでAIが急速に注目されていることを言います。
2000年代にはインターネットの普及で大量のデータ(ビッグデータ)が集まるようになり、まず機械学習が実用的になりました。
そして決定的なきっかけになったのが、2012年の画像認識大会です。
トロント大学のチームが開発した「AlexNet」が、ディープラーニングで他を圧倒して優勝したことが衝撃的だったんですね。
今までもディープラーニングの考え方はあったのですが、コンピュータの性能上できていませんでした。
それが、GPUなど計算機の性能が今までとは比べものにならないくらい上がったことで実現し、現在のAIブームのきっかけを作ったと言われています。
ImageNetとILSVRC|2012年に何が起きたか
ImageNetとは
ImageNetとは、1,400万枚以上の画像に、写っているものの名前(ラベル)を付けた大規模な画像データベースのことです。
2万種類以上のカテゴリがあり、画像認識の研究に広く使われています。
ILSVRCとは
ILSVRCとは、ImageNetの画像を使って画像認識の精度を競う大会のことです。
ImageNet Large Scale Visual Recognition Challengeの略で、2010年から2017年まで開かれました。
ILSVRCではなく最初の単語だけを取って「ImageNet(のコンテスト)」と呼ぶ人も多いようです。
上でも述べましたが、2012年にトロント大学(ジェフリー・ヒントンのチーム)のAlexNetが、2位に10ポイント以上の差をつけて優勝しました。
それまでは、人間が特徴量を設計する従来の手法が主流でしたが、この年を境にディープラーニングが一気に主役になります。
2012年以降もILSVRCは開かれ、2015年にはResNetが人間の認識精度を上回る誤り率を出すなど、画像認識の技術は飛躍的に向上しました。
今の画像認識技術があるのは、この大会での衝撃からと言っていいでしょう。
各年の優勝モデルはVGGとGoogLeNet・ResNetの記事で解説しています。
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

機械学習の定義
最近は色々な所で「機械学習」という言葉を耳にするようになりました。この「学習」とは何なのでしょうか。
機械学習の定義として有名なのが、アーサー・サミュエルの「明示的にプログラムしなくても学習する能力をコンピュータに与える研究分野」という言葉です。
1959年、チェッカー(西洋のボードゲーム)のプログラムを作ったアーサー・サミュエルが述べました。
人がルールを1つ1つ書くのではなく、データからパターンを見つけて、入力をパターン分類できるようになることが「学習」なんですね。
具体的には、次のようなことができるようになりました。
パターン認識・一般物体認識・OCR
パターン認識
パターン認識とは、入力されたデータに、どのような傾向(パターン)があるかが分かることです。
少ないデータなら人間でも「これとこれは関係がありそうだな」「これらはまとめられそう」などとパターンが分かります。
大量のデータになってくると人間が調べるのは無理なので、機械が似たデータをまとめたり、分類したりしてくれるんです。
画像認識
画像認識とは、その名の通り、機械が画像を認識できることです。
聞いたことがある人も多いと思います。例えば機械に入力された画像が猫の写真なのか犬の写真なのかを判断する、といったような感じですね。
一般物体認識
一般物体認識とは、画像に写っている一般的なもの(犬、車、いすなど)が何かを、機械が認識できることです。
これは画像認識と被ってくるところもあります。
似た言葉の特定物体認識は「この写真は東京タワーだ」のように、決まった特定の物体を見分けることです。
一般物体認識は「タワー」「建物」のような一般的な名前で認識するので、特定物体認識より難しいとされています。
画像のどこに何が写っているかまで判断する手法は物体検出の記事で解説しています。
OCR
OCRは、光学的文字認識(Optical Character Recognition)の略です。
OCRとは、画像に写った文字を機械が読み取り、コンピュータで使えるデジタルの文字データに変換する技術のことです。
紙の書類をスキャンして、文字をコピーできるようにする機能が身近な例ですね。
G検定での問われ方
この記事の用語は、「何をするものか」と「年・人物・数字」の組み合わせで問われます。
| 用語 | 一言でいうと | 覚えるポイント |
|---|---|---|
| 特徴量 | データの特徴を表す量 | 説明変数とも言う |
| 次元の呪い | 次元を増やすと必要なデータ数が指数関数的に増える | 対策は次元削減 |
| ImageNet | ラベル付きの大規模な画像データベース | 1,400万枚以上 |
| ILSVRC | ImageNetを使った画像認識の大会 | 2012年にAlexNet(トロント大学)が圧勝 |
| 機械学習の定義 | 明示的にプログラムしなくても学習する能力 | アーサー・サミュエル・1959年 |
| 一般物体認識 | 一般的な物体の名前を認識する | 特定物体認識より難しい |
| OCR | 画像の文字をデジタルの文字に変換する | 光学的文字認識 |
よくある質問
Q. 特徴量と説明変数は同じ意味?
ほぼ同じ意味で使われます。統計学では「説明変数」、機械学習では「特徴量」と呼ぶことが多く、どちらも予測したい値(目的変数)を説明するために使うデータを指します。
Q. 次元の呪いを避けるにはどうしますか?
特徴量の数を減らす次元削減を行います。予測に関係の薄い特徴量を外したり、主成分分析やオートエンコーダで情報をまとめたりする方法があります。
Q. ILSVRCで2012年に優勝したのは?
トロント大学のジェフリー・ヒントンのチームが開発したAlexNetです。ディープラーニングを使い、2位に大差をつけて優勝したことで、第3次AIブームのきっかけになりました。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- 特徴量:データの特徴を表す量。どの特徴量を使うかで予測の精度が変わる
- 次元の呪い:次元を増やすと必要なデータ数が指数関数的に増え、データ同士が離れてしまう
- ILSVRC:ImageNetの画像を使った大会。2012年にAlexNet(トロント大学)が圧勝
- 機械学習の定義:明示的にプログラムしなくても学習する能力を与える研究分野(アーサー・サミュエル)
- 一般物体認識は特定物体認識より難しい。OCRは画像の文字をデジタルの文字に変える技術
今までAIブームは何度もあった、ということを見てきましたよね。でも途中で途切れている時期があるということは、それぞれのブームに問題点があったからです。
次は、AIがぶつかってきた壁をフレーム問題・チューリングテストの記事で解説していきます。お楽しみに!
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。