オートエンコーダとは?ボルツマンマシン・深層信念ネットワークを解説
どーも、りけーこっとんです。
「オートエンコーダって、入力と出力が同じなのに何がうれしいの?」「ボルツマンマシンと深層信念ネットワーク、関係がよく分からない」
このような、G検定のディープラーニングの範囲で手が止まっている方はいないでしょうか?
この記事では、ディープラーニングが実用化されるきっかけになったオートエンコーダと事前学習、そこから発展した変分オートエンコーダ(VAE)、そしてボルツマンマシンと深層信念ネットワークを解説します。
名前が似ているものが多いので、最後に比較表で整理しました。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- オートエンコーダとは、入力と同じものを出力するように学習し、隠れ層に入力の特徴を圧縮して取り出すニューラルネットワーク
- 積層オートエンコーダは、オートエンコーダを重ねて、入力層に近い層から順に学習させる事前学習の方法
- 変分オートエンコーダ(VAE)は、隠れ層を確率分布として学ぶことで、新しいデータを生成できるオートエンコーダ
- 深層信念ネットワークは、2006年にジェフリー・ヒントンが提案した、制限付きボルツマンマシンを積み重ねたモデル
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第5章「オートエンコーダ」、第6章「転移学習・ファインチューニング」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
- 紙で手元に置きたい方は → G検定カンペの印刷用PDF(無料・A4・15ページ)をダウンロードできます
オートエンコーダとは
オートエンコーダとは、入力と同じものを出力するように学習することで、隠れ層に入力データの特徴を少ない次元で取り出すニューラルネットワークの構造です。
自己符号化器とも呼ばれます。
入力層・隠れ層・出力層の3層で構成され、入力と出力の形が同じになるようになっています。隠れ層は、入力層よりも次元数が少なくなるように作ります。
こうすることで隠れ層は、元のデータの特徴をなるべく損なうことなく、より少ない次元で表現できるようになるんですね。
- 入力層→隠れ層:データを圧縮する部分(エンコーダ)
- 隠れ層→出力層:圧縮したデータから元に戻す部分(デコーダ)
オートエンコーダのイメージ図は次のような感じです。
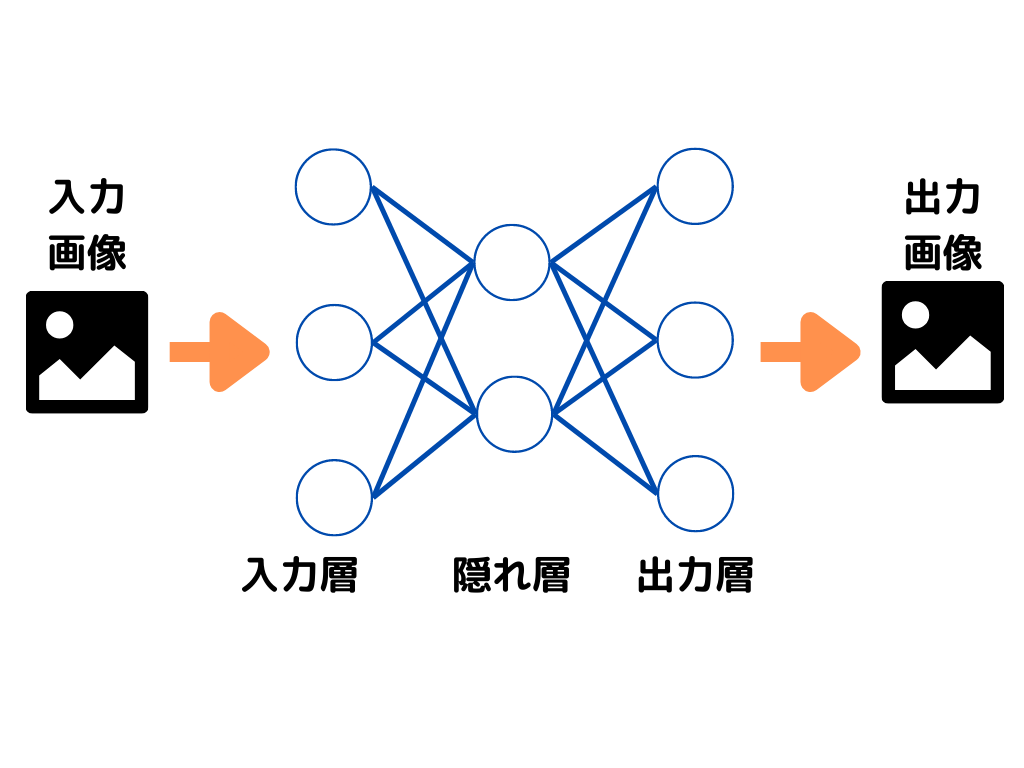
正解ラベルを使わず、入力そのものを正解にして学ぶので、教師なし学習の一種と言えます。使いどころは次の2つが代表的です。
- 次元削減:画像のようにデータ量が膨大なものを、特徴を残したまま小さくして計算量を減らす(教師なし学習の次元削減と同じ目的)
- 異常検知:正常なデータだけで学習させると、異常なデータはうまく元に戻せない(復元の誤差が大きくなる)ので、異常を見つけられる
異常検知は、工場の製品検査などで実際によく使われています。
積層オートエンコーダと事前学習
積層オートエンコーダとは
積層オートエンコーダとは、オートエンコーダを何層も積み重ねたものです。
つまりオートエンコーダの「隠れ層」が増えたもの、ということになりますね。学習の流れは次の図の通りです。
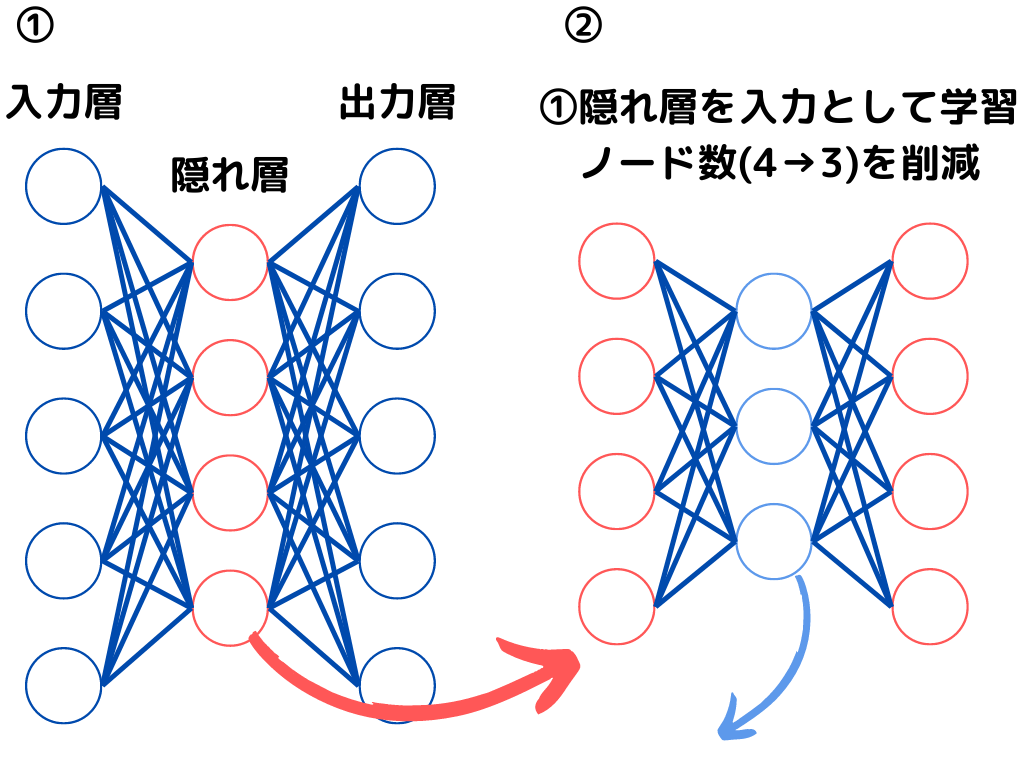
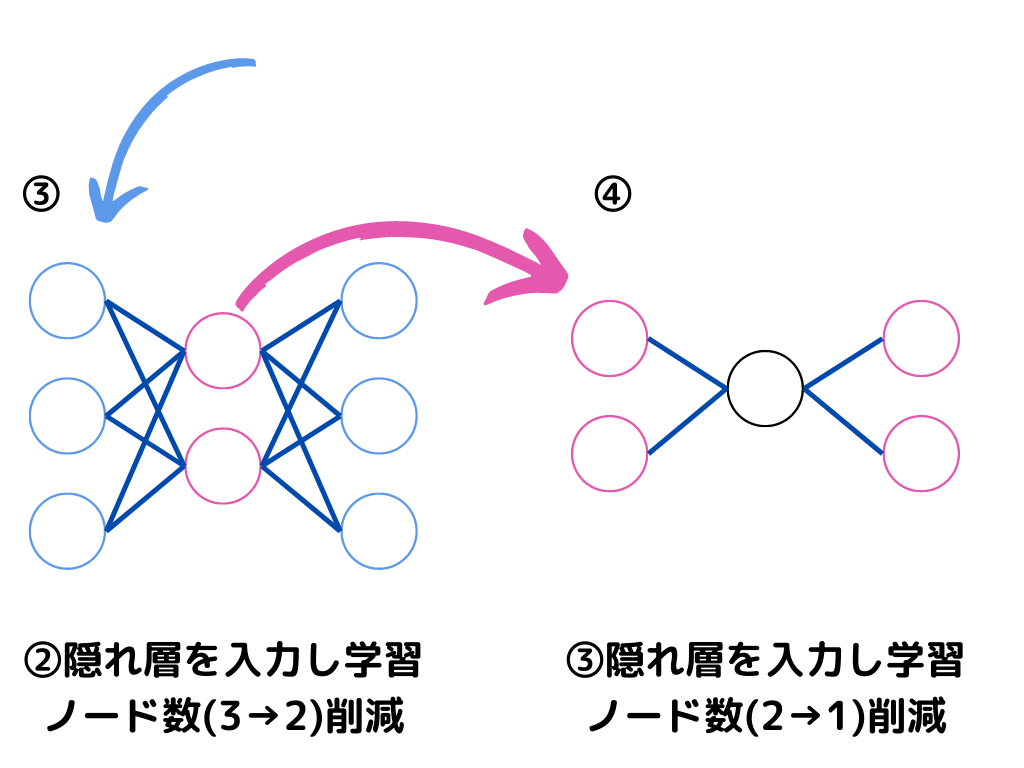
このように、入力層に近い層から順に、1層ずつオートエンコーダとして学習させていきます。
ただし、これだけでは「隠れ層の学習」しかできていません。実際に使うときは、次の図のように最後に出力層を付け加えて、全体を調整してモデルが完成します。
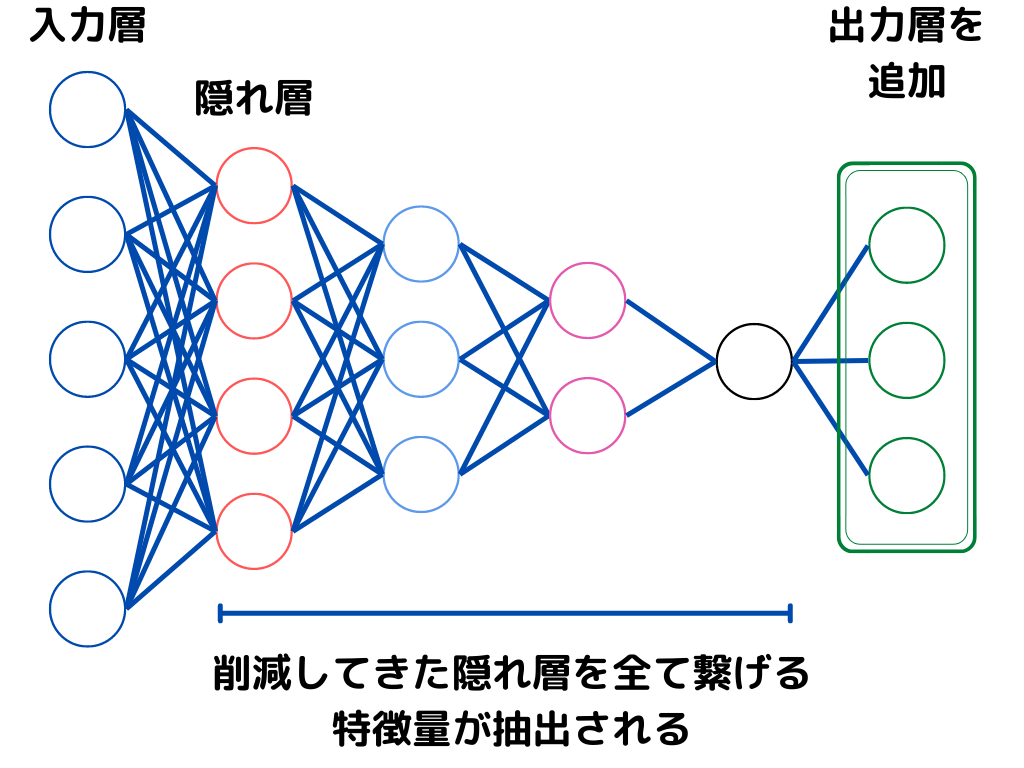
事前学習とは
事前学習とは、本番の学習の前に、重みをあらかじめ良い値に近づけておくための学習のことです。
積層オートエンコーダのように1層ずつ学習させてから全体を調整する方法は、層を深くすると学習が進まなくなる勾配消失問題への対策として、2006年ごろに注目されました。
その後、ReLU関数などの登場で、この1層ずつの事前学習はあまり使われなくなっています。
ただし「事前学習」という考え方そのものは、今も大活躍しています。BERTやGPTのように、大量のデータで先に学習させた事前学習済みモデルを、目的に合わせて調整して使う方法が主流になっているんですね。
転移学習・ファインチューニング・蒸留
事前学習したモデルの使い方として、次の3つは混同しやすいので違いを押さえておきましょう。
| 方法 | やること | 目的 |
|---|---|---|
| 転移学習 | 学習済みモデルの出力層だけを入れ替えて、新しい作業用に学習する(他の層の重みはそのまま) | 少ないデータで別の作業に使う |
| ファインチューニング | 出力層の入れ替えに加えて、学習済みモデルの重みも少しずつ更新する | 別の作業に、より細かく合わせる |
| 蒸留 | 大きな学習済みモデルの出力をお手本にして、小さいモデルを学習させる | モデルを軽くする |
転移学習とファインチューニングは転移学習とファインチューニングの記事、蒸留はモデル軽量化の記事で詳しく解説しています。
変分オートエンコーダ(VAE)とその発展
変分オートエンコーダ(VAE)とは
変分オートエンコーダ(VAE)とは、隠れ層を1つの値ではなく確率分布(平均と分散)として学習することで、新しいデータを生成できるようにしたオートエンコーダです。
普通のオートエンコーダは、入力を圧縮して元に戻すことしかできません。
VAEは、隠れ層(潜在空間)を「この辺りに数字の3っぽい画像が集まっている」という分布として学ぶので、その分布から新しい点を取り出してデコーダに通すと、学習データにない新しいデータを生成できます。
画像生成AIの初期の代表的な手法ですね。
学習の誤差には、元に戻す誤差に加えて、分布の違いを表すKLダイバージェンス(誤差関数の記事で解説)が使われます。
生成モデルとしてのVAEとGAN・拡散モデルの違いはGANと生成AIの記事で比較しています。
β-VAE・info VAE・VQ-VAE
VAEにはいくつかの発展形があります。G検定では名前と「何を改良したか」を押さえておけば十分です。
| モデル | 何を改良したか |
|---|---|
| β-VAE | KLダイバージェンスの重みβを大きくして、潜在空間の各軸が「顔の向き」「髪の色」のように別々の特徴を表すようにした(もつれをほどく) |
| info VAE | VAEで潜在空間の情報が十分に使われない問題を、誤差の計算方法を変えて改善した |
| VQ-VAE | 潜在空間を連続的な値ではなく、辞書(コードブック)から選ぶ離散的な値で表すようにした。2017年にDeepMindが発表 |
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

ボルツマンマシンと深層信念ネットワーク
ボルツマンマシンとは
ボルツマンマシンとは、1985年にジェフリー・ヒントンらが提案した、ノードが確率的に0か1の値を取るニューラルネットワークの一種です。
入力層(可視層)と隠れ層の2種類のノードからなり、信号を伝えるかどうかを確率的に決めます。
さらに、異なる層の間だけでなく、同じ層の中でも双方向に情報をやり取りし合うので、複雑な組み合わせの問題を解くことができました。イメージは次のような感じです。
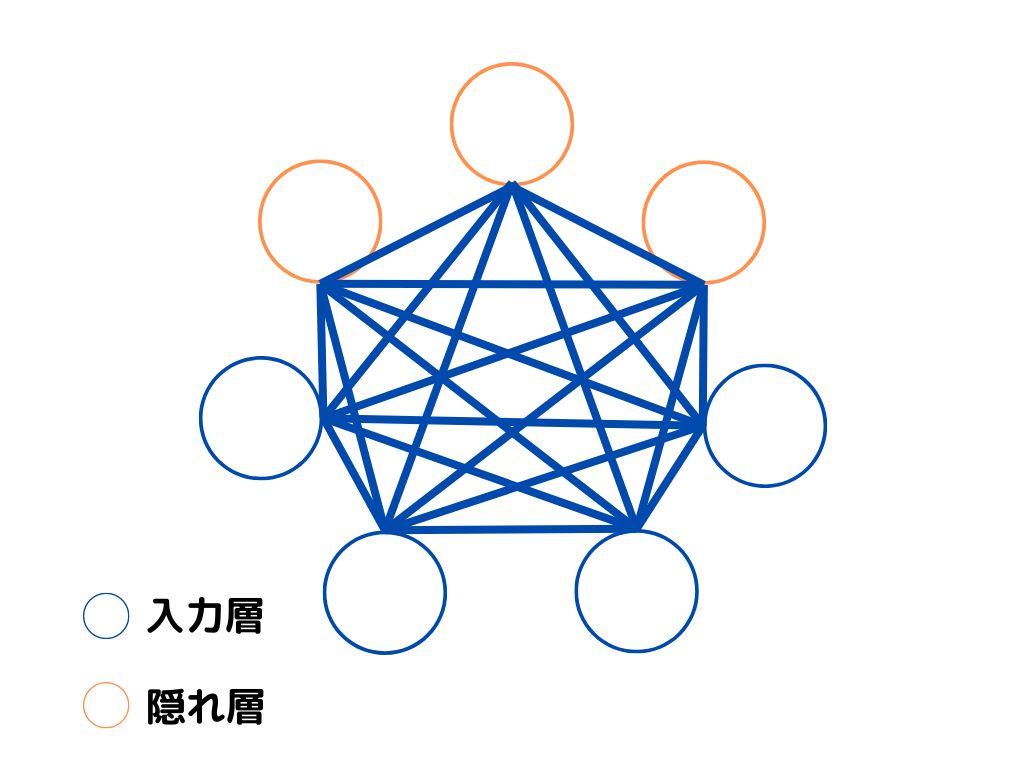
隠れ層に、入力層の特徴が抽出されます。ただ、すべてのノードがつながっているため、計算がとても重いのが弱点でした。
制限付きボルツマンマシンとは
制限付きボルツマンマシンとは、同じ層の中のノード同士のつながりをなくしたボルツマンマシンのことです。イメージは次のような感じです。
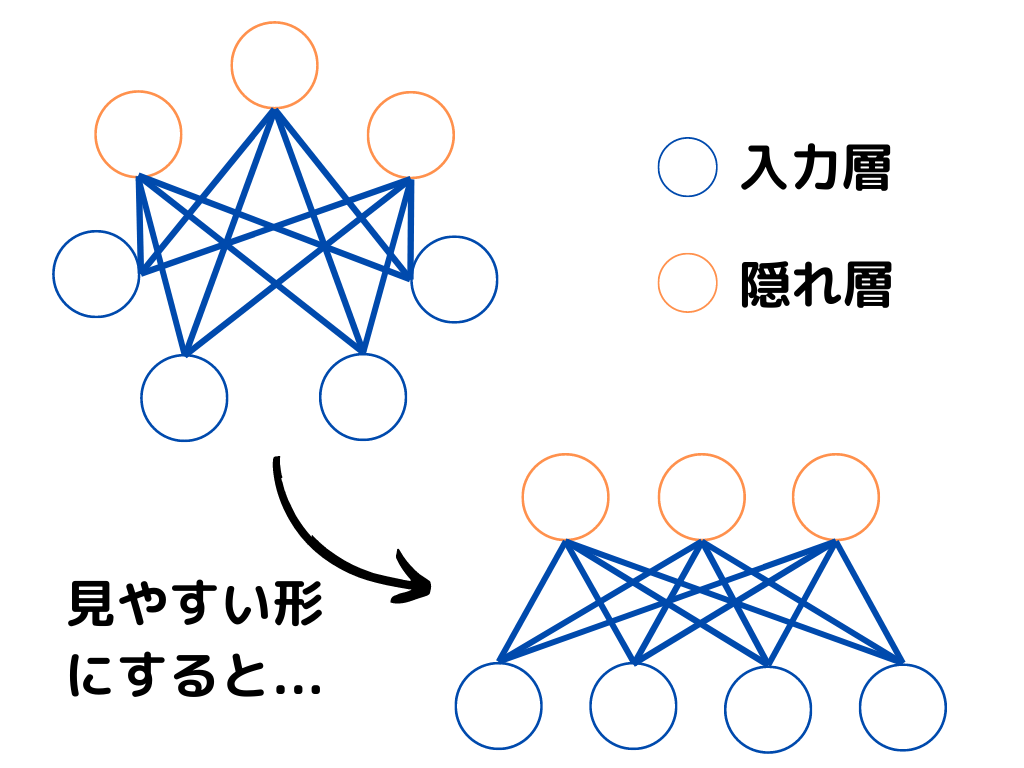
層と層の間で双方向に情報をやり取りできるのは変わりませんが、同じ層同士の結合がなくなりました。
これによって計算がぐっと軽くなり、実際に学習させやすくなったんですね。
制限付きボルツマンマシンを何層にも重ね合わせたものは、深層ボルツマンマシンと呼ばれます。
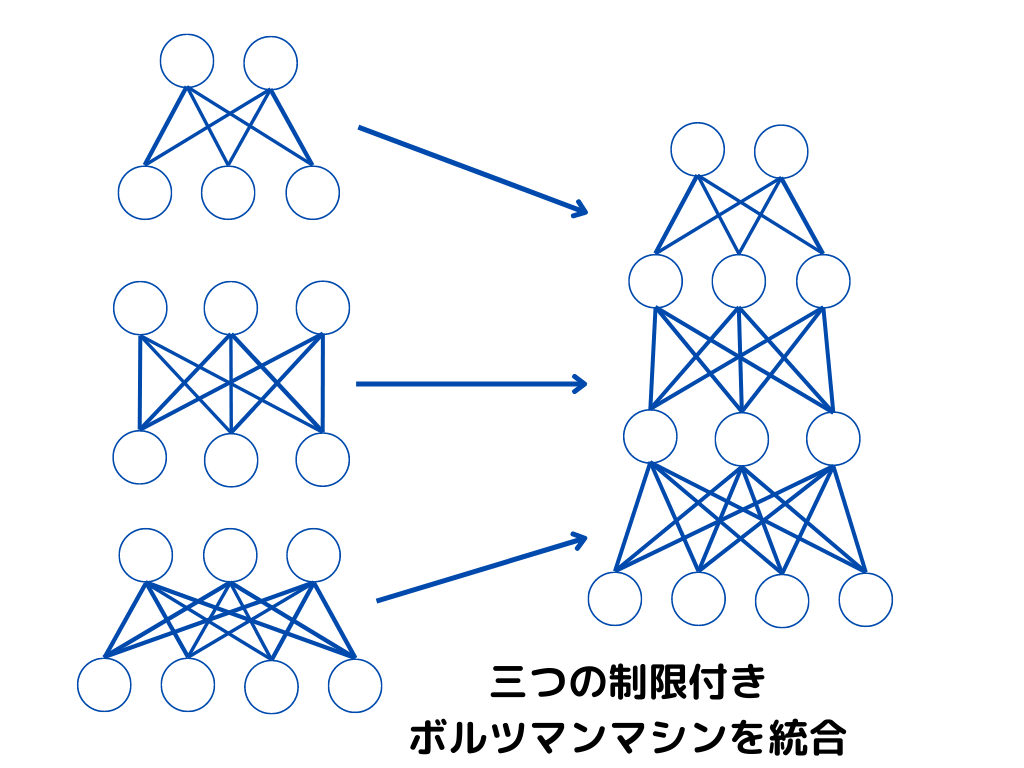
深層信念ネットワークとは
深層信念ネットワークとは、制限付きボルツマンマシンを積み重ねて作った、隠れ層のノードが0か1の値を取るニューラルネットワークの一種です。
2006年にジェフリー・ヒントンが提案しました。
イメージ的には次の図のような感じです。
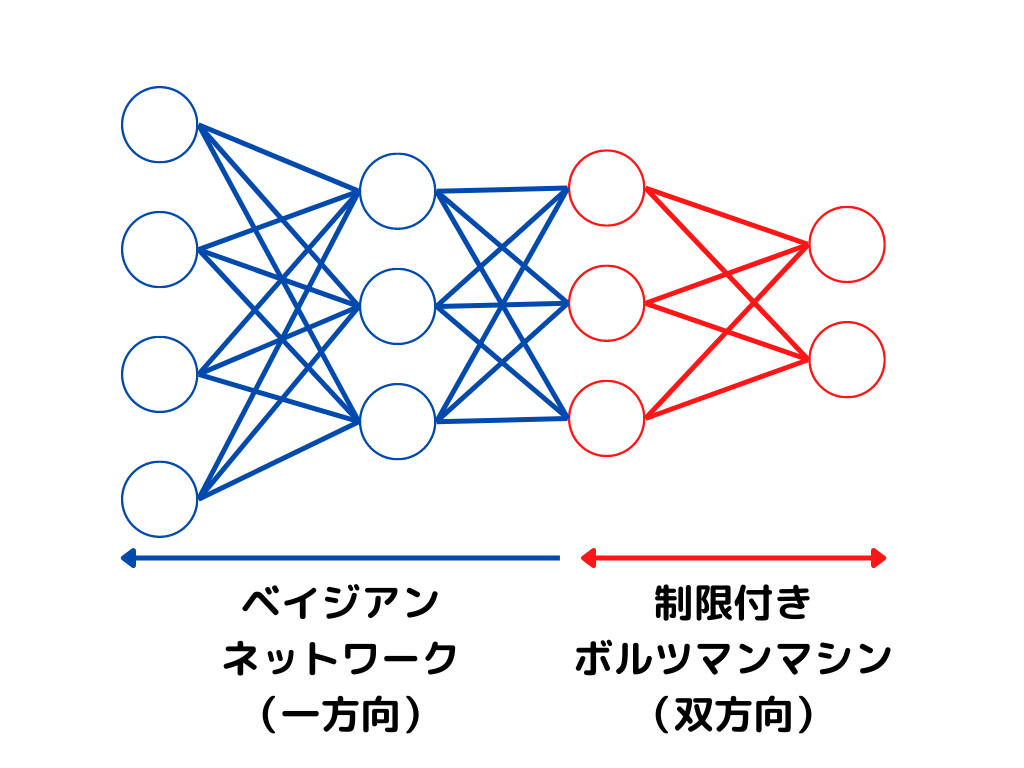
一番上の2層だけが制限付きボルツマンマシン(双方向のつながり)で、それより下の層は上から下への一方向のつながり(ベイジアンネットワーク)になっています。
ベイジアンネットワークとは、「原因」と「結果」の関係をネットワーク図と確率で表したものです。
深層ボルツマンマシンの最上部以外をベイジアンネットワークにすると、深層信念ネットワークの構造になる、ということですね。
深層信念ネットワークは、制限付きボルツマンマシンを1層ずつ事前学習させることで、深いネットワークを学習できることを示しました。
これがディープラーニングが再び注目されるきっかけの1つになっています。
| モデル | つながり方 | ポイント |
|---|---|---|
| ボルツマンマシン | 同じ層の中も含めて、すべて双方向 | 1985年・ヒントンら。計算が重い |
| 制限付きボルツマンマシン | 層の間だけ双方向(同じ層の中はつながらない) | 計算が軽く、学習しやすい |
| 深層ボルツマンマシン | 制限付きボルツマンマシンを重ねたもの | すべて双方向 |
| 深層信念ネットワーク | 最上部は双方向、下の層は一方向 | 2006年・ヒントン。事前学習の先駆け |
G検定での問われ方|オートエンコーダの早見表
現行シラバスの「オートエンコーダ」のキーワードを一言でまとめておきます。
| 用語 | 一言でいうと | 詳しい解説 |
|---|---|---|
| VQ-VAE・info VAE・β-VAE | VAEの発展形。VQ-VAEは潜在変数を離散化、β-VAEは要素を分けて学ぶよう調整、info VAEは潜在変数の情報を保つよう改良 | この記事 |
| 次元削減 | オートエンコーダの中間層で、入力を少ない次元に圧縮すること | 解説記事 |
| 事前学習 | 本番の学習の前に、大量のデータで一般的な特徴を学習しておくこと | この記事 |
| 積層オートエンコーダ | オートエンコーダを積み重ね、層ごとに事前学習する方法 | この記事 |
| 変分オートエンコーダ(VAE) | 潜在変数を確率分布として学習し、そこから新しいデータを生成するオートエンコーダ | この記事 |
よくある質問
Q. オートエンコーダは何に使いますか?
主に次元削減と異常検知に使います。
入力の特徴を少ない次元にまとめられるので計算量を減らせるほか、正常なデータだけで学習させると異常なデータをうまく復元できないことを利用して、異常を見つけられます。
Q. 事前学習は今も使われていますか?
積層オートエンコーダのように1層ずつ学習させる方法は、ReLU関数などの登場であまり使われなくなりました。
一方で、大量のデータで先に学習させたモデルを目的に合わせて調整する「事前学習済みモデル」の使い方は、BERTやGPTなどで主流になっています。
Q. VAEとオートエンコーダの違いは?
オートエンコーダは隠れ層を1つの値として学習し、入力を圧縮して元に戻すことが目的です。
VAEは隠れ層を確率分布として学習するので、その分布から値を取り出して新しいデータを生成できます。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- オートエンコーダ:入力と同じものを出力するように学習し、隠れ層に特徴を圧縮する。次元削減と異常検知に使う
- 積層オートエンコーダ:オートエンコーダを重ね、入力層に近い層から順に学習する事前学習の方法
- 変分オートエンコーダ(VAE):隠れ層を確率分布として学び、新しいデータを生成できる。β-VAE・info VAE・VQ-VAEは発展形
- 制限付きボルツマンマシンは同じ層の中のつながりをなくしたボルツマンマシン
- 深層信念ネットワーク:制限付きボルツマンマシンを積み重ねたモデル(2006年、ヒントン)
次回は、ディープラーニングを動かすためのハードウェア(GPU・TPU)と、ニューラルネットワークの各ノードで使われる活性化関数を活性化関数とGPU・TPUの記事で解説していきます。覚える内容が多いですが、りけーこっとんも頑張ります!
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。