尺度水準とは?名義・順序・間隔・比例尺度の違いとベイズの定理
どーも、りけーこっとんです。
「間隔尺度と比例尺度の違いがイマイチ分からない」「ベイズの定理の計算問題が苦手…」
このような、G検定の数理・統計の範囲で迷っている方はいないでしょうか?
数理・統計は、確率と統計の基本が出題されます。
やったことがない、覚えていないという人でも大丈夫!
基本的な用語は暗記、計算問題は基本を押さえれば解けます。
この記事では、データの種類(尺度水準)から、代表値・散らばり・相関、距離と類似度、確率分布、ベイズの定理、検定、相互情報量まで、G検定のシラバスのキーワードをすべて整理しました。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- 尺度水準は、名義尺度・順序尺度(質的変数)と、間隔尺度・比例尺度(量的変数)の4つ
- 間隔尺度は0が「何もない」を意味しない(摂氏温度など)、比例尺度は0が「何もない」を意味する(長さなど)
- ベイズの定理は、新しく分かった情報をもとに、確率を更新するための式
- 帰無仮説は「差がない」という否定したい仮説、対立仮説は「差がある」という示したい仮説
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第8章「AIに必要な数理・統計知識」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
尺度水準とは|名義・順序・間隔・比例尺度の違い
まずは「データの種類」から見ていきましょう。
データ(変数)の種類は、大きく2つに分かれます。
- 量的変数:数値として意味があり、足し算・引き算などの計算ができる変数(身長、体重、温度、西暦など)
- 質的変数:数字に数としての意味はなく、種類を区別するために使う変数(5段階の満足度、学校の成績、男性に0・女性に1を割り当てたものなど)
尺度水準とは、データがどのような性質を持つかによって、名義尺度・順序尺度・間隔尺度・比例尺度の4つに分けたものです。
質的変数と量的変数が、それぞれ2つずつの尺度に分かれます。
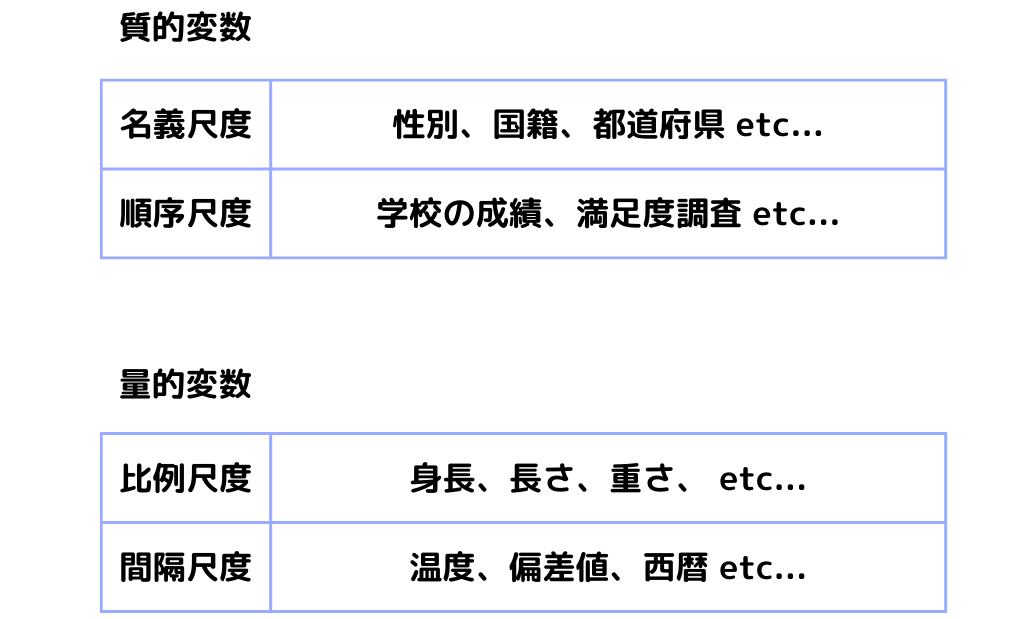
| 尺度 | 変数 | 特徴 | 例 |
|---|---|---|---|
| 名義尺度 | 質的 | 区別するためだけの数字 | 性別(男性0・女性1)、血液型、電話番号 |
| 順序尺度 | 質的 | 大小関係(順番)だけに意味がある | 学校の成績(5段階)、満足度、順位 |
| 間隔尺度 | 量的 | 差に意味があるが、比には意味がない | 摂氏温度、西暦、偏差値 |
| 比例尺度 | 量的 | 差にも比にも意味があり、0は「何もない」 | 身長、体重、長さ、金額 |
名義尺度は、女性が男性よりも1大きいと言っても意味が分かりませんよね。
順序尺度は、成績の5は1より高いですが、5の人がみんな同じ学力かと言われればそんなことはありません。
この中では、間隔尺度が一番イメージしにくいかもしれません。
摂氏温度が10℃から20℃になれば「10℃上がった」とは言えますが、「2倍の暑さになった」とは言えませんよね。
見分けるコツは、0のときに「何もない」かを考えることです。
長さは0になれば「長さがない」ことになりますが、摂氏温度は0℃になっても「温度がない」わけではありません(絶対温度は0になると「温度がない」ので、比例尺度です)。
統計学の種類と標本調査
統計学の3つの種類
統計学には、一般的に次の3つの種類があります。
| 種類 | 内容 | 主なキーワード |
|---|---|---|
| 記述統計学 | 手元にあるデータの特徴を、代表値や散らばりで表す | 平均、最頻値、標準偏差、散布図、箱ひげ図、相関係数 |
| 推測統計学 | 手元のデータ(標本)から、全体(母集団)の性質を推測する | 確率、確率分布、推定、検定、正規分布、二項分布 |
| ベイズ統計学 | ベイズの定理を使い、新しく得たデータで確率を更新しながら予測する | ベイズの定理、ベイズ推定 |
それぞれを目的に応じて使い分けることが大切です。
母集団と標本
データ分析をするには、まずデータを集めなければいけませんね。
母集団とは、データ分析をしたい対象全体のことです。
例えば「A高校の平均身長を知りたい」なら、A高校に通う高校生全員が母集団です。母集団のすべてのデータを調べることを全数調査と言い、国勢調査が代表例です。
でも、母集団のすべてを調べるのは、時間的にもお金の面でも現実的ではないことが多いですよね。
そこで、母集団から一部を取り出して調べます。この取り出したデータを標本と言います(例:全クラスから5人ずつ調べる)。
標本の抽出方法(層別抽出法・多段抽出法など)
標本の取り出し方には、次のようなものがあります。
| 抽出方法 | やり方 |
|---|---|
| 単純無作為抽出法 | くじ引きのように、完全にランダムに標本を取り出す |
| 層別抽出法 | 性別や年代など条件の似たグループ(層)に分け、それぞれのグループから標本を取り出す |
| 集落抽出法 | 母集団をいくつかのグループに分け、ランダムに選んだグループを全数調査する |
| 多段抽出法 | グループをランダムに選び、選んだグループの中から、さらにランダムに標本を取り出す |
集落抽出法と多段抽出法は似ていますが、選んだグループを全部調べるのが集落抽出法、さらにランダムに選ぶのが多段抽出法です。
統計グラフと表|度数分布表とヒストグラム
集めたデータは、グラフや表にすると見やすくなります。
G検定で大切なのは、次のグラフと表です。
| グラフ・表 | 内容 |
|---|---|
| 度数分布表 | データを一定の範囲に区切って、その範囲にあるデータの数を数えた表 |
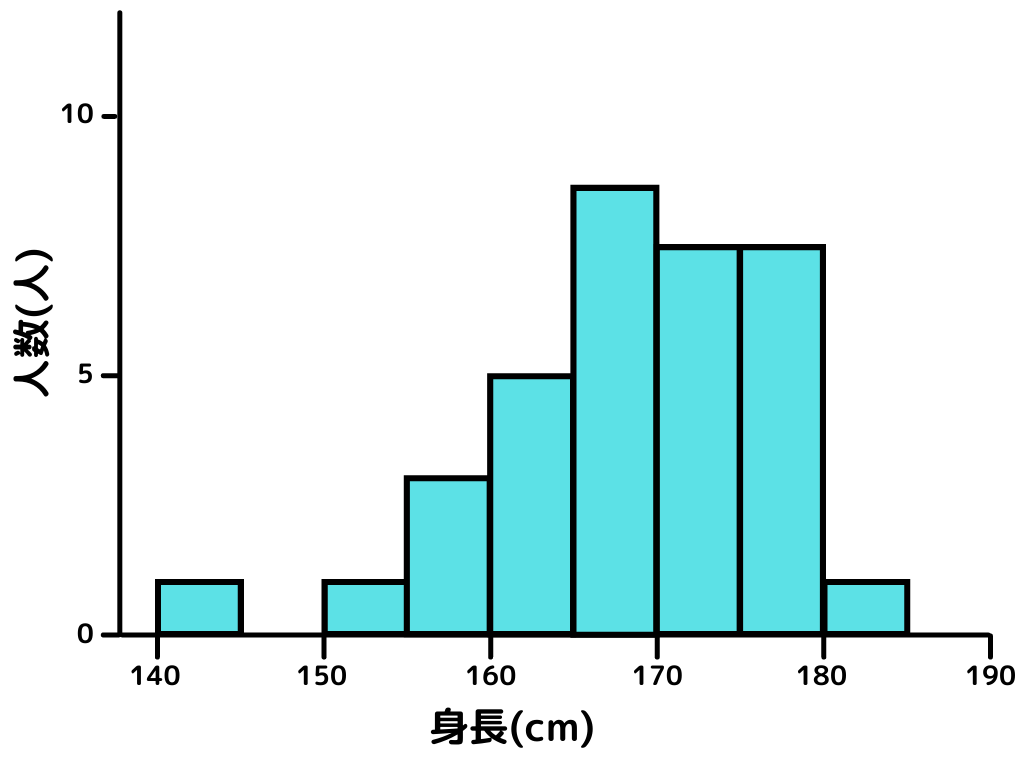
| ヒストグラム | 度数分布表をグラフにしたもの |
| 散布図 | 2つの変数のデータを点で打っていったグラフ(後述) |
| 箱ひげ図 | 箱とひげで、データ全体の散らばりを表すグラフ(後述) |
| クロス集計表 | 縦と横に質的変数を入れて、それぞれが交わるところに値を書いた表(以下の図) |
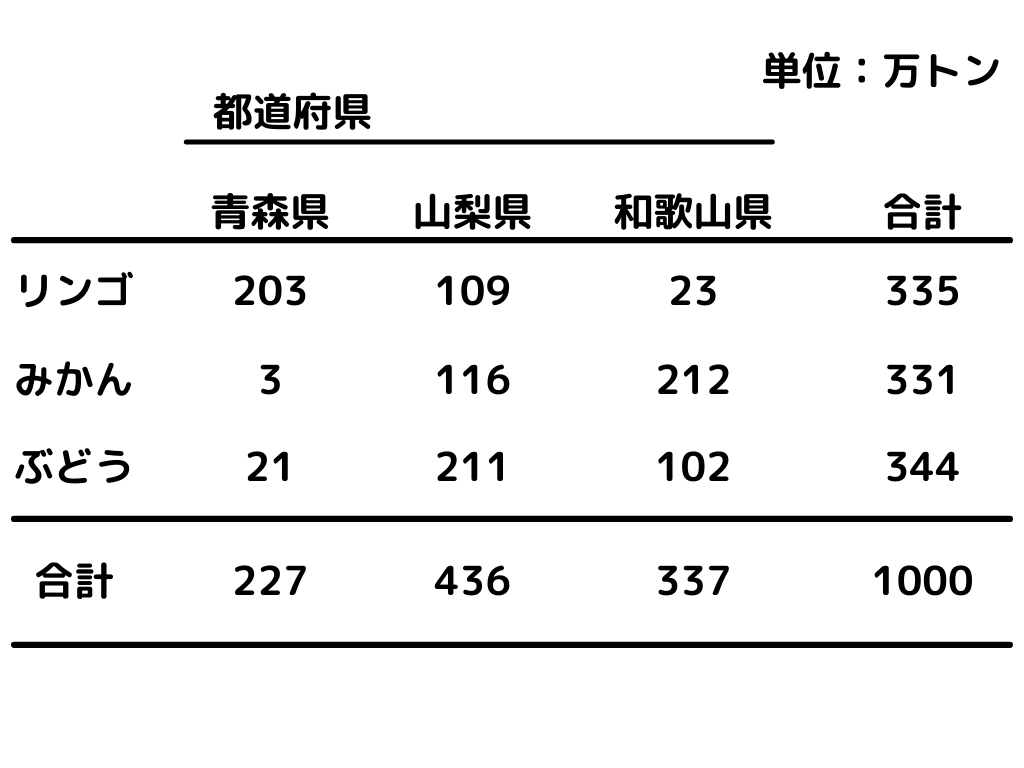
度数分布の表を作ると、「165〜170cmの人が一番多いんだな」ということが分かりますね。
度数分布表の用語を整理しておきましょう。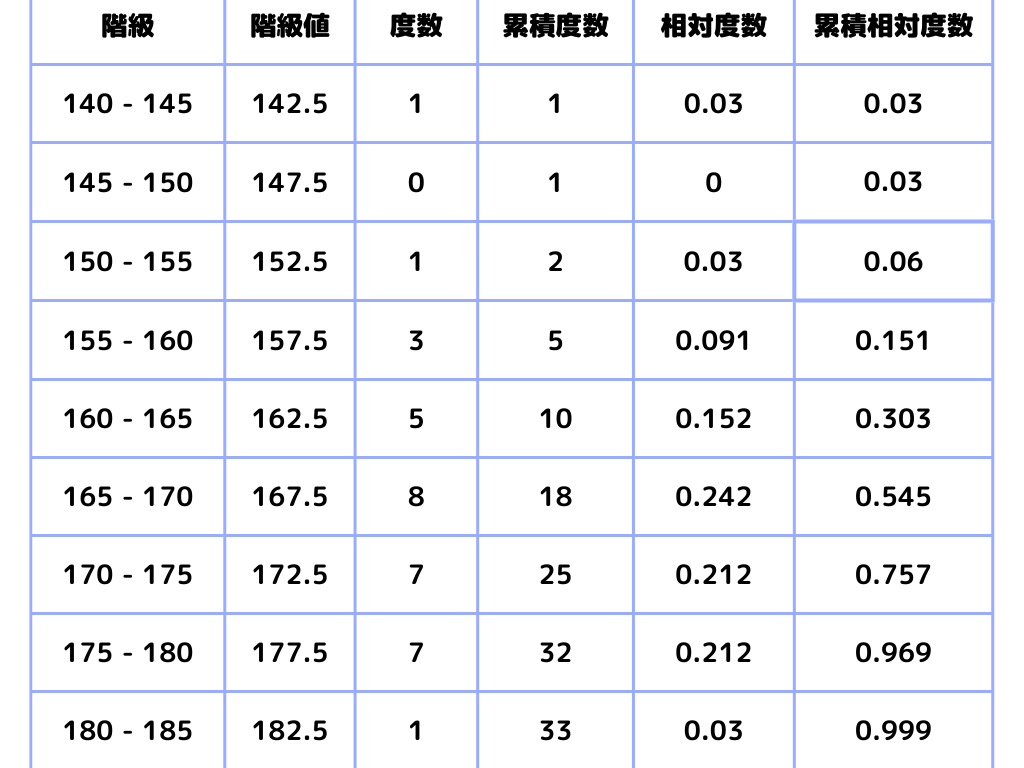
- 階級:データを一定の間隔で区切ったときの、それぞれの区間
- 階級値:階級を代表する値。階級の真ん中の値
- 度数:それぞれの階級に入るデータの個数(今回は人数)
- 累積度数:その階級までの度数を足したもの
- 相対度数:それぞれの階級の度数が、全体に占める割合(各階級の度数 ÷ 全度数)
- 累積相対度数:その階級までの相対度数を足したもの(最後は1になる)
度数分布表から作ったグラフがヒストグラムです。横軸に身長などの変数、縦軸に度数をとります。
代表値|平均・中央値・最頻値と外れ値
データの特徴を1つの値で表したものを代表値と言います。
| 代表値 | 意味 |
|---|---|
| 平均 | すべてのデータを足して、データの数で割った値 |
| 中央値 | データを小さい順に並べたときに、ちょうど真ん中にある値 |
| 最頻値 | データの中で、最も多く出てくる値 |
外れ値とは、ほかのデータから大きく離れた値のことです。測定のミスや、とても珍しいデータなどが原因で生まれます。
例えば、年収のデータに1人だけ10億円の人がいると、平均は大きく引き上げられてしまいますよね。一方、中央値は真ん中の値なので、ほとんど影響を受けません。平均は外れ値の影響を受けやすく、中央値は受けにくいと覚えておきましょう。
散らばり|分散・標準偏差・箱ひげ図
範囲と四分位数(箱ひげ図)
箱ひげ図を使うと、データの散らばり具合がひと目で分かります。
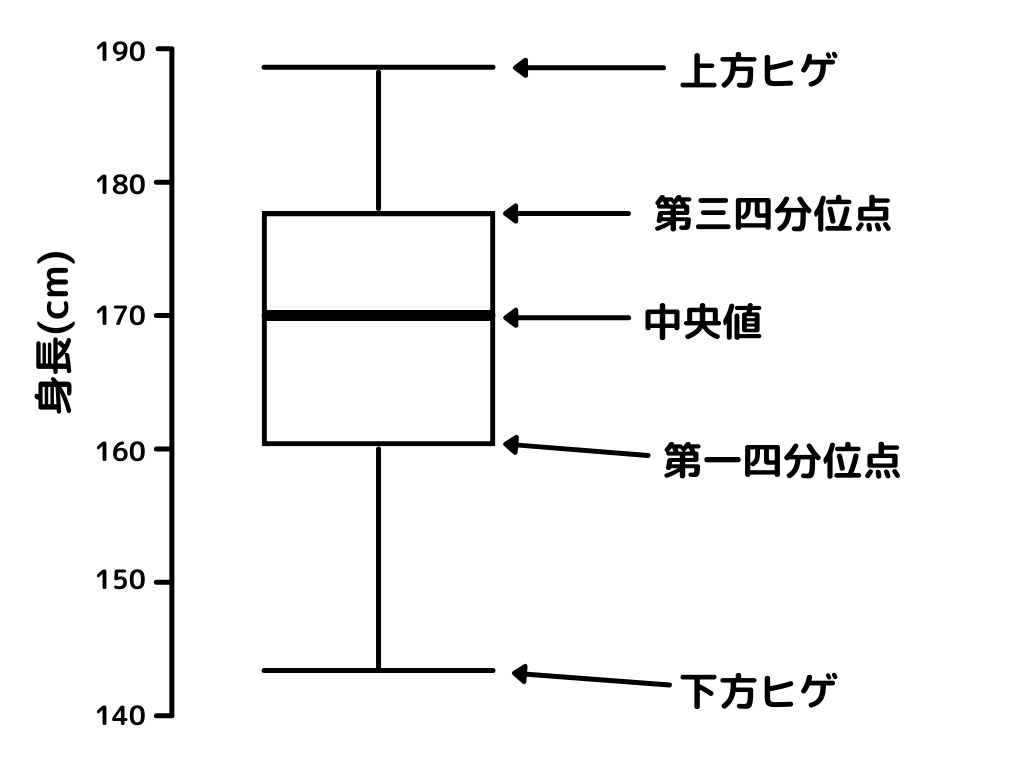
- 最小値・最大値:データの一番小さい値と大きい値。下のひげと上のひげの端にあたる
- 範囲:最大値 − 最小値
- 四分位数:データを小さい順に並べて4等分したときの区切りの値。例えば1, 2, 4, 7, 9, 19, 30なら、第1四分位数が2、第2四分位数(中央値)が7、第3四分位数が19
- 四分位範囲:第3四分位数 − 第1四分位数
なお、外れ値がある場合は、ひげの外に点で別に描くこともあります。
分散と標準偏差
分散とは、それぞれのデータが平均からどれくらい離れているかを表す値で、平均との差を2乗して、すべて足し、データの数で割って求めます。
分散 = {(各データ − 平均)² の合計}÷ データの数
2乗するのは、平均より大きいデータ(+)と小さいデータ(−)が打ち消し合わないようにするためです。
標準偏差とは、分散の平方根(ルート)をとった値です。分散は2乗しているので単位も2乗になります(cmならcm²)。平方根をとることで、元のデータと同じ単位になるので扱いやすいんですね。
学力の試験でよく使う偏差値も、標準偏差を使って計算します。
偏差値 =(自分の点数 − 平均点)÷ 標準偏差 × 10 + 50
2つの変数の関係
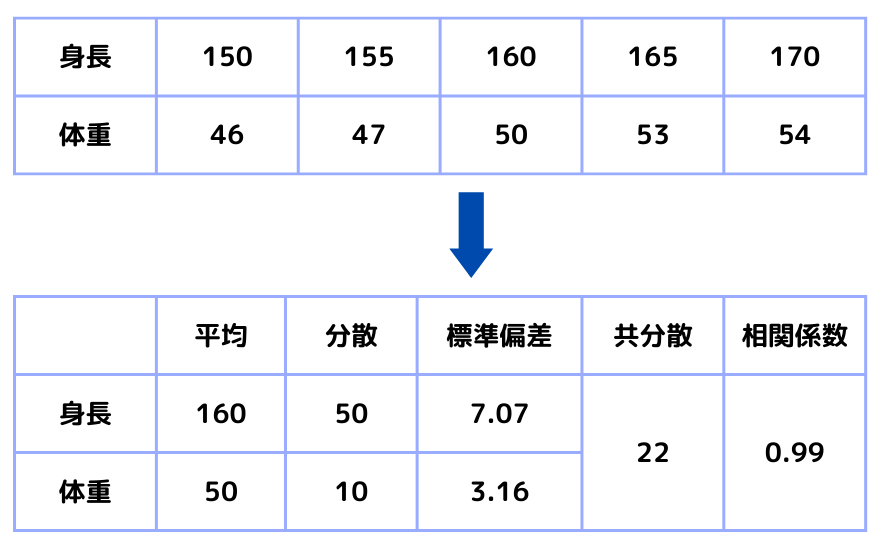
「身長」に加えて「体重」も測ったとしましょう。2つの変数の関係は、次の値で調べられます。
共分散と相関係数
共分散とは、2つの変数が一緒にどう変わるかを表す値で、それぞれの平均からの差どうしを掛けて、すべて足し、データの数で割って求めます。
共分散 = {(xの各データ − xの平均)×(yの各データ − yの平均)の合計}÷ データの数
共分散は、単位やデータの大きさで値が変わってしまうので、比べにくいという弱点があります。そこで使うのが相関係数です。
相関係数とは、2つの変数にどれくらい直線の関係(相関)があるかを、−1から1の範囲で表した値です。
相関係数 = 共分散 ÷(xの標準偏差 × yの標準偏差)
| 相関係数 | 意味 |
|---|---|
| 1に近い | 強い正の相関(一方が増えると、もう一方も増える) |
| 0に近い | 直線の関係がほとんどない |
| −1に近い | 強い負の相関(一方が増えると、もう一方は減る) |
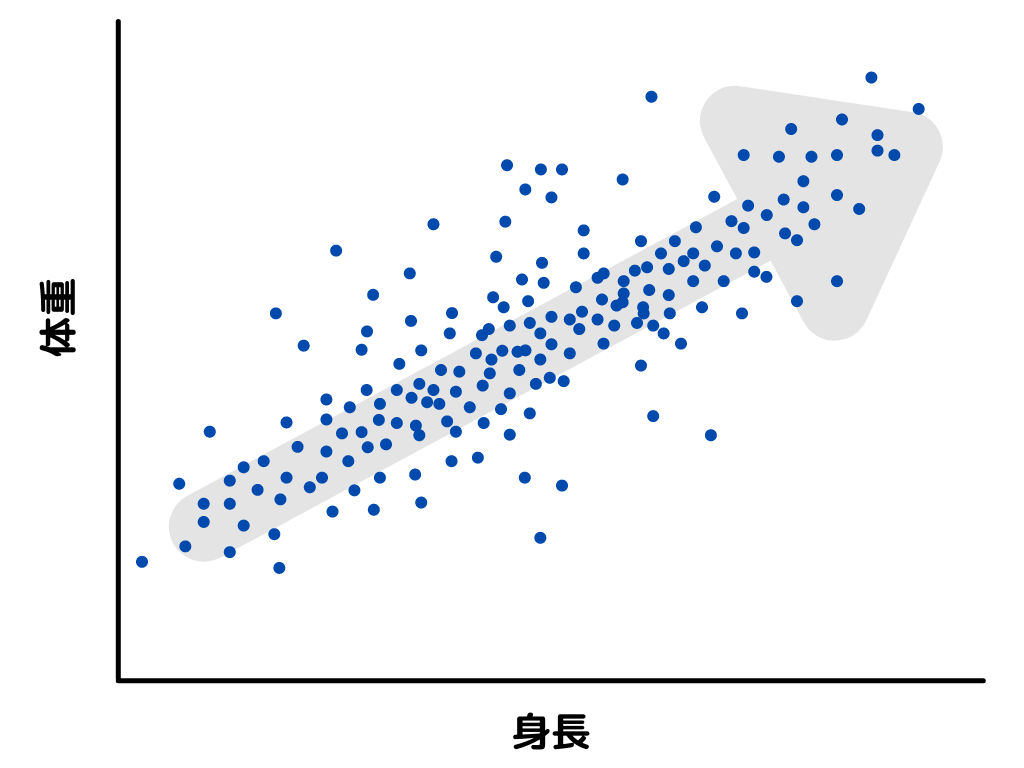
この散布図のように、右上に伸びる直線のまわりにデータが分布していると「正の相関がある」と言います。
偏相関係数
偏相関係数とは、2つの変数の相関から、ほかの変数の影響を取り除いた相関係数のことです。
例えば、アイスクリームの売上と水難事故の件数には、正の相関があります。
でも、アイスが売れるから水難事故が増えるわけではありませんよね。
どちらも「気温が高い」ことが原因です。このように、ほかの変数のせいで生まれる見かけの相関を擬似相関と言います。
偏相関係数を使って気温の影響を取り除くと、本当の関係が見えてきます。
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

ユークリッド距離・マハラノビス距離・コサイン類似度
データどうしがどれくらい似ているかを測る方法も、機械学習ではよく使います(k近傍法やk-means法などで使われます)。
ユークリッド距離とは、2つの点を結ぶ直線の長さのことで、私たちが普段使っている「距離」と同じものです。三平方の定理で求められます。
マハラノビス距離とは、データの散らばり具合(分散)や変数どうしの相関を考えに入れて測る距離のことです。
データが大きく散らばっている方向の1cmと、あまり散らばっていない方向の1cmでは、重みが違うと考えます。
データの分布を考えた距離なので、ほかのデータからどれくらい外れているかを調べる異常検知などで使われます。
コサイン類似度とは、2つのベクトルの向きがどれくらい似ているかを、ベクトルどうしの角度のコサインで表した値です。
−1から1の値をとり、1に近いほど向きが似ています。ベクトルの長さではなく向きを比べるので、文章や単語の似ている度合いを測るのによく使われます(word2vecの記事もどうぞ)。
| 比べるところ | ユークリッド距離 | マハラノビス距離 | コサイン類似度 |
|---|---|---|---|
| 何を測るか | 直線の距離 | 分布を考えた距離 | 向きの近さ |
| 似ているほど | 小さい | 小さい | 1に近い |
| 主な使い道 | k近傍法、k-means法 | 異常検知 | 文章・単語の類似度 |
確率の基礎
確率変数と確率分布・確率密度
確率変数とは、確率によって、とる値が変わる変数のことです。例えば、サイコロの出る目は1〜6のどれかで、それぞれ6分の1の確率で出ますよね。
確率分布とは、確率変数がそれぞれの値をとる確率が、どのように分布しているかを表したものです。横軸に確率変数の値、縦軸に確率をとります。
サイコロの目のように、とびとびの値をとる場合は、それぞれの値に確率が決まります。
一方、身長のように連続した値をとる場合は、「ちょうど170.000…cm」になる確率は0になってしまいます。
そこで、確率の「濃さ」を表す確率密度を使います。確率密度のグラフの面積が確率を表すんですね。
期待値
期待値とは、確率変数がとる値と、その確率を掛けて、すべて足したもので、平均的にどれくらいの値になるかを表します。
サイコロの目の期待値は、1×1/6 + 2×1/6 + … + 6×1/6 = 3.5 です。サイコロを何回も振ると、出た目の平均は3.5に近づいていきます。
条件付き確率とベイズの定理
条件付き確率とは、ある出来事Bが起こったと分かっているときに、別の出来事Aが起こる確率のことです。
P(A|B)と書き、「Bのもとで、Aが起こる確率」と読みます。
ベイズの定理とは、条件付き確率の関係を使って、新しく分かった情報をもとに、ある出来事の確率を計算し直すための式です。
ベイズ統計学の最も基本となる式です。
P(A|B) = P(B|A) × P(A) ÷ P(B)
| 記号 | 名前 | 意味 |
|---|---|---|
| P(A) | 事前確率 | Bが分かる前の、Aが起こる確率 |
| P(B|A) | 尤度 | Aのときに、Bが起こる確率 |
| P(B) | 周辺尤度(正規化定数) | 全体でBが起こる確率 |
| P(A|B) | 事後確率 | Bが分かったあとの、Aが起こる確率 |
ベイズ推定は、ベイズの定理を使って、新しい情報が得られるたびに推定を更新していく方法です。
式だけでは分からないと思うので、例題を1つ解いてみましょう。
あなたはお菓子をX社・Y社・Z社から仕入れて販売しています。
仕入れの割合はそれぞれ20%・30%・50%で、不良品が出る確率はそれぞれ6%・5%・4%です。
ある日、不良品を見つけました。この不良品がY社のものである確率は何%でしょうか。
求めたいのは「不良品だと分かった(B)ときに、Y社のお菓子である(A)確率」なので、P(A|B)です。
- P(A):Y社のお菓子である確率 = 0.3
- P(B|A):Y社のお菓子が不良品になる確率 = 0.05
- P(B):全体で不良品が出る確率 = 0.2×0.06 + 0.3×0.05 + 0.5×0.04 = 0.012 + 0.015 + 0.020 = 0.047
これをベイズの定理に入れると、P(A|B) = 0.05 × 0.3 ÷ 0.047 = 0.015 ÷ 0.047 ≒ 0.319 となり、答えは約31.9%です。
仕入れの割合は30%でしたが、「不良品だった」という情報で確率が更新されたんですね。
正規分布・二項分布・ベルヌーイ分布・ポアソン分布
正規分布とは、平均を中心に左右対称の山の形をした、最も代表的な確率分布です。
平均で山の中心の位置が、分散(標準偏差)で山の横の広がりが決まります。
身長や試験の点数など、自然や社会の多くのデータが正規分布に近い形になります。
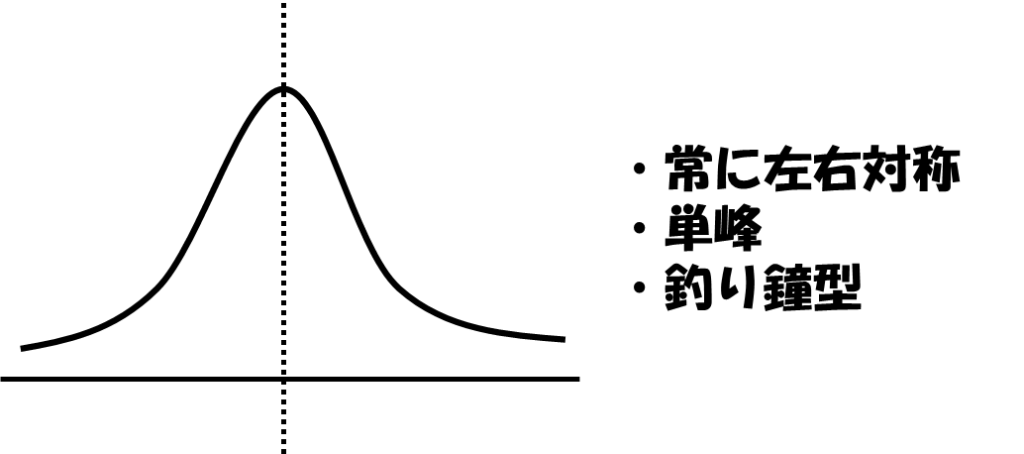
平均から±1標準偏差の範囲に約68%、±2標準偏差に約95%のデータが入ることも覚えておきましょう。
ベルヌーイ分布とは、「成功か失敗か」のように結果が2つしかない試行を1回行ったときの確率分布です。コインを1回投げて、表が出るか裏が出るか、などですね。
二項分布とは、ベルヌーイ分布の試行を何回も繰り返したときに、成功する回数の確率分布です。
コインを10回投げたときに表が出る回数、などです。試行の回数を増やしていくと、正規分布に近づいていきます。
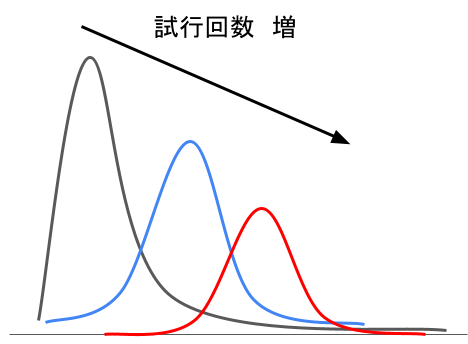
ポアソン分布とは、一定の時間や範囲の中で、まれに起こる出来事が何回起こるかを表す確率分布です。
1時間にお店に来るお客さんの数や、1日に起こる交通事故の件数などがポアソン分布に従うとされます。
推定と検定
最尤法とは
最尤法(さいゆうほう)とは、手元のデータが得られる確率(尤度)が最も高くなるように、確率分布のパラメータを決める方法です。最尤推定とも言います。
例えば、コインを10回投げて7回表が出たとします。表が出る確率を0.5と考えるより、0.7と考えた方が「10回中7回表」というデータが一番起こりやすくなりますよね。
このとき、表が出る確率は0.7と推定します。機械学習のモデルの学習も、最尤法の考え方に基づいているものが多いんです。
帰無仮説と対立仮説
データから「本当に差があるのか」を確かめる方法を仮説検定と言います。
帰無仮説とは、「差がない」「効果がない」のように、本当は否定したい仮説のことです。
対立仮説とは、「差がある」「効果がある」のように、帰無仮説が否定されたときに受け入れる、本当に示したい仮説のことです。
例えば、新しい薬の効果を調べるなら、帰無仮説は「薬に効果はない」、対立仮説は「薬に効果がある」です。
帰無仮説が正しいとしたときに、手元のデータが起こる確率(p値)を計算し、それが決めた基準(有意水準、よく5%を使う)より小さければ、帰無仮説を棄却して、対立仮説を受け入れます。
時系列と情報量|移動平均・相互情報量
移動平均とは、時系列のデータで、ある時点の前後や直近の一定期間のデータの平均を、期間をずらしながら計算していく方法です。
例えば株価の「25日移動平均」は、直近25日間の株価の平均を毎日計算したものです。日々の細かい上がり下がりをならして、全体の傾向をつかみやすくできます。
相互情報量とは、一方の変数の値を知ることで、もう一方の変数についての不確かさがどれだけ減るかを表す値です。
2つの変数が関係なければ(独立なら)、相互情報量は0になります。
相関係数が直線の関係しか測れないのに対して、相互情報量は直線ではない関係も測れるのが特徴です。
機械学習では、予測に役立つ特徴量を選ぶときなどに使われます。
G検定での問われ方|数理・統計の早見表
現行シラバスの「AIに必要な数理・統計知識」のキーワードは、次の表ですべて確認できます。
| 用語 | 一言でいうと | 詳しい解説 |
|---|---|---|
| 移動平均 | 時系列データで、一定期間の平均を少しずつずらしながら取り、変動をならす方法 | この記事 |
| 確率分布 | 確率変数がそれぞれの値をとる確率の分布 | この記事 |
| 確率変数 | サイコロの目のように、とる値が確率的に決まる変数 | この記事 |
| 確率密度 | 連続した値をとる確率変数で、その値の付近の起こりやすさを表すもの。範囲で積分すると確率になる | この記事 |
| 疑似相関 | 因果関係がないのに、第3の要因のせいで相関があるように見えること | 解説記事 |
| 期待値 | 確率で重み付けした平均値 | この記事 |
| 帰無仮説 | 仮説検定で「差がない(効果がない)」とおく仮説。これを棄却できるかを調べる | この記事 |
| 共分散 | 2つの変数が一緒にどう動くかを表す値。単位に左右されるので大きさの比較には向かない | この記事 |
| コサイン類似度 | 2つのベクトルの向きの近さ(なす角のコサイン)。1に近いほど似ている | この記事 |
| 最小二乗法 | 予測と正解の差の2乗の合計が最小になるようにパラメータを決める方法 | 解説記事 |
| 最頻値 | データの中で最も多く現れる値 | この記事 |
| 最尤法 | 手元のデータが得られる確率(尤度)が最大になるようにパラメータを決める方法(最尤推定) | この記事 |
| 条件付き確率 | ある事象Bが起きたという条件のもとで、事象Aが起きる確率 | この記事 |
| 正規分布 | 平均を中心とした左右対称の釣鐘型の分布。平均±1σに約68%、±2σに約95%が入る | この記事 |
| 相関係数 | 2つの変数の直線的な関係の強さ(−1〜1)。相関があっても因果関係があるとは限らない | この記事 |
| 相互情報量 | 一方の変数を知ることで、もう一方の不確かさがどれだけ減るかを表す量 | この記事 |
| 対立仮説 | 仮説検定で帰無仮説と反対の「差がある(効果がある)」とする仮説 | この記事 |
| 中央値 | データを大きさの順に並べたときの真ん中の値。外れ値の影響を受けにくい | この記事 |
| 度数分布 | データを階級に区切り、それぞれに入る個数(度数)をまとめたもの | この記事 |
| 二項分布 | 成功確率pの試行をn回行ったときの成功回数の分布 | この記事 |
| 外れ値 | ほかのデータから大きく離れた値。平均などを大きくゆがめることがある | この記事 |
| 標準偏差 | 分散の平方根。データのばらつきを元の単位で表す | この記事 |
| 平均 | データの合計をデータの個数で割った値。外れ値に引っ張られやすい | この記事 |
| 分散 | 各データと平均との差の2乗の平均。データのばらつきの大きさ | この記事 |
| 偏相関係数 | 第3の変数の影響を取り除いたうえでの、2つの変数の相関 | この記事 |
| ベルヌーイ分布 | 1回の試行で成功(1)か失敗(0)かの分布 | この記事 |
| ポアソン分布 | 一定時間にまれな出来事が起きる回数の分布 | この記事 |
| マハラノビス距離 | データのばらつきや変数同士の相関を考慮した距離。異常検知に使われる | この記事 |
| ユークリッド距離 | 2点間の直線距離 | この記事 |
よくある質問
Q. 間隔尺度と比例尺度の違いは?
どちらも量的変数ですが、間隔尺度は0が「何もない」ことを意味せず、比に意味がありません(摂氏温度、西暦など)。
比例尺度は0が「何もない」ことを意味し、比にも意味があります(身長、体重、長さなど)。
Q. マハラノビス距離とユークリッド距離の違いは?
ユークリッド距離は2点を結ぶ直線の長さです。
マハラノビス距離は、データの散らばり具合や変数どうしの相関を考えに入れた距離で、異常検知などに使われます。
Q. 帰無仮説と対立仮説とは?
帰無仮説は「差がない」「効果がない」のような否定したい仮説、対立仮説は「差がある」「効果がある」のような示したい仮説です。
帰無仮説が正しいとしたときにデータが起こる確率が有意水準より小さければ、帰無仮説を棄却して対立仮説を受け入れます。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- 尺度水準は名義・順序(質的変数)と間隔・比例(量的変数)の4つ。0が「何もない」なら比例尺度
- 層別抽出法は層ごとに抽出、集落抽出法は選んだグループを全数調査、多段抽出法は選んだグループからさらに抽出
- 平均は外れ値の影響を受けやすく、中央値は受けにくい。標準偏差は分散の平方根
- 相関係数は直線の関係の強さ(−1〜1)、偏相関係数はほかの変数の影響を除いた相関
- ベイズの定理で確率を更新する。帰無仮説を棄却して対立仮説を受け入れるのが仮説検定
G検定の数理・統計は以上です。全体の用語をまとめて確認したい方は、チートシートもあわせて活用してくださいね。
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。