k-means法とは?クラスタリングの手法とデンドログラムを解説
どーも、りけーこっとんです。
「k-means法のkって、誰が決めるの?」「デンドログラムって、どう読めばいいの?」このような、G検定のクラスタリングの問題で迷っている方はいないでしょうか?
この記事では、教師なし学習の代表「クラスタリング」を解説します。
非階層的クラスタリングのk-means法と、クラスタ数の決め方(エルボー法・シルエット分析)、階層的クラスタリングとデンドログラム、クラスタ間の距離の測り方(ウォード法など)まで、比較表で整理しました。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- クラスタリングとは、正解ラベルなしで、似たデータ同士をグループ(クラスタ)にまとめること
- k-means法は、最初にクラスタ数kを人が決めて、重心を動かしながらデータを分ける非階層的クラスタリング
- クラスタ数kの決め方には、エルボー法とシルエット分析がある
- 階層的クラスタリングは、近いクラスタから順にまとめていき、その過程をデンドログラム(樹形図)で表す
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第3章「機械学習の概要」の「教師なし学習」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
クラスタリング(クラスター分析)とは
クラスタリング(クラスター分析)とは、データを似たもの同士でグループに分けることです。
データ同士の距離が近かったり、似た傾向があったりするものを1つにまとめるんです。この1つにまとめた塊を「クラスタ」と言います。
注意したいのは、似たデータ同士をまとめるだけで、まとめたデータに意味を見出すのは人間ということです。
正解ラベルを使わないので「教師なし学習」と言われるわけですね。教師なし学習の全体像は教師なし学習と主成分分析の記事で解説しています。
クラスタリングのやり方はいろいろあるのですが、大きくは次の2つです。
- 非階層的クラスタリング(代表がk-means法)
- 階層的クラスタリング
まずは、非階層的クラスタリングの代表例から見ていきましょう。
k-means法とは
k-means法とは、最初に決めたk個のクラスタの中心(重心)を動かしながら、データを近い中心ごとに分けていくクラスタリングの手法です。
k-means法の手順
k-means法は次のような手順で進みます。
- k個のシードを置く(データを何個に分けるか自分で決める)
- 各データを、最も近いシードと同じクラスタに分ける
- クラスタごとに重心を求め、それを新たなシードとする
- 重心が移動しなくなるまで2と3を繰り返す
最初にk個のシード(クラスタ分けの基準となる点)を置くことで、データを何分割にするか決めます。
この「何分割するか」を決めるのは分析者自身であり、非常に重要です。
k-means法は、進める過程でクラスタの数が変わりません。
なので「非階層的クラスタリング」に分類されますね。
| メリット | デメリット |
|---|---|
| 計算が速い | 事前にkを決める必要がある |
| シンプルで実装しやすい | 最初のシードの置き方で、分類結果や計算時間が変わる |
名前が似ているk近傍法(kNN)は、教師あり学習の分類手法です。
kの意味も「クラスタの数」と「近くを見るデータの数」で違うので、k近傍法の記事で確認しておきましょう。
クラスタ数の決め方(エルボー法・シルエット分析)
「最初のkが重要なのに、その判断の仕方が分からないよ!」という方には、次の2つの便利な手法があります。
- エルボー法(Elbow Method)
- シルエット分析(シルエットプロット)
エルボー法とは
エルボー法とは、クラスタ数を変えながらクラスタ内のばらつきを計算し、グラフが「肘」のように曲がる点を最適なクラスタ数とする手法です。
具体的には次の手順で進みます。
- WCSS(Within Cluster Sum of Squares)を求める
- 横軸にk(クラスタ数)、縦軸にWCSSを取ったグラフを作る
- WCSSがあまり下がらなくなるkを選ぶ
WCSSとは、各クラスタの重心から各データまでの距離の二乗の合計のことです。線形回帰での残差二乗和みたいなものでしょうか。
この方法でグラフを作ると、次のような感じになります。
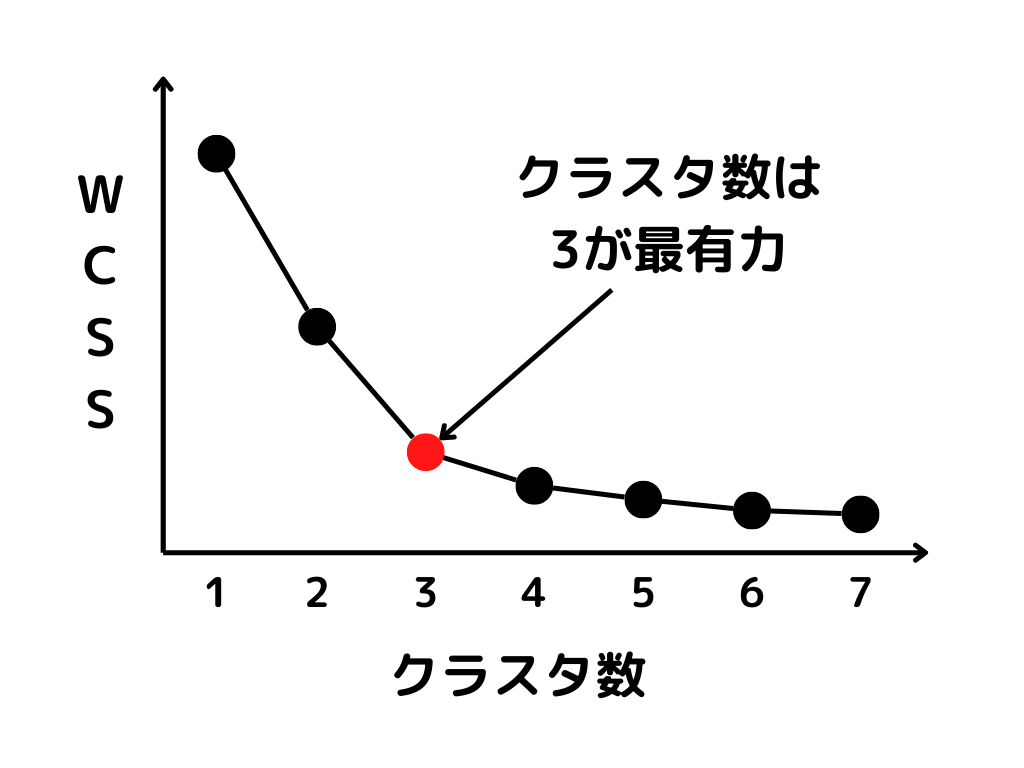
途中までは各データまでの距離が減りやすいのですが、あるクラスタ数を超えるとあまり変化しなくなっていますよね。
あまり変化しなくなったクラスタ数を取ることで、ある程度最適なクラスタ数を求めることができます。
このグラフの形が「肘(エルボー)」のように見えることから、エルボー法と言われます。
シルエット分析とは
シルエット分析とは、各データが自分のクラスタにどれだけよく当てはまっているか(シルエットスコア)をグラフにして、クラスタ数の良し悪しを判断する手法です。
具体的には次の手順で進みます。
- 次の式で、全データのシルエットスコアを求める
- 縦軸にクラスタごとのデータ、横軸にシルエットスコアを取ったグラフ(シルエットプロット)を作る
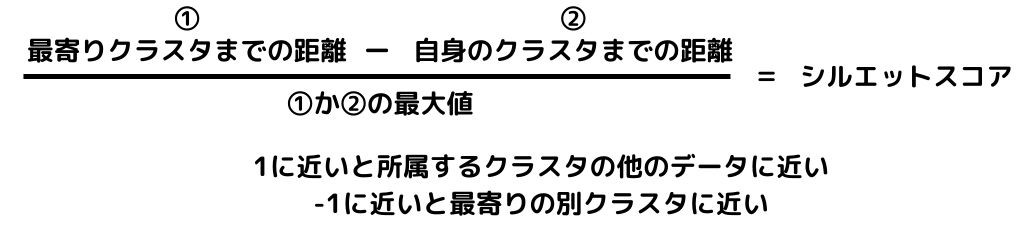
シルエットスコアは−1から1の値を取り、1に近いほど「自分のクラスタにはよく当てはまり、隣のクラスタからは離れている」ことを表します。
クラスタ数が少なすぎると、次のような形になります(左がシルエットプロット、右が元データ)。

出典:クラスター数の決め方の1つシルエット分析 – S-Analysis
赤い点線が平均のシルエットスコアです。黒いクラスタの面積が大きく、平均を超えていないデータしかないことが分かりますね。
これは、黒のクラスタが広がりすぎてしまっていることを示しています。多すぎると次のような感じです。
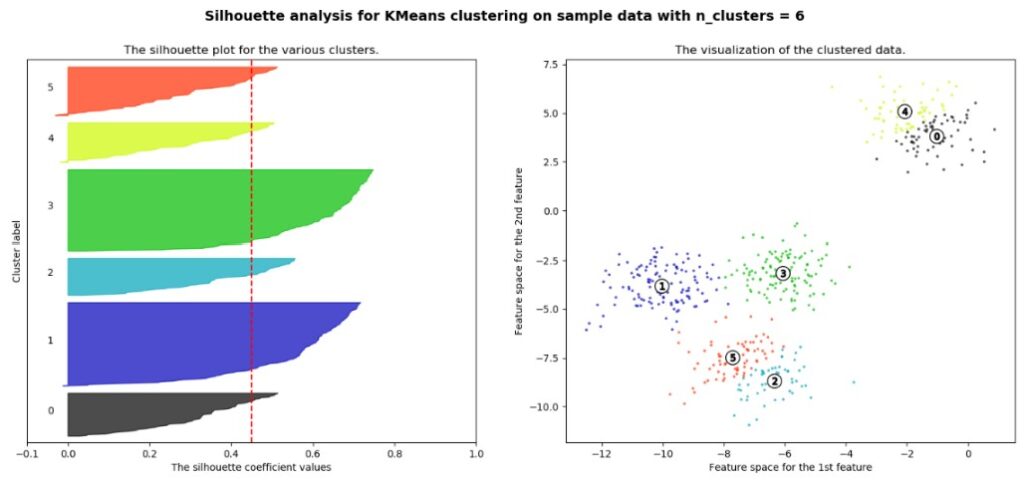
出典:クラスター数の決め方の1つシルエット分析 – S-Analysis
クラスタを分割しすぎると、三角形のグラフが目立ちますね。この形が見えてきたら、クラスタ数は多すぎるということになります。
一番最適なクラスタ数になると、次のような感じになります。
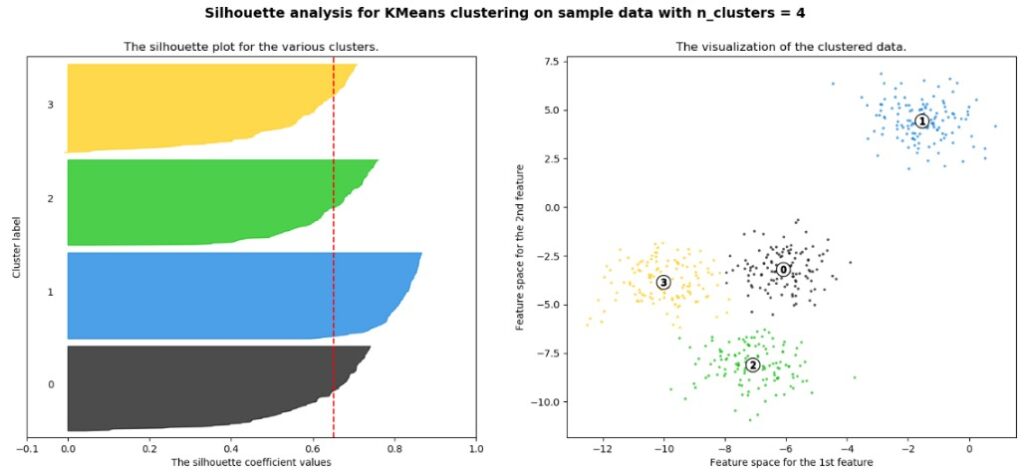
出典:クラスター数の決め方の1つシルエット分析 – S-Analysis
このようにシルエットプロットの形を見ることで、最適なクラスタ数を考える方法です。
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

階層的クラスタリングとは
階層的クラスタリングとは、似ているデータやクラスタを段階的にまとめていき、木のような階層構造を作るクラスタリングの手法です。
先ほどまでのk-means法は、最初にクラスタ数を決めてしまいましたよね。
階層的クラスタリングでは、次のように進めます。
- 最初は、1つ1つのデータをそれぞれ1つのクラスタとする
- 一番近い2つのクラスタを1つにまとめる
- 全部が1つのクラスタになるまで2を繰り返す
事前にクラスタ数を決める必要がないので、データが何グループに分かれるか分からないときなどに有効です。
デンドログラム(樹形図)とは
デンドログラム(樹形図)とは、階層的クラスタリングでクラスタがまとまっていく様子を、木の形で表した図のことです。
実際に書いてみると、次のようになります。
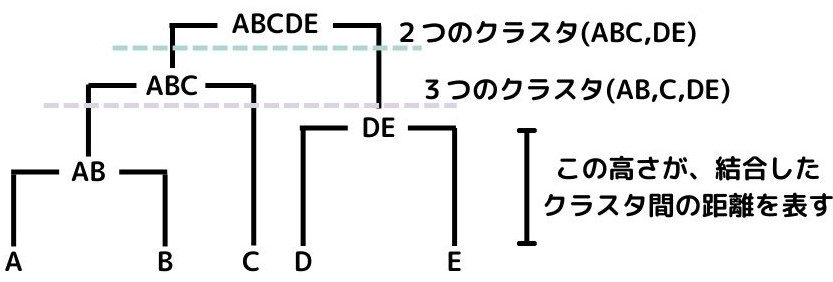
上から見ると、元データ(A〜E)がまずABCとDEの2つに分かれ、次の段階ではABCがABとCに分かれていますよね。
逆に下から見ると、近いものから順にまとまっていく様子が分かります。
さらに、つなぐ線の「高さ」がクラスタ同士の距離を示しているので、どれくらいクラスタ同士が近いのか一目で分かります。
好きな高さで横に線を引けば、その高さで切ったときのクラスタ数が分かるのも便利なところです。
| メリット | デメリット |
|---|---|
| 事前にクラスタ数を決める必要がない | 計算量が多い |
| 樹形図があるので結果を読み取りやすい | データが多すぎると樹形図が複雑で読めなくなる |
距離の測り方(最短・最長・群平均・ウォード法)
階層的クラスタリングでは、「クラスタ同士の距離」をどう測るかで結果が変わります。
代表的なのが次の4つで、いずれも階層的クラスタリングの手法です。
- 最短距離法:
2つのクラスタで最も近いデータ同士の距離を、クラスタ間の距離とする。
処理は速いが、細長く数珠つなぎのクラスタができやすく(鎖効果)、分類の感度が低い - 最長距離法:
2つのクラスタで最も遠いデータ同士の距離を、クラスタ間の距離とする。
処理が速く分類の感度も高いが、クラスタ同士が離れやすい性質(拡散現象)を持つ - 群平均法:
2つのクラスタのデータ同士、全ての組み合わせの距離の平均を、クラスタ間の距離とする。
分類の感度が高く、拡散現象も起こしにくいので、よく使われる - ウォード法:
2つのクラスタを結合する前後での分散の増加量を、クラスタ間の距離とする
ウォード法とは
ウォード法とは、2つのクラスタを結合したときに、データのばらつき(分散)がどれだけ増えるかで、クラスタ間の距離を測る手法です。
2つのクラスタを結合すると、データの量もばらつきも大きくなるので、分散が大きくなります。
結合した後に分散があまり増えなければ、その2つのクラスタは近い(似ている)ということですね。
ウォード法のメリットは、分類の感度がとても良いことです。デメリットは、距離や平均ではなく分散を求めるので、計算量が多く処理時間が長いことですね。
k-means法と階層的クラスタリングの比較
| 比べるところ | k-means法 | 階層的クラスタリング |
|---|---|---|
| 分類 | 非階層的クラスタリング | 階層的クラスタリング |
| クラスタ数 | 最初に人が決める(k) | 決めなくてよい(あとから樹形図で選ぶ) |
| 計算量 | 少ない(大量のデータ向き) | 多い(データが多いと重い) |
| 結果の見せ方 | 各データがどのクラスタか | デンドログラム(樹形図) |
| クラスタ数の決め方 | エルボー法・シルエット分析 | デンドログラムを好きな高さで切る |
よくある質問
Q. k-means法のkは誰が決めますか?
分析者(人間)が決めます。kはハイパーパラメータなので、エルボー法やシルエット分析を使って、データに合ったクラスタ数を探すのが一般的です。
Q. デンドログラムはどう読みますか?
下から見ると、近いデータやクラスタから順にまとまっていく様子が分かります。
つなぐ線の高さがクラスタ同士の距離を表すので、低い位置でつながっているものほど似ています。
好きな高さで横に線を引くと、その高さで分けたときのクラスタ数が分かります。
Q. クラスタリングと分類の違いは?
分類(分類問題)は、正解ラベルのあるデータで学習してカテゴリを当てる教師あり学習です。
クラスタリングは、正解ラベルなしで似たデータをまとめる教師なし学習で、できたグループの意味は人間が解釈します。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- クラスタリング:正解ラベルなしで、似たデータをグループ(クラスタ)にまとめる
- k-means法:kを人が決め、重心を動かしながらデータを分ける非階層的クラスタリング
- クラスタ数の決め方:エルボー法(グラフの肘)とシルエット分析(シルエットスコア)
- 階層的クラスタリング:近いものから順にまとめ、デンドログラム(樹形図)で表す
- クラスタ間の距離の測り方:最短距離法・最長距離法・群平均法・ウォード法(分散の増加量)
これで「教師なし学習」は終了です。
次回は、少しのラベル付きデータと大量のラベルなしデータで学ぶ「半教師あり学習」と、生成AIの事前学習で使われる「自己教師あり学習」を半教師あり学習の記事で解説していきます。覚える内容が多いですが、りけーこっとんも頑張ります!
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。