交差検証とは?ホールドアウト検証・誤差関数・正則化を解説
どーも、りけーこっとんです。
「ホールドアウト検証と交差検証、どう使い分けるの?」「L1正則化とL2正則化、どっちが重みを0にするんだっけ?」このような、G検定のモデル評価の仕上げで迷っている方はいないでしょうか?
この記事では、モデルの性能を正しく測るためのデータの分け方(ホールドアウト検証・交差検証)、汎化性能と過学習、誤差関数の種類、過学習を防ぐ正則化(L0・L1・L2)を解説します。
現行シラバスの「誤差関数」と「正則化」のキーワードも、この記事でまとめて押さえられます。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- ホールドアウト検証は、手元のデータを学習用とテスト用に1回だけ分けて評価する方法
- k-分割交差検証は、データをk個に分けて、テスト用を入れ替えながらk回評価し、平均を取る方法
- 誤差関数は、回帰なら平均二乗誤差関数、分類なら交差エントロピーが基本
- L1正則化は不要な重みを0にし(ラッソ回帰)、L2正則化は重みを全体的に小さくする(リッジ回帰)
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第3章「モデルの選択・評価」、第4章「誤差関数」「正則化」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
- 紙で手元に置きたい方は → G検定カンペの印刷用PDF(無料・A4・15ページ)をダウンロードできます
交差検証とは
モデルは、未知のデータをどれだけ精度よく予測できるかが重要でしたよね。ただ未知のデータは「未知」なので、モデルを作る時点では手元にありません。
そこで、手持ちのデータの一部を「未知のデータ」に見立てて、テストに使います。その分け方の代表が、ホールドアウト検証と交差検証です。
交差検証とは、手元のデータを複数のグループに分け、学習用とテスト用の役割を入れ替えながら何回も評価して、モデルの性能を測る方法です。
その中でも代表的なのが、次に解説するk-分割交差検証です。
教師あり学習の全体像(予測と正解のギャップを小さくする流れ)は教師あり学習の記事で解説しています。
ホールドアウト検証とk-分割交差検証の違い
ホールドアウト検証とは
ホールドアウト検証とは、手持ちのデータを「学習データ」と「テストデータ」に1回だけ分けて、学習データで作ったモデルをテストデータで評価する方法です。
手持ちのデータだけで、モデルの作成から評価まで行えるようになりますね。
例えば、データの8割で学習して、残りの2割でテストする、といった分け方をします。シンプルで計算も1回で済みますが、たまたまの分け方で結果が変わるのが弱点です。
k-分割交差検証とは
k-分割交差検証とは、データをk個に分け、そのうち1つをテストデータ、残りを学習データにして評価することを、k個すべてが1回ずつテストデータになるまで繰り返す方法です。
具体的な手順は次の通りです。
- データをk個に分ける
- そのうち1つをテストデータとする
- 残りを学習データとして学習する
- テストデータで誤差(目的関数)を計算する
- k個のデータ全てが1回ずつテストデータになるまで、2〜4を繰り返す
- k回の結果の平均値を、モデルの精度とする
イメージとしては次のような感じです。
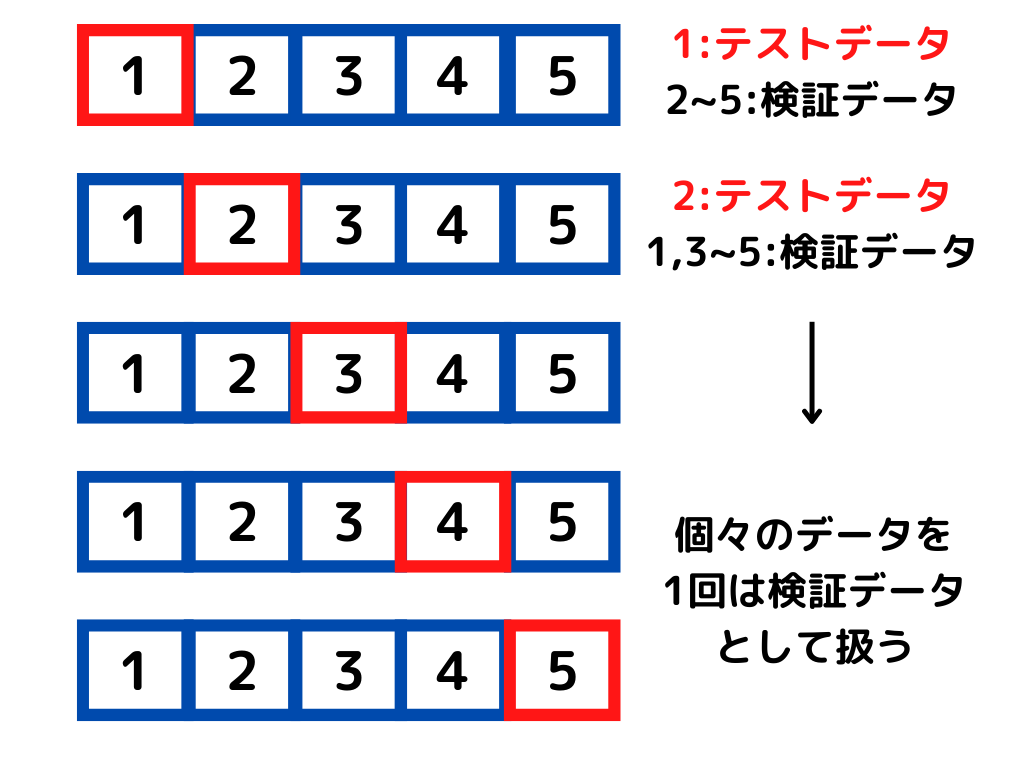
このように手持ちのデータを何個にも分けて検証を行うため、計算量はk倍になります。しかし、データ数がそもそも少ない場合は、ホールドアウト検証よりもk-分割交差検証のほうが良いでしょう。データが少ないと、1回の分け方だけでは評価が偏ってしまう可能性があるためです。
| 比べるところ | ホールドアウト検証 | k-分割交差検証 |
|---|---|---|
| データの分け方 | 学習用とテスト用に1回だけ分ける | k個に分けて、テスト用を入れ替える |
| 学習の回数 | 1回 | k回 |
| 長所 | 計算が速い | 分け方による偏りが少ない |
| 向いている場面 | データが大量にあるとき | データが少ないとき |
なお、ハイパーパラメータの調整にテストデータを使うと、テストデータに合わせ込んでしまいます。そこで、学習データの一部をさらに検証データとして分け、「学習データ・検証データ・テストデータ」の3つに分けるのが実務では一般的です。
汎化性能とは|訓練誤差と汎化誤差
汎化性能とは、学習に使っていない未知のデータに対して、どれだけ正しく予測できるかという性能のことです。
モデル作りの最終的な目標は、この汎化性能を高めることですね。この「誤差」は、どのデータに対するものかで呼び方が変わります。
- 訓練誤差:学習に使った訓練データに対して生じる誤差
- 汎化誤差:未知のデータに対して生じる誤差(テストデータで見積もる)
訓練誤差が大きいままだと、学習が足りません。しかし、訓練データに適応しすぎても汎化誤差が大きくなってしまうので、注意が必要です。
過学習と未学習
- 過学習:訓練データを学習しすぎて、未知のデータの予測精度が悪くなっている状態(訓練誤差は小さいのに、汎化誤差が大きい)
- 未学習:学習が少なすぎて、訓練データにさえ当てはまりが悪い状態(訓練誤差も汎化誤差も大きい)
イメージは次の図のような感じです。
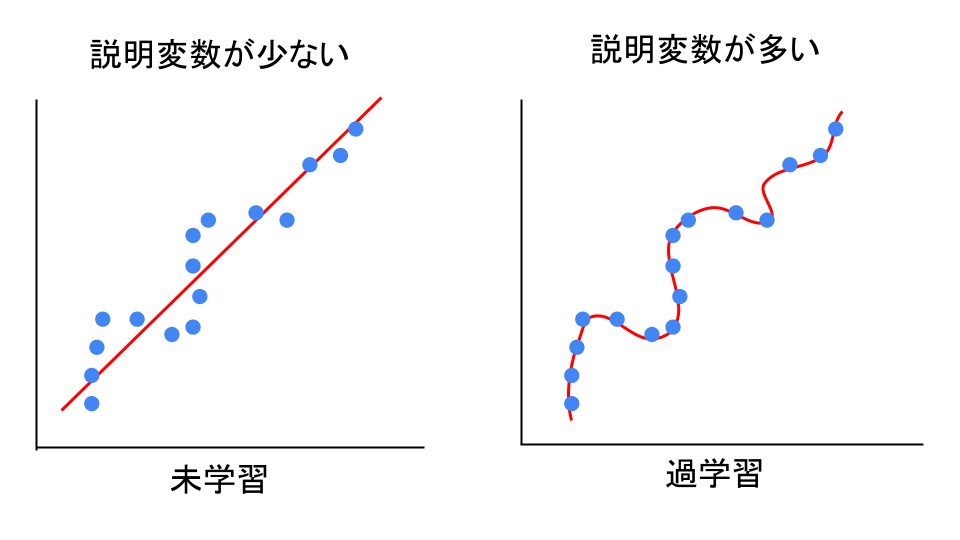
過学習も未学習も、未知のデータへの精度が悪いという点では同じです。
どちらも起こらないように学習することが、モデル作りにおいて重要ですね。
モデルを選ぶときの考え方(オッカムの剃刀・AIC)はAICとオッカムの剃刀の記事で解説しています。
ここまでの勉強で「やっぱり独学は難しい…」と思っているのであれば、実際に手を動かして学べる講座で一歩先に進むのも一つの手です。

誤差関数の種類
誤差関数とは、モデルの予測と正解のズレの大きさを数値で表す関数で、教師あり学習の目的関数・損失関数と同じ意味です。
この誤差関数を最小にすることが、教師あり学習の目的になります。誤差関数は、解く問題によって使い分けます。
平均二乗誤差関数
平均二乗誤差関数とは、予測値と正解の差を二乗して平均したもので、主に回帰問題で使う誤差関数です。
差をそのまま足すとプラスとマイナスで打ち消し合うので、二乗してから平均します。回帰問題の基本の誤差関数ですね。
評価指標としてのMSE・RMSE・MAEは評価指標の記事で解説しています。
交差エントロピー
交差エントロピーとは、モデルが出した確率の分布と、正解の分布がどれだけ違うかを表すもので、主に分類問題で使う誤差関数です。
正解のクラスに高い確率を付けていれば小さく、低い確率しか付けていなければ大きくなります。
分類問題の基本の誤差関数で、出力層のソフトマックス関数とセットで使われます。
カルバック・ライブラー情報量(KL)
カルバック・ライブラー情報量(KLダイバージェンス)とは、2つの確率分布がどれだけ違うかを表す量のことです。
同じ分布なら0になり、違うほど大きくなります。交差エントロピーと深い関係があり、画像を生成するVAE(変分オートエンコーダ)の学習などで使われます。
距離のようなものですが、AとBを入れ替えると値が変わる(対称ではない)点が特徴です。
Contrastive LossとTriplet Loss
この2つは、データ同士が「似ているか」を学ぶ距離学習で使う誤差関数です。顔認証のように「同じ人の写真か」を見分けたいときに使われます。
Contrastive Lossとは、2つのデータの組を使い、同じ種類なら距離が近く、違う種類なら一定以上遠くなるように学習するための誤差関数です。
Triplet Lossとは、基準のデータ・同じ種類のデータ・違う種類のデータの3つ組を使い、「同じ種類との距離」が「違う種類との距離」より小さくなるように学習するための誤差関数です。
| 誤差関数 | 主な用途 | ポイント |
|---|---|---|
| 平均二乗誤差関数 | 回帰問題 | 差を二乗して平均 |
| 交差エントロピー | 分類問題 | 確率の分布のズレ |
| カルバック・ライブラー情報量(KL) | 分布の違いを測る | 対称ではない・VAEで使う |
| Contrastive Loss | 距離学習 | 2つ組で学ぶ |
| Triplet Loss | 距離学習 | 3つ組で学ぶ |
正則化とは
正則化とは、誤差関数に正則化項(ペナルティ項)を追加して、モデルが複雑になりすぎないようにし、過学習を防ぐ方法です。
重み(パラメータ)が大きくなるほどペナルティが大きくなるようにすると、モデルは極端な重みを付けにくくなります。追加する正則化項の種類によって、次の3つに分かれます。
L0正則化・L1正則化・L2正則化の違い
L0正則化とは、0ではないパラメータの個数をペナルティとして加える正則化手法です。
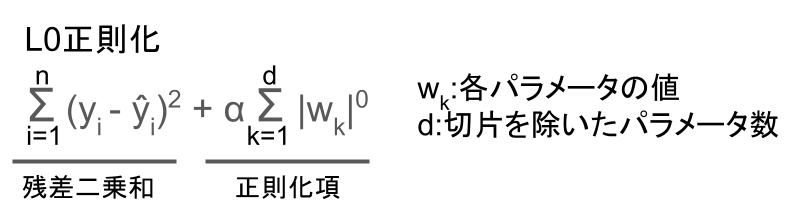
パラメータの大きさが0でない限り、その0乗は1になります。つまり「0ではない重みの個数」をα倍したものを加える、という意味ですね。
使う変数の数そのものを減らしたいときの考え方ですが、計算がとても難しいので、実際にはL1正則化で代用されることが多いです。
L1正則化とは、パラメータの絶対値の和をペナルティとして加える正則化手法です。代表的なものにラッソ回帰があります。具体的な式は次の通りです。
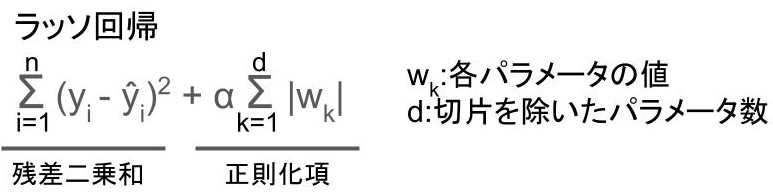
上の式を目的関数として、最小化するようにモデルを学習します。不要なパラメータをちょうど0にするので、特徴量の選択や次元の圧縮に有効です。
さらに、0の要素が非常に多い(スパースな)データに教師あり学習を適用したいときにも有効なようですね。
L2正則化とは、パラメータの二乗の和をペナルティとして加える正則化手法です。代表的なものにリッジ回帰があります。具体的な式は次の通りです。
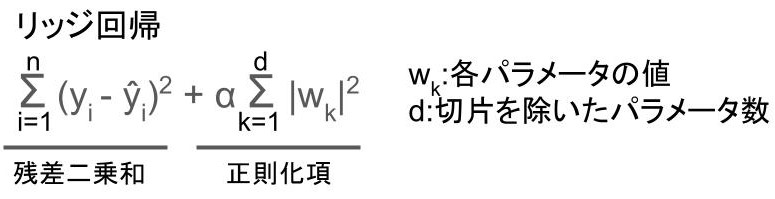
パラメータを大きさに応じて0に近づけます。ラッソ回帰と違って0にするのではなく0に近づけるので注意しましょう。
ディープラーニングでは荷重減衰(Weight Decay)とも呼ばれます。
| 正則化 | ペナルティ | 重みの変化 | 代表例 |
|---|---|---|---|
| L0正則化 | 0でない重みの個数 | 使う変数の数を減らす | ―(計算が難しい) |
| L1正則化 | 重みの絶対値の和 | 不要な重みがちょうど0になる | ラッソ回帰 |
| L2正則化 | 重みの二乗の和 | 重みが全体的に小さくなる | リッジ回帰 |
ラッソ回帰とリッジ回帰の使い分けはラッソ回帰・リッジ回帰の記事で解説しています。
学習率とモデルの解釈性
モデルの評価とあわせて押さえておきたい、ほかの章の用語も2つ簡単に触れておきます。
- 学習率:
最適化で、1回の学習でパラメータをどれだけ動かすかを決めるハイパーパラメータです。
大きすぎると最適化が終わらず、小さすぎると時間がかかります。
詳しくは最適化手法の記事で解説しています - LIMEとSHAP:
ディープラーニングのような中身が複雑なモデル(ブラックボックスモデル)が、どの特徴量を根拠に予測したかを説明する技術です。
LIMEは予測の周りを単純な線形モデルで近似し、SHAPはゲーム理論のシャープレイ値で各特徴量の貢献度を計算します。
詳しくは説明可能AIの記事で解説しています
G検定での問われ方|誤差関数と正則化の早見表
現行シラバスの「誤差関数」と「正則化」のキーワードを一言でまとめておきます。
| 用語 | 一言でいうと | 詳しい解説 |
|---|---|---|
| Contrastive Loss | 2つのデータの組について、似たペアは近く、違うペアは遠くなるよう学ぶ距離学習の誤差関数 | この記事 |
| Triplet Loss | 基準・似たデータ・違うデータの3つ組で、似たものを近く違うものを遠くする距離学習の誤差関数 | この記事 |
| カルバック・ライブラー情報量(KL) | 2つの確率分布の違いを測る指標(KLダイバージェンス)。VAEなどで使う | この記事 |
| 交差エントロピー | 予測した確率分布と正解の分布のずれを測る誤差関数。分類問題でよく使う | この記事 |
| 平均二乗誤差関数 | 予測と正解の差の2乗の平均を誤差とする関数。回帰問題でよく使う | この記事 |
| L0正則化 | 0でない重みの個数をペナルティにする正則化 | この記事 |
| L1正則化 | 重みの絶対値の和をペナルティにする正則化。不要な重みがちょうど0になりやすい | この記事 |
| L2正則化 | 重みの2乗の和をペナルティにする正則化。重みが全体的に小さくなる(荷重減衰) | この記事 |
| 正則化 | モデルが複雑になりすぎないようペナルティを加え、過学習を防ぐこと | この記事 |
| ドロップアウト | 学習中にランダムにニューロンを無効化して過学習を防ぐ。アンサンブル学習に近い効果 | 解説記事 |
| ラッソ回帰 | L1正則化を加えた線形回帰。不要な変数の係数が0になる(変数選択) | 解説記事 |
| リッジ回帰 | L2正則化を加えた線形回帰。係数を全体的に小さくして過学習を防ぐ | 解説記事 |
よくある質問
Q. 交差検証のkはいくつにすればいい?
5や10がよく使われます。
kを大きくすると1回あたりの学習データが増えて評価が安定しますが、学習の回数も増えて計算に時間がかかります。
データ数と計算時間のバランスで決めます。
Q. 回帰と分類で使う誤差関数の違いは?
回帰問題では、予測値と正解の差を二乗して平均する平均二乗誤差関数を使います。
分類問題では、予測した確率の分布と正解の分布のズレを表す交差エントロピーを使います。
Q. L1とL2、変数選択ができるのはどちら?
L1正則化です。L1正則化(ラッソ回帰)は不要な特徴量の重みをちょうど0にするので、使う変数を自動で選べます。
L2正則化(リッジ回帰)は重みを小さくするだけで、0にはしません。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- ホールドアウト検証は1回だけ分けて評価、k-分割交差検証はテスト用を入れ替えてk回評価し平均を取る
- 汎化性能は未知のデータへの予測性能。訓練誤差は小さいのに汎化誤差が大きいのが過学習
- 誤差関数は、回帰なら平均二乗誤差関数、分類なら交差エントロピーが基本
- KLは分布の違い、Contrastive LossとTriplet Lossは距離学習で使う
- 正則化:L0は個数、L1は絶対値の和(重みが0に)、L2は二乗の和(重みが小さく)
今回でモデルの評価が終わり、「機械学習の概要」の章がようやく終了です。次回からは「ディープラーニングの概要」に入り、まずはニューラルネットワークの学習の仕組み「誤差逆伝播法」を誤差逆伝播法の記事で解説していきます。
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
お子さんと一緒にAIを学びたい方には、親子で生成AIの使い方を学べる講座もあります。

G検定の勉強で身につけた知識は、データ分析やAI関連の仕事でそのまま使う土台になります。データ系の求人は職種名がバラバラで自分では探しにくいので、どんな求人があるのかを一度眺めておくと、次に学ぶべきことがはっきりしてきます。


20代で未経験からIT職を目指す方、すでに経験があってフリーランスの案件を探したい方は、それぞれ専門のサービスを使うと探す手間が省けます。