中国語の部屋とは?ローブナーコンテスト・機械翻訳の歴史も解説
どーも、りけーこっとんです。
「中国語の部屋って、結局なにが言いたいの?」「機械翻訳の方式、どれが古くてどれが新しいのか分からない」
このような、G検定の「AIの限界」や「機械翻訳」の問題で迷っている方はいないでしょうか?
この記事では、ハノイの塔、モンテカルロ法、ローブナーコンテスト、中国語の部屋、機械翻訳の3つの方式、特徴表現学習を解説します。
どれもG検定で用語の意味をそのまま問われやすいところなので、例え話と表で一気に整理していきましょう。
(2026年10月更新:G検定の現行シラバス(2024年第6回から適用)に合わせて内容を見直しました。)
この記事の要点
- 中国語の部屋は、1980年にジョン・サールが発表した「強いAI」を批判する思考実験
- ローブナーコンテストは、チューリングテストで最も人間らしいAIを競う大会
- ハノイの塔は、円盤が増えると手数が指数関数的に増える問題の代表例
- 機械翻訳はルールベース→統計的→ニューラル機械翻訳の順に発展した
手元に公式テキストが1冊あると、この記事で扱う用語をシラバスの言葉づかいのまま確かめられます。
深層学習教科書 ディープラーニング G検定(ジェネラリスト)公式テキスト 第3版
JDLA(日本ディープラーニング協会)監修の公式テキスト。用語の意味を正確に確かめたいときの辞書がわりになります。
|
|


この記事は、現行シラバスでは第1章「人工知能分野で議論される問題」、第2章「探索・推論」、第6章「自然言語処理」の範囲です(シラバスはJDLAの公式ページで確認できます)。G検定の範囲全体を一覧で見たい方はG検定チートシートもどうぞ。
この記事では、文字の装飾を次の3段階にそろえています。試験直前は赤太字だけ拾い読みしても要点がつかめます。
- 赤太字(超重要):試験で正解を決める決め手。年号・人物・数字・違いのポイント
- 青色マーカー+太字(重要):用語の定義。「〇〇とは」の一文
- 太字(覚えておきたい):あわせて覚えたい関連用語や覚え方
- これから勉強を始める方は → G検定とは?合格ライン・難易度・勉強法で、まず試験の全体像と勉強の進め方をつかめます
- 用語をサッと確かめたい方・試験当日が近い方は → G検定カンペ(チートシート)の分野別の用語一覧から、各解説記事にすぐ飛べます
中国語の部屋とは|「理解していない」AIを見抜く思考実験
中国語の部屋とは、記号を操作して正しく答えられても、意味を理解しているとは限らないことを示す思考実験です。
1980年に、アメリカの哲学者ジョン・サールが発表しました。
具体的には、次のような問題です。
- 中国語が分からない人を小部屋に閉じ込め、小さな穴から紙だけやりとりできるようにする
- 外から中国人が中国語で質問を紙に書いて入れる
- 中の人はマニュアルに従って、答えを探して返す(中国語は理解していない)
- 外の人は正しい答えが返ってくるので「中の人は中国語を理解している」と思ってしまう
つまり中の人はマニュアルに従って答えているだけなのに、外の人は「中国語を理解している」と感じるんですね。
これがAIの問題とどう関係するの?と思った方。AIの中で行われていることは何だったでしょうか。
ひたすら計算を繰り返しているプログラムなんです。
なのでAIはマニュアルに従っているだけとも言えますよね。
「AIは人の言葉を理解している」と思ってしまう、と考えると身近に思える人もいるのではないでしょうか。
この思考実験は、強いAIへの批判として書かれたもので、チューリングテストに合格するように振る舞えても、本当に理解しているとは言えない、という主張につながります。
強いAI・弱いAIの分け方は強いAIと弱いAIの記事、チューリングテストはフレーム問題・チューリングテストの記事で解説しています。
ローブナーコンテストとは
ローブナーコンテストとは、チューリングテストの方式で、最も人間らしい会話ができるAIを競うコンテストのことです。
1991年から、ヒュー・ローブナーの出資で開かれてきました。
どうやって競い合うのかと言えば、チューリングテストです。
審査員がテキストで会話し、「人間が、どれくらいAIと区別できたか」を判定します。
毎年、最も人間らしかったAIには賞(銅賞)が贈られますが、音声や映像も含めて人間と区別できないAIに贈られる金賞は一度も授与されていないようですね。
トイ・プロブレムとハノイの塔
トイ・プロブレムとは、迷路やパズルのように、ルールとゴールがはっきり決まった簡単な問題のことです。
計算量や使用メモリが少ない問題ですね。第1次AIブームのAIはこうした問題は解けましたが、現実の複雑な問題は解けませんでした。
ハノイの塔とは
ハノイの塔とは、杭と円盤を使った簡単なパズル問題のことです。
トイ・プロブレムの代表例ですね。詳細は次の通りです。
- 3本の杭と、中央に穴の空いた円盤がある。同じ大きさの円盤はない
- 始めは左の杭に、上から小さい順に円盤が重なっている
- 円盤を動かせるのは一度に1つで、小さい円盤の上に大きな円盤は置けない
- 全ての円盤を右の杭に、最小の手数で移動するには?という問題
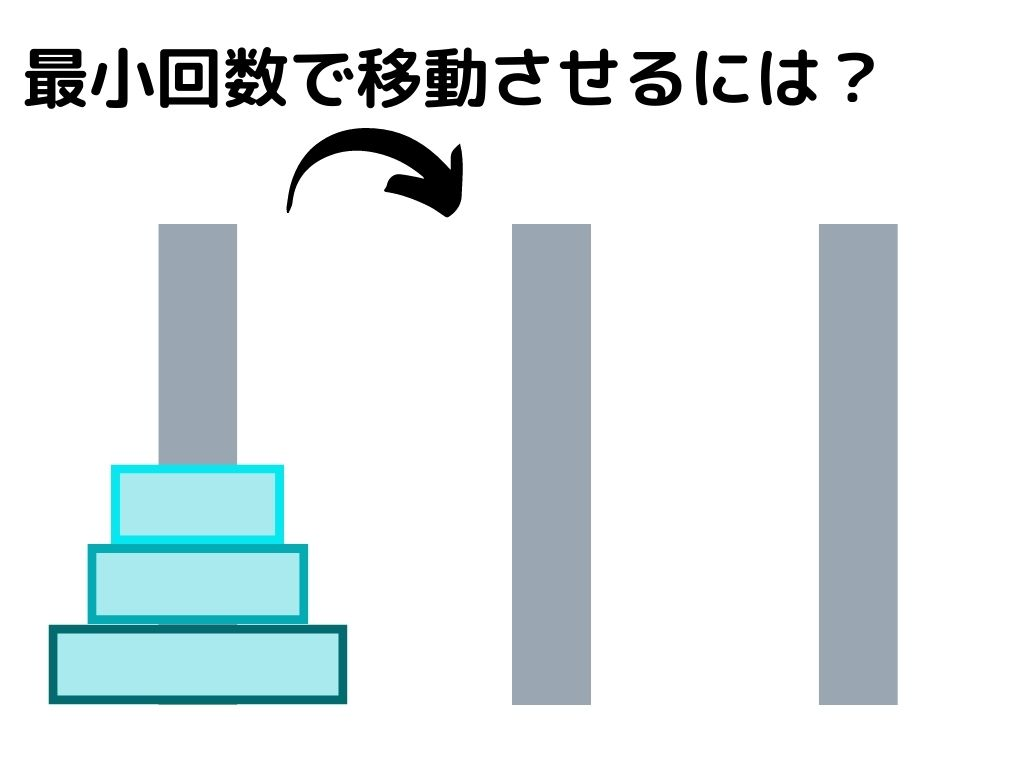
この問題、構造自体は簡単ですが、円盤の枚数が増えるごとに指数関数的に手数が増えてしまいます。
円盤がn枚なら最小手数は2のn乗−1回で、10枚なら1,023回、20枚なら100万回を超えます。直線的な変化ではなく、指数的な変化の問題の代表例として、よく挙がるようですね。
モンテカルロ法とは
モンテカルロ法とは、ボードゲームにおいて最善手を評価するための方法の1つで、ランダムに何回もプレイして勝率を調べる手法です。
次の一手を決めるときに、打てる手それぞれについて、そこから先を最後までランダムに打ち合うプレイアウトを何回も行います。
その中で一番勝率が高かった手を選ぶ手法のことですね。
盤面の「良し悪し」を人間が数値で決めなくてよいのが強みで、囲碁のように盤面の評価が難しいゲームでAIを強くするために使われてきました。
囲碁AIのAlphaGoも、この考え方を発展させたモンテカルロ木探索を使っています。
詳しくはAlphaGoの記事で解説しています。
AIはもう大人だけのものではありません。お子さんと一緒に、生成AIの正しい使い方から学べる講座もあります。


機械翻訳の歴史|ルールベース→統計的→ニューラル
機械翻訳とは、違う言語の翻訳を機械が行ってくれることです。
Google翻訳などがあるので、イメージしやすいかと思います。
機械翻訳には方式が数種類あり、歴史の中でだんだん高性能なやり方が開発されていきました。古い順に並べると次の3つです。
- ルールベース機械翻訳
- 統計的機械翻訳
- ニューラル機械翻訳
一つずつ見ていきましょう。
ルールベース機械翻訳
ルールベース機械翻訳とは、各言語の「文法」と辞書を人手で入力して、変換する手法です。
1954年のジョージタウン大学とIBMの実験から始まり、1970年代ごろまで研究の中心でした。
文法を人手で入力していくので、単純に時間がかかりますし、大変です。言い回しの例外にも弱かったんですね。
統計的機械翻訳
統計的機械翻訳とは、ある言語とその対訳を大量に学習させて、確率的に訳を選ぶ手法です。
統計学的機械翻訳とも呼ばれます。1990年代にIBMが提唱し始めたやり方です。
統計学を用いて、原文と訳文の組み合わせ(対訳コーパス)を機械に学習させていたようですね。コーパスについてはパーセプトロンとコーパスの記事で解説しています。
ニューラル機械翻訳
ニューラル機械翻訳とは、ニューラルネットワークを用いている機械翻訳のことです。名前の通りですね。
対訳データから学ぶ点は統計的機械翻訳と同じですが、ニューラルネットワークを用いたことで、飛躍的に精度が向上しました。
2016年にGoogle翻訳がニューラル機械翻訳に切り替わり、訳文が一気に自然になったことで話題になりました。これが現在最も使われている手法です。
| 方式 | 時期 | 仕組み | 弱点 |
|---|---|---|---|
| ルールベース機械翻訳 | 1950〜1970年代が中心 | 人が文法ルールと辞書を書く | ルール作りが大変、例外に弱い |
| 統計的機械翻訳 | 1990年代〜 | 対訳コーパスから確率で訳す | 文全体の自然さが出にくい |
| ニューラル機械翻訳 | 2010年代〜 | ニューラルネットワークで文全体を訳す | 大量のデータと計算が必要 |
今のニューラル機械翻訳の土台になっているTransformerはBERTとTransformerの記事で解説しています。
特徴表現学習とは
特徴表現学習とは、特徴量の加工・抽出まで学習器が行うことです。ディープラーニングがこれに当たりますね。
特徴量の加工・抽出は、分析者にとって非常に大変な作業です。
りけーこっとんも実務でデータを扱うときは、ここに一番時間をかけています。
これを学習器が行うとなると、スピードも精度も上がりますよね。
画像認識や自然言語処理で、ディープラーニングが一気に強くなった理由がここにあります。
特徴量そのものについては特徴量と次元の呪いの記事で解説しています。
G検定での問われ方
この記事の用語は、「何のための問題・手法か」と「年代の順番」がよく問われます。
| 用語 | 一言でいうと | 覚えるポイント |
|---|---|---|
| 中国語の部屋 | 記号操作だけでは理解していない | ジョン・サール・1980年・強いAI批判 |
| ローブナーコンテスト | チューリングテストで人間らしさを競う大会 | 1991年〜・金賞は授与なし |
| トイ・プロブレム | ルールとゴールが決まった簡単な問題 | 第1次AIブームの限界 |
| ハノイの塔 | 円盤を移す簡単なパズル | 手数が指数関数的に増える |
| モンテカルロ法 | ランダムなプレイアウトで勝率を調べる | 囲碁AI・モンテカルロ木探索 |
| ルールベース機械翻訳 | 人が文法ルールを書いて訳す | 最も古い方式 |
| 統計的機械翻訳 | 対訳コーパスから確率で訳す | 1990年代・IBM |
| ニューラル機械翻訳 | ニューラルネットワークで訳す | 2016年にGoogle翻訳が採用 |
| 特徴表現学習 | 特徴量の抽出まで機械が学習する | ディープラーニング |
よくある質問
Q. 中国語の部屋は誰が何年に提唱しましたか?
アメリカの哲学者ジョン・サールが1980年に発表しました。人間のように振る舞えても意味を理解しているとは限らない、という「強いAI」への批判です。
Q. 中国語の部屋とチューリングテストの関係は?
チューリングテストは外から見た振る舞いで知能を判定しますが、中国語の部屋は「振る舞いが正しくても理解しているとは限らない」と指摘しました。
チューリングテストで知能を測ることへの反論として位置づけられます。
Q. ニューラル機械翻訳はいつから主流になりましたか?
2010年代半ばからです。特に2016年にGoogle翻訳がニューラル機械翻訳に切り替わったことで、一気に広まりました。
よくある質問の内容までスラスラ答えられたら、次は問題形式で解いてみるのがおすすめです。選択肢を見比べると、どこで引っかけられるのかが分かってきます。
徹底攻略ディープラーニングG検定ジェネラリスト問題集 第3版
分野ごとの問題と解説がまとまった問題集。記事で覚えた用語を、本番と同じ選択式で解いて確かめられます。
|
|

まとめ
- 中国語の部屋:記号操作だけでは理解していないことを示す思考実験(ジョン・サール、1980年)
- ローブナーコンテスト:チューリングテストで最も人間らしいAIを競う大会
- ハノイの塔:円盤が増えると手数が指数関数的に増えるトイ・プロブレム
- モンテカルロ法:ランダムなプレイアウトをくり返して勝率の高い手を選ぶ
- 機械翻訳:ルールベース→統計的→ニューラル機械翻訳の順に発展
- 特徴表現学習:特徴量の加工・抽出まで学習器が行う
次からは、第1次AIブームの中心だった「探索」を幅優先探索と深さ優先探索の記事で解説していきます。覚える内容が多いですが、りけーこっとんも頑張ります!
G検定の試験範囲をまとめて見直したい方は、シラバスの全キーワードを一行でまとめたG検定チートシートをどうぞ。分野ごとに読み進めたい方はG検定の解説記事一覧からどうぞ。
G検定に合格したあと、その資格をどう使うかまで考えておくと勉強のモチベーションが続きます。AI・データ系の求人では、こうした基礎知識を持っていることが評価される場面も増えています。どんな求人があるのか眺めておくだけでも、学ぶ内容の優先順位が見えてきますよ。


20代で未経験からIT職を目指す方は、若手向けの就職・転職サービスを使うと、書類作成から面接まで相談できます。